
Qwen-Image 2.1 reemplaza a FLUX en mis portadas: 7 veces más rápido en la misma tarjeta de 16 GB, y lo que pierdo
Pasé los mismos prompts y las mismas seeds por el FLUX que genera mis portadas y por Qwen-Image-2.1-Turbo cuantizado a NF4, en la misma tarjeta de 16 GB. Qwen tarda 8,4 s por imagen contra 61 s, escribe exacto 13 de 18 textos contra 7 y dibuja la escena pedida en 11 de 15 portadas contra ninguna. Pierdo la atmósfera de la LoRA, y la versión que cabe en 16 GB escribe 4 textos menos que Qwen sin cuantizar.
Las portadas de este blog salen de FLUX.1-dev con una LoRA de pixel art, en una RTX 4070 Ti SUPER de 16 GB. Cada imagen tarda un minuto, el texto suele salir mal escrito y los conteos no se respetan. Probé si Qwen-Image-2.1-Turbo puede reemplazarlo en la misma tarjeta. Abajo va todo con el mismo prompt y la misma seed a cada lado.
El paso de portada, hoy y con Qwen
Texto dentro de la imagen
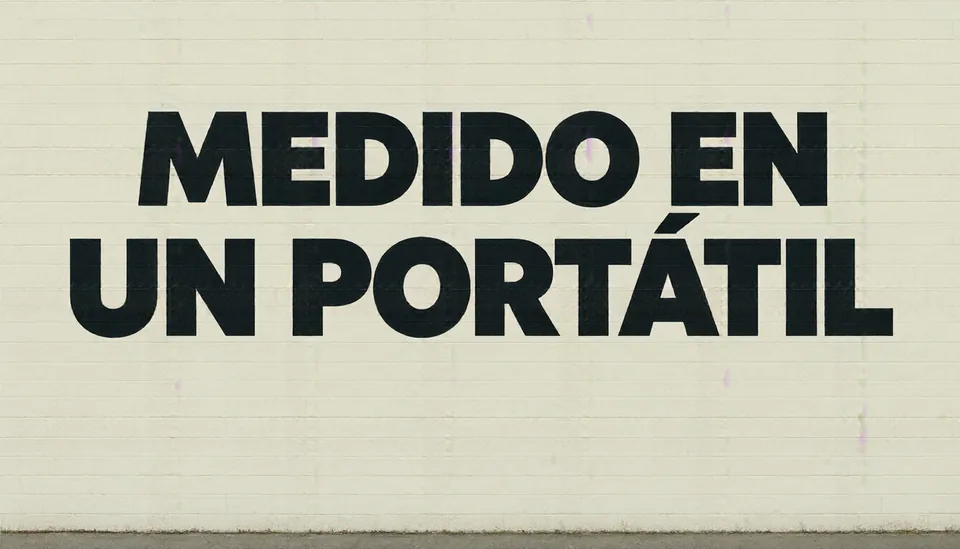
Seis prompts con un texto exacto, tres seeds cada uno. Los textos van en español a propósito: las tildes y la coma decimal son donde los modelos tropiezan. Revisé cada imagen a tamaño completo: ✓ si cada carácter salió como se pidió, ≈ si solo falla un espacio o una palabra partida, ✗ si hay un carácter equivocado, de más o de menos. Una coma decimal cambiada por punto o una tilde que falta cuentan como ✗. Que el texto salte de línea entre palabras no cuenta, y el texto que el prompt no pidió tampoco.
Se pidió MEDIDO EN UN PORTÁTIL
Prompt completo
A minimalist concert poster on a brick wall, bold sans-serif headline reading "MEDIDO EN UN PORTÁTIL", flat colors, soft daylight
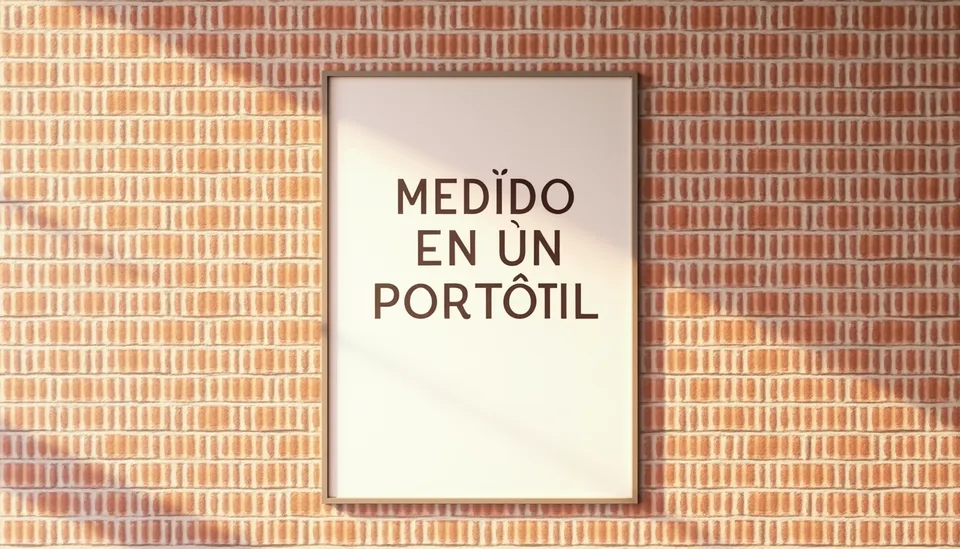
✗ «MEDĬDO EN ÙN PORTÔTIL»
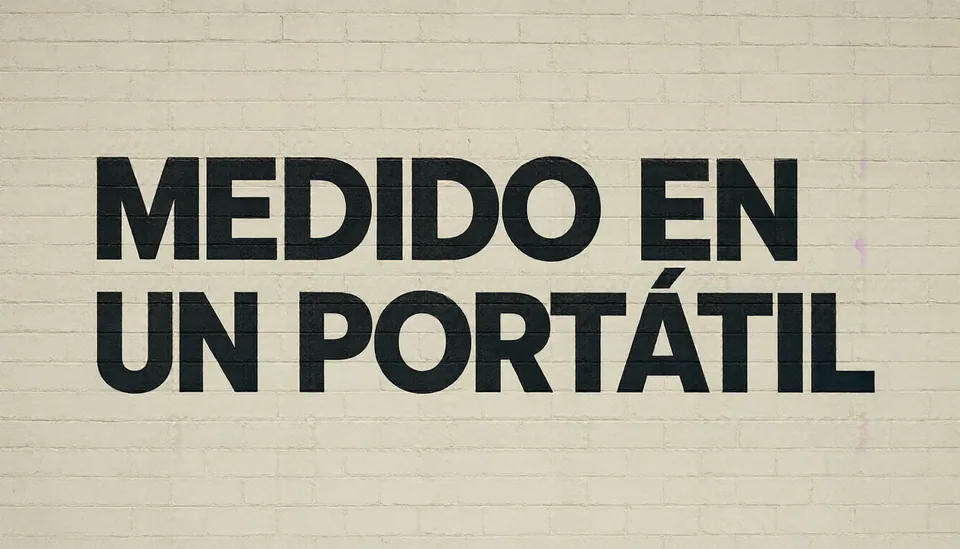
✓ Sin afiche: el texto va pintado en la pared
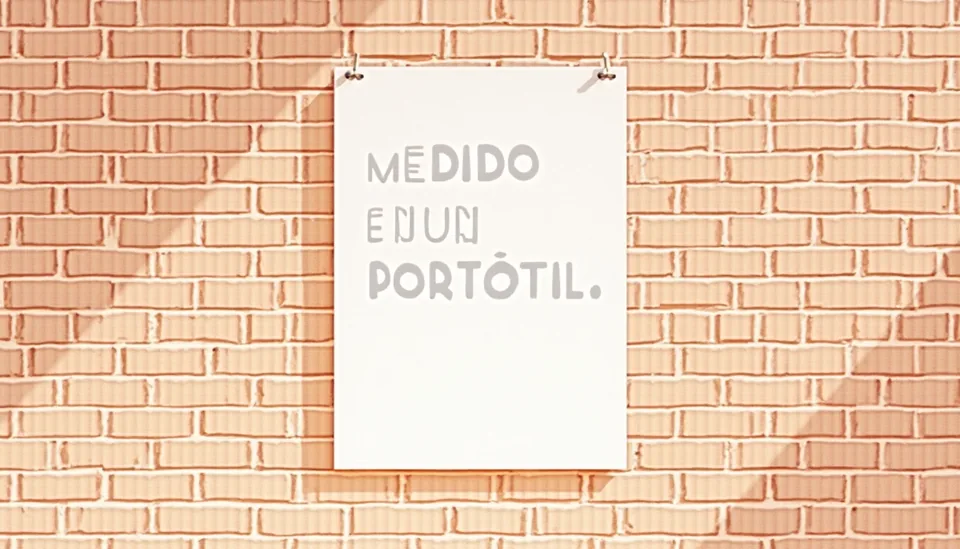
✗ «PORTÓTIL»
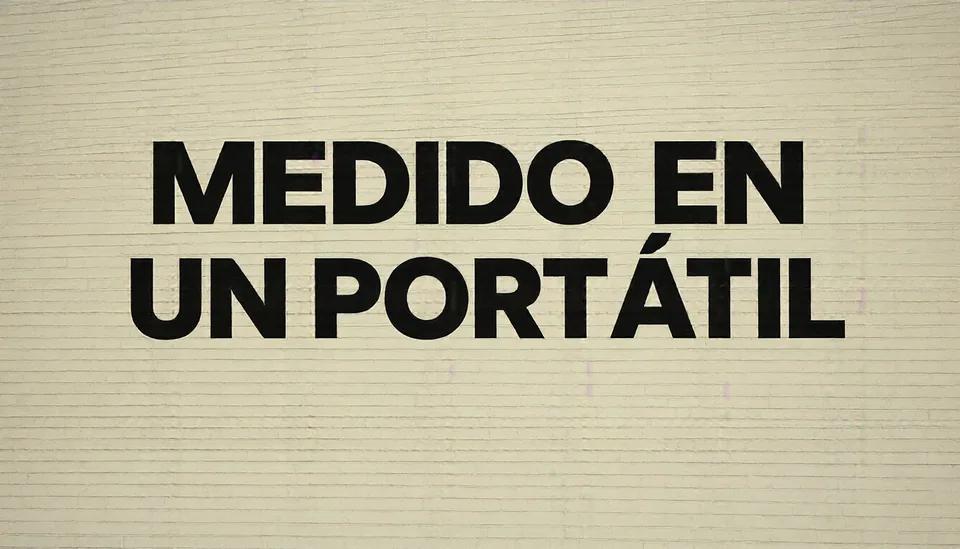
✓ Sin afiche: el texto va pintado en la pared
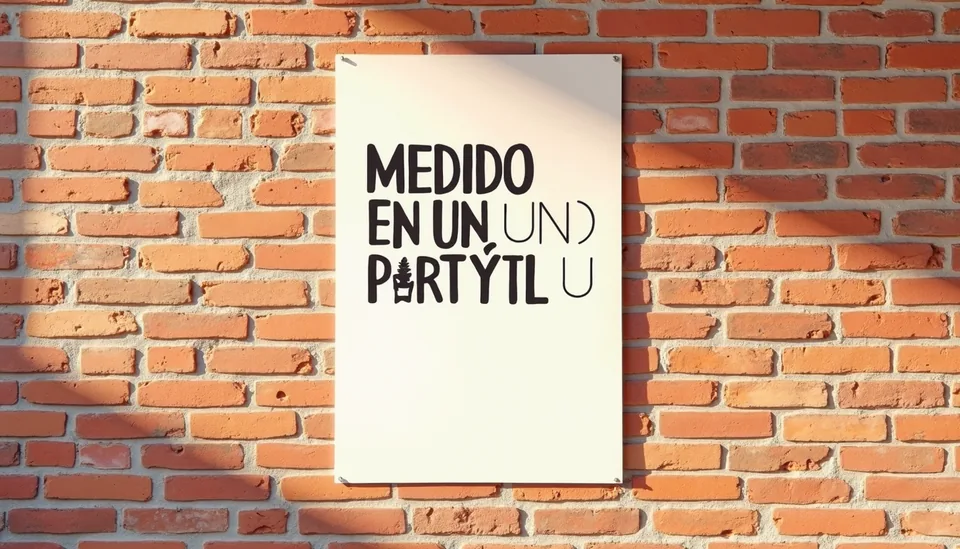
✗ «PARTÝTL»
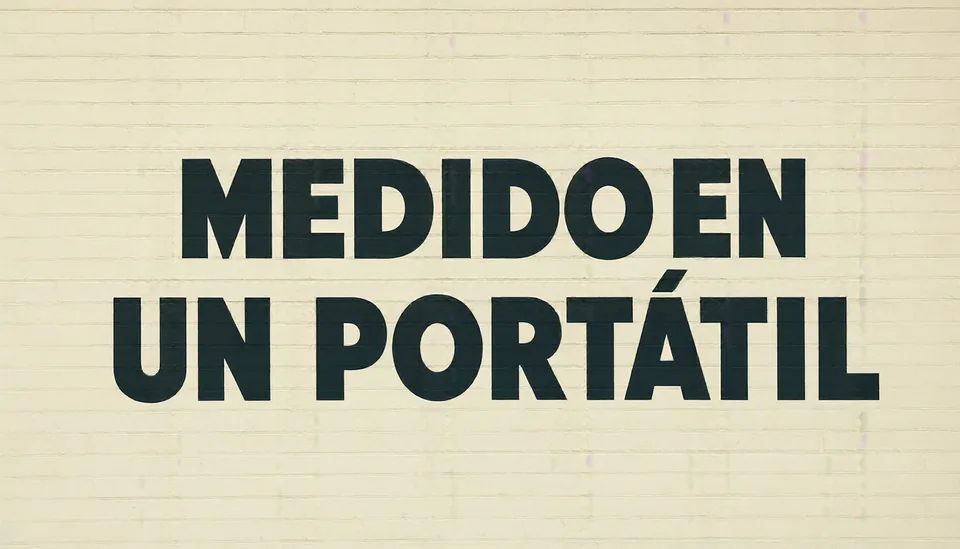
✓ Sin afiche: el texto va pintado en la pared
Se pidió 18 a 21 % más rápido
Prompt completo
A green school chalkboard with neat white chalk handwriting that reads "18 a 21 % más rápido", a piece of chalk on the ledge, classroom light
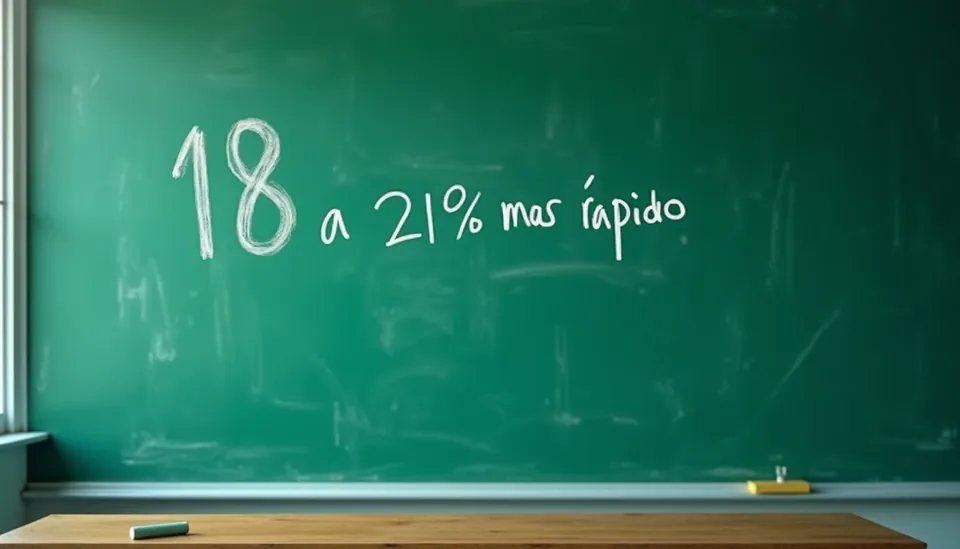
✗ «21% mas ŕapido»
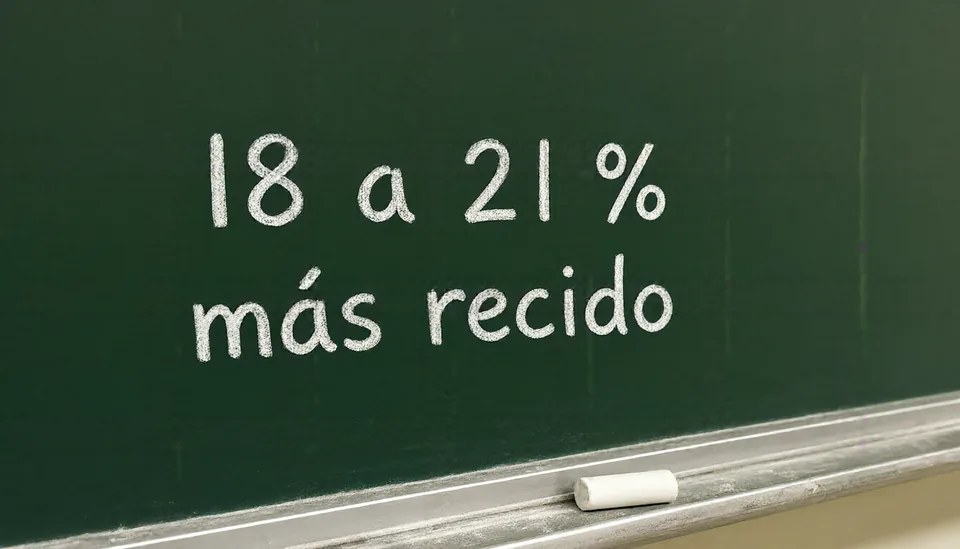
✗ «más recido»
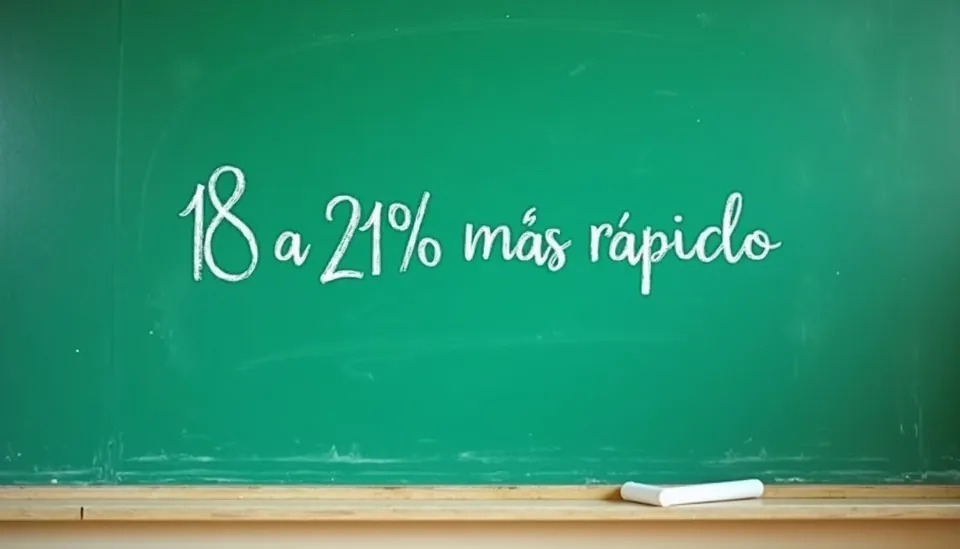
≈ «21%» sin espacio
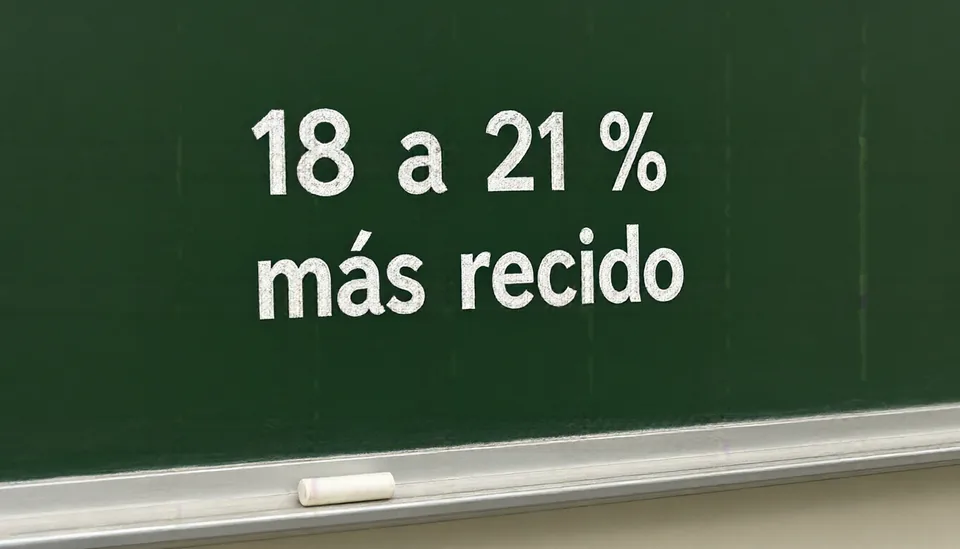
✗ «más recido»
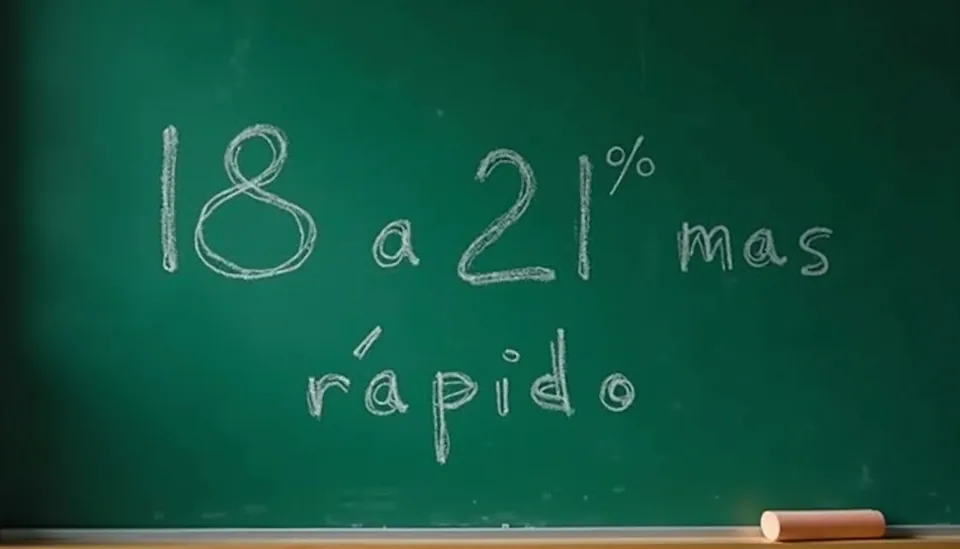
✗ «mas»
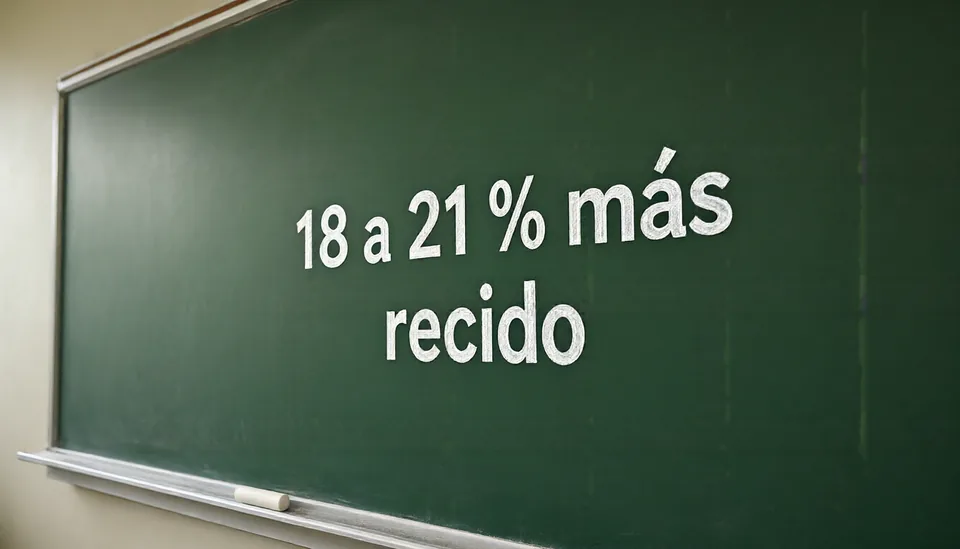
✗ «recido»
Se pidió efraingaray.com
Prompt completo
A pink neon sign glowing on a dark tiled wall at night, the sign spells "efraingaray.com", reflections on wet floor
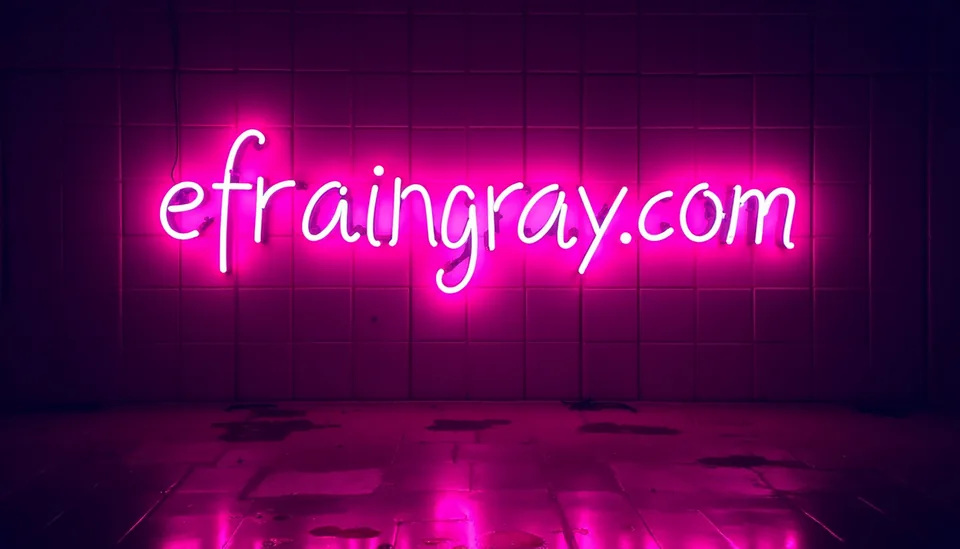
✗ «efraingray»
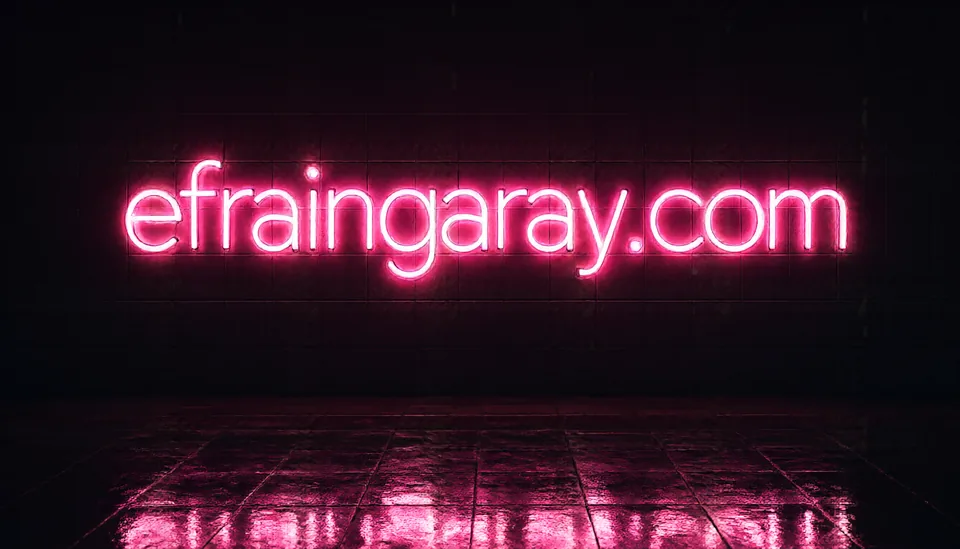
✓ como se pidió
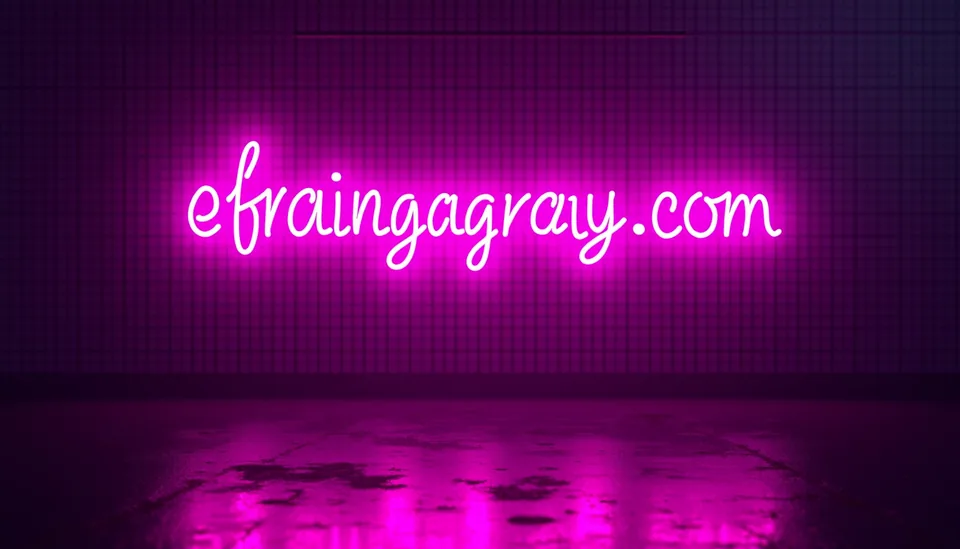
✗ «efraingagray»
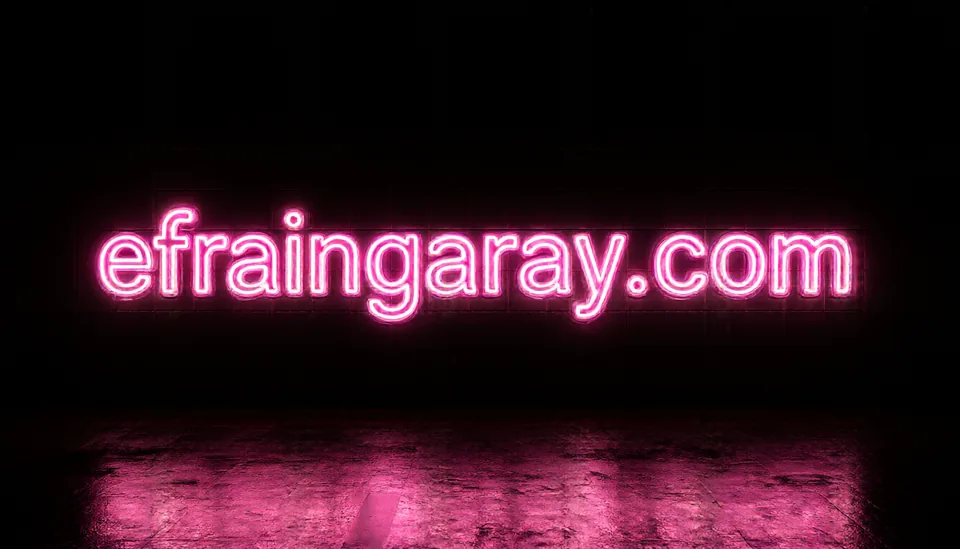
✓ como se pidió
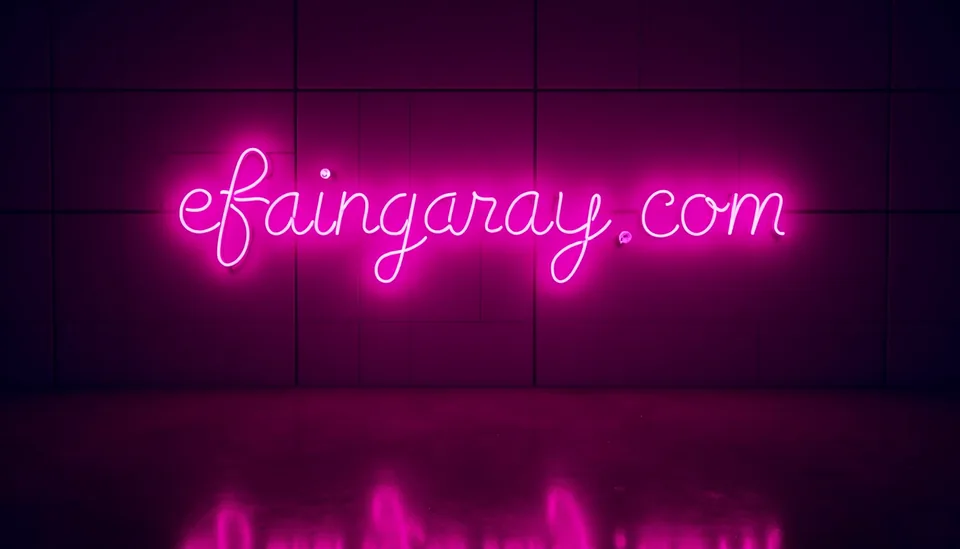
✗ «efaingaray»
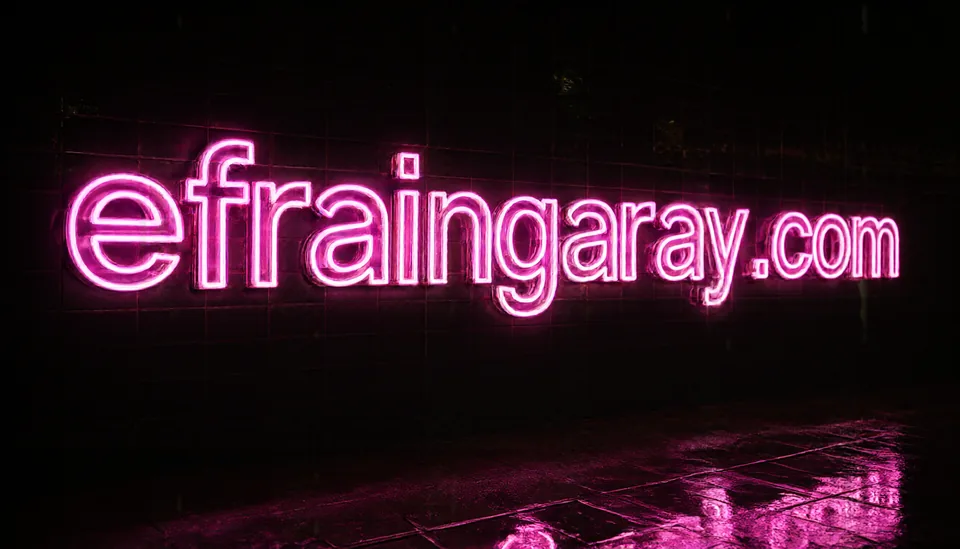
✓ como se pidió
Se pidió Ocho modelos de decisión
Prompt completo
A hardcover book lying on a wooden desk, the cover title printed in large serif letters reads "Ocho modelos de decisión", warm lamp light
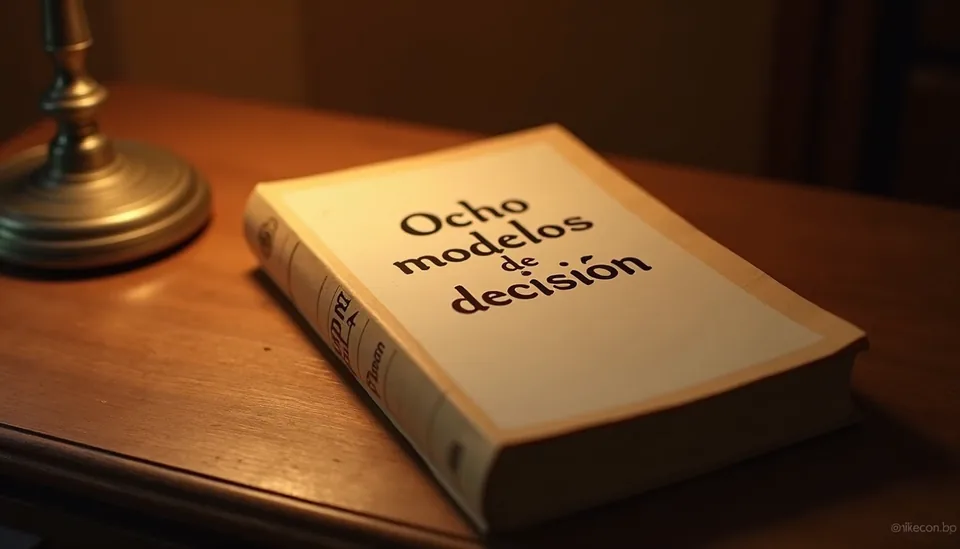
✓ Agrega una marca de agua
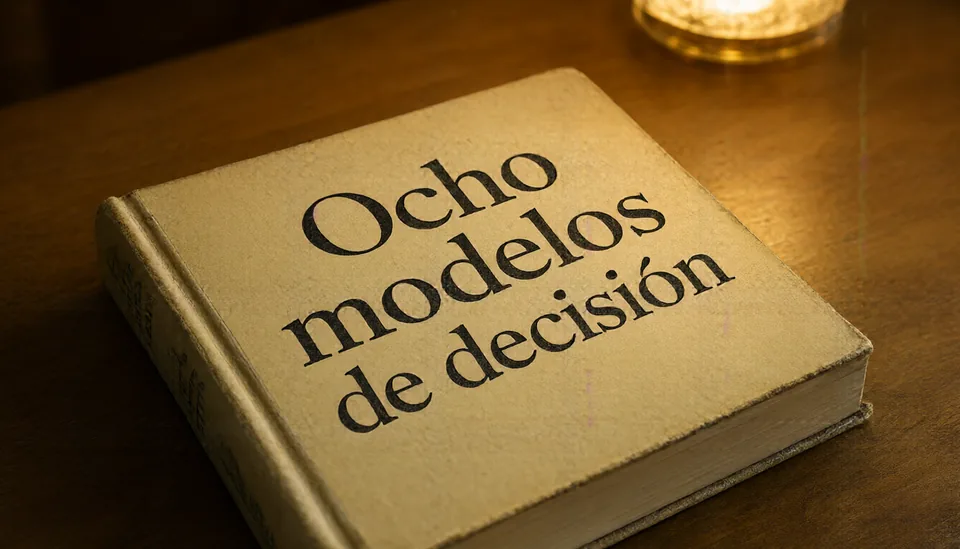
✓ como se pidió
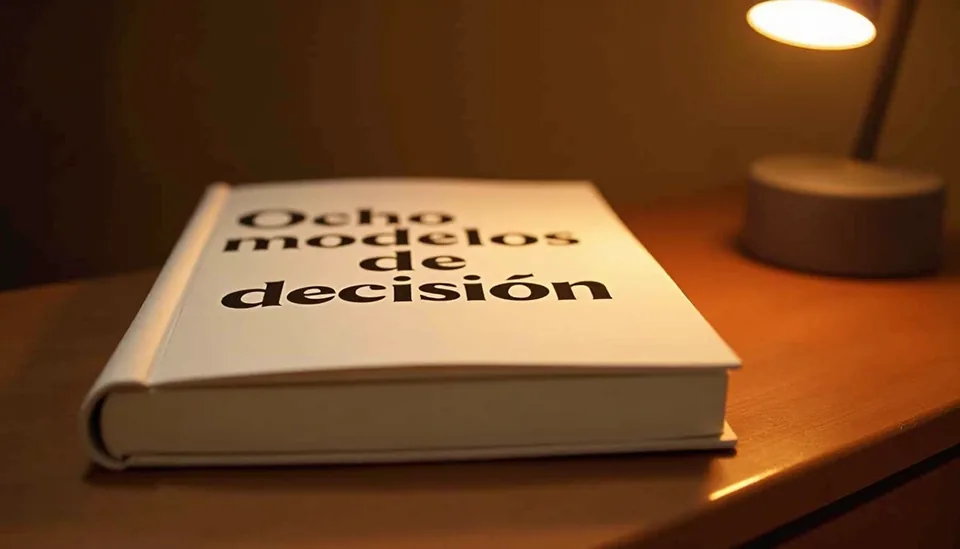
✓ como se pidió
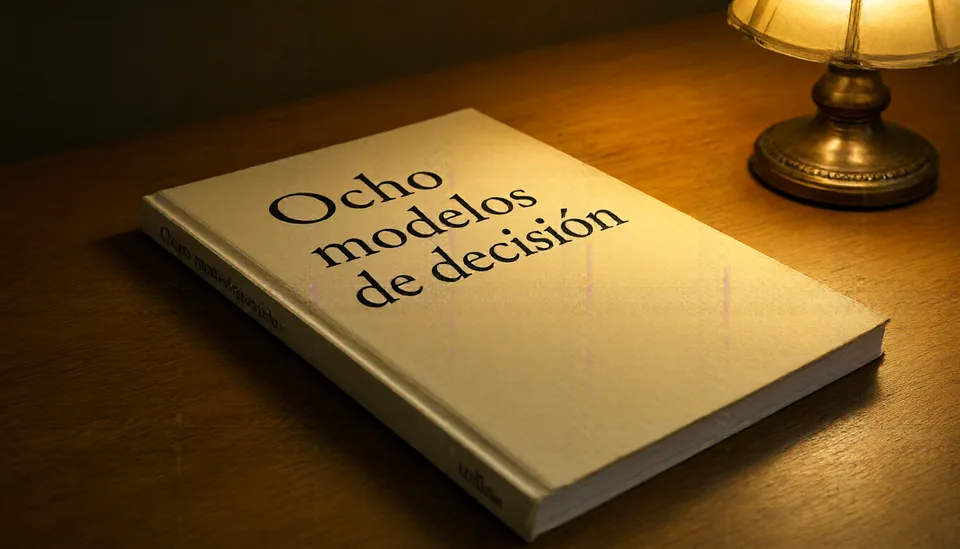
✓ Rayas moradas verticales
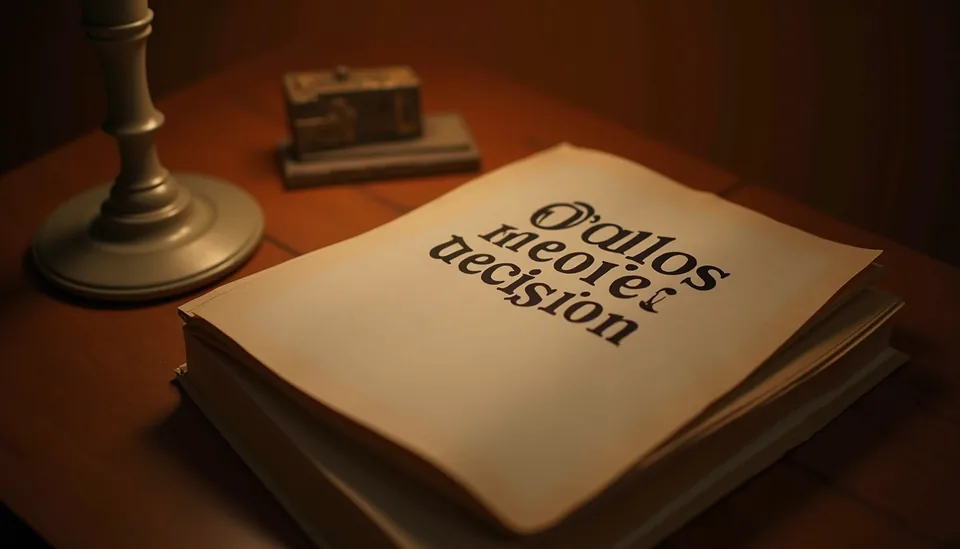
✗ «Ocallos meoret uecision»
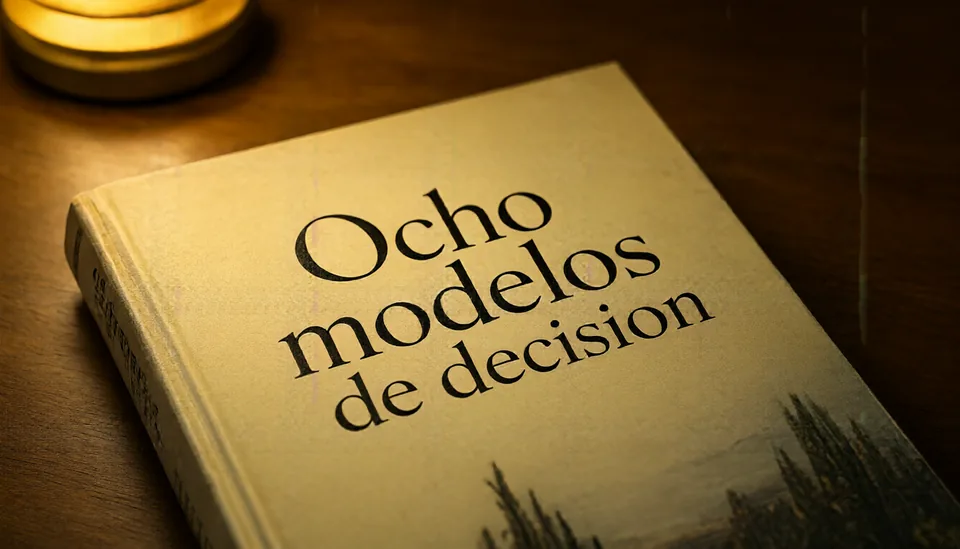
✗ «decision»
Se pidió AUC 0,966
Prompt completo
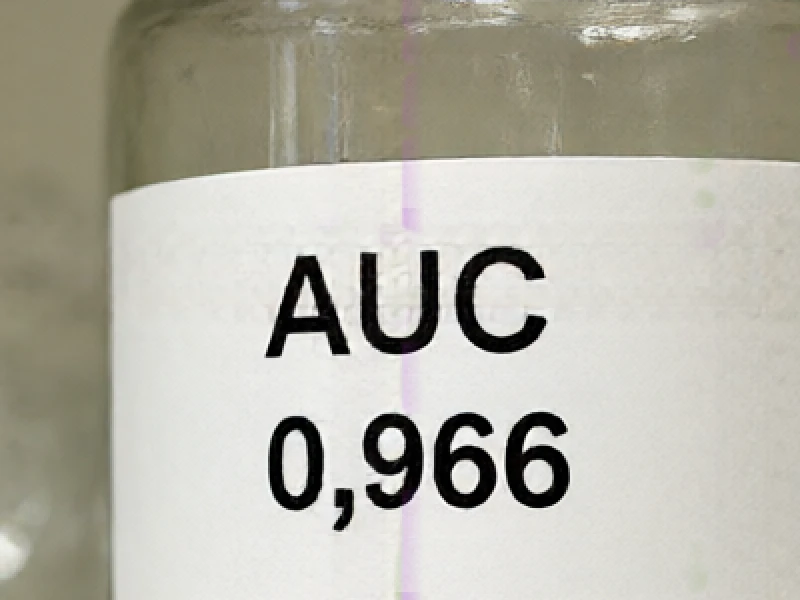
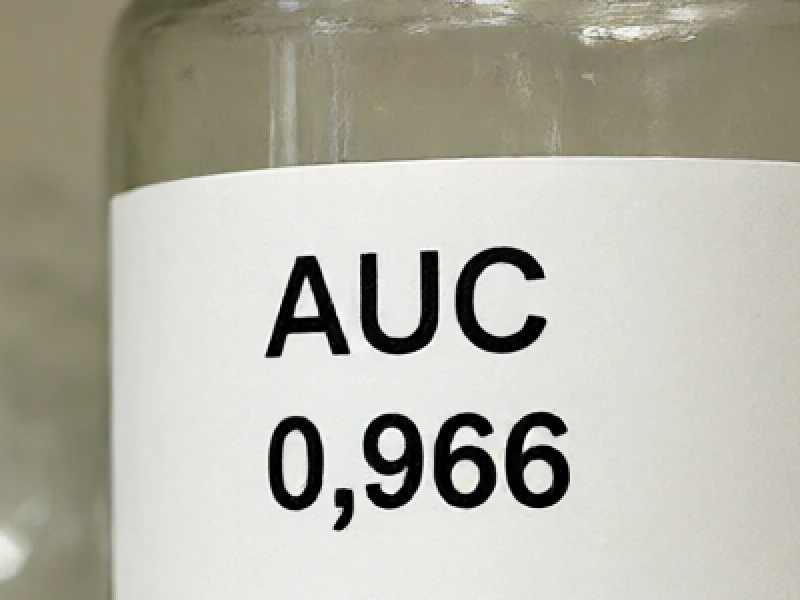
A glass jar on a kitchen shelf with a white paper label printed in black capitals "AUC 0,966", shallow depth of field
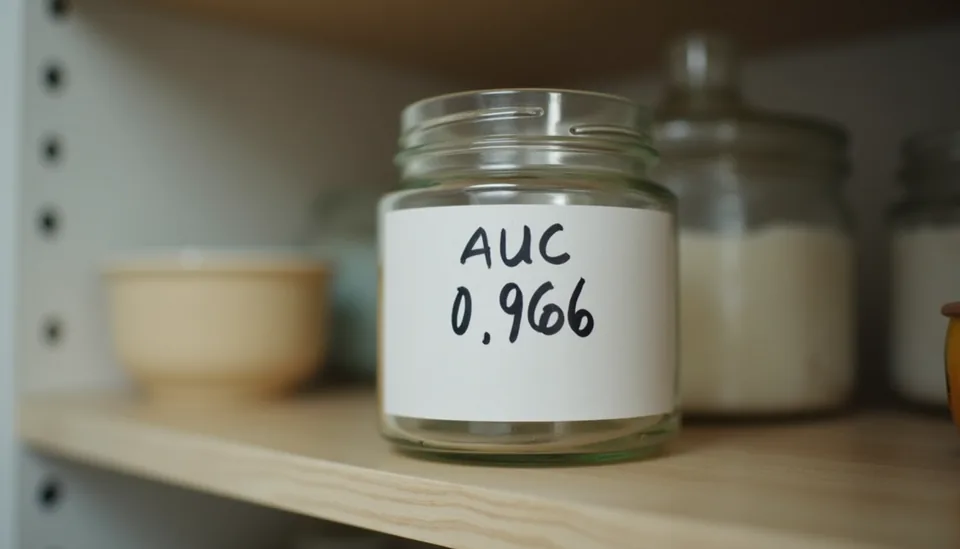
✓ como se pidió
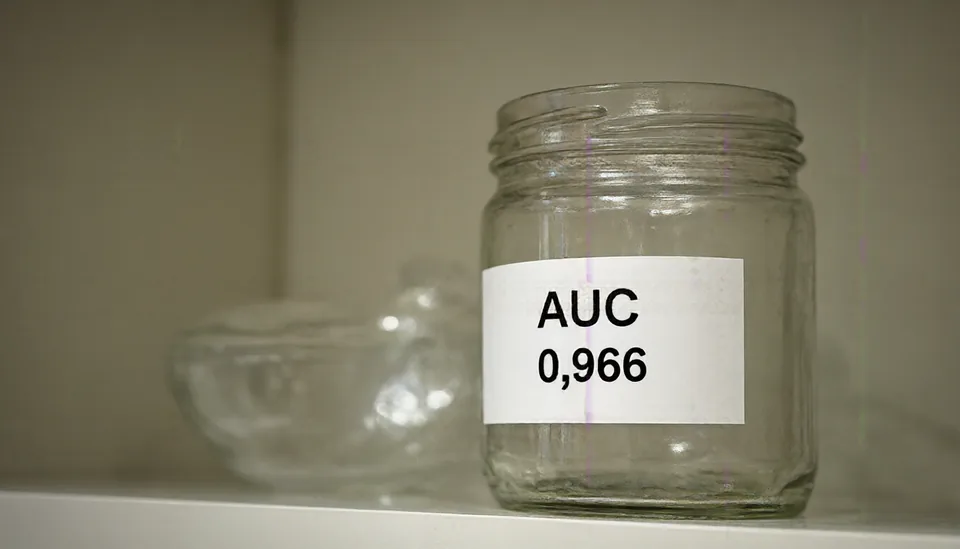
✓ Rayas moradas verticales
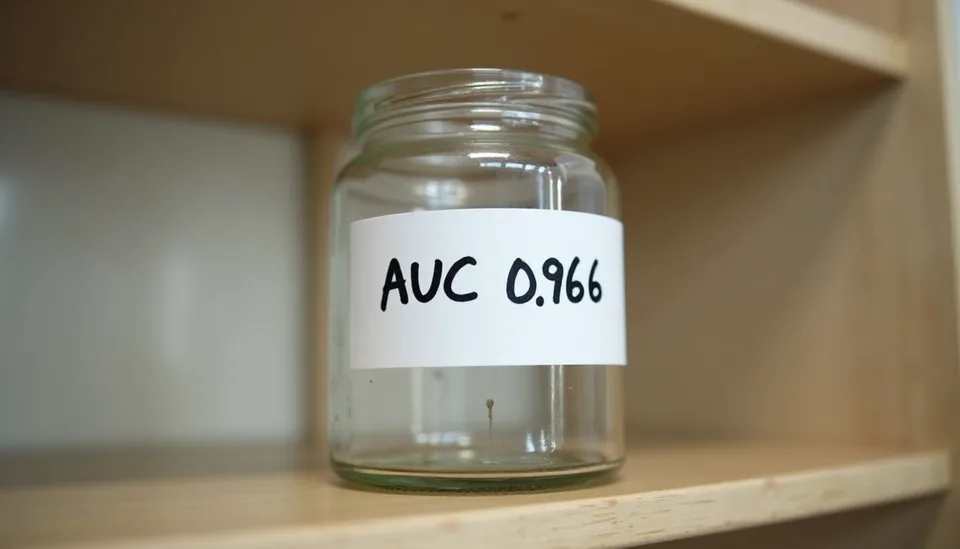
✗ «0.966»
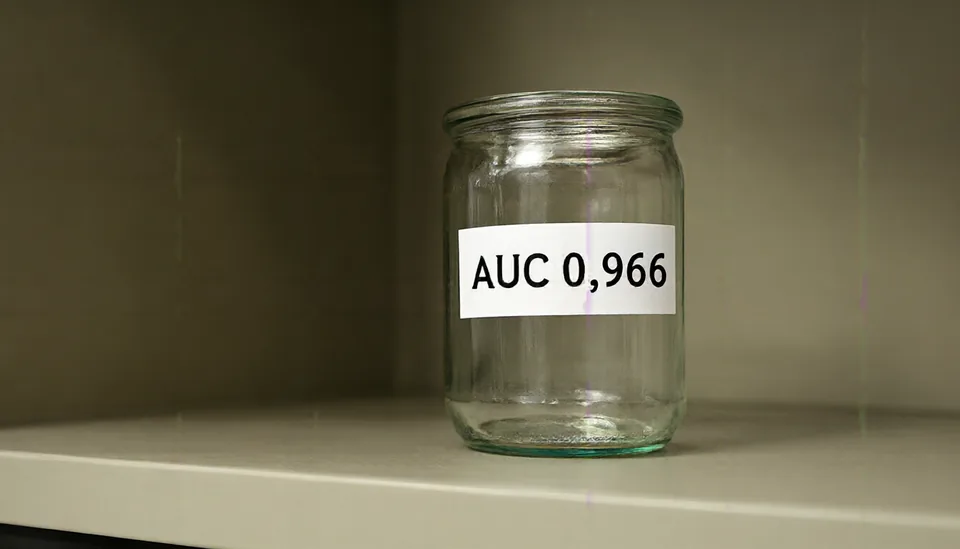
✓ Rayas moradas verticales
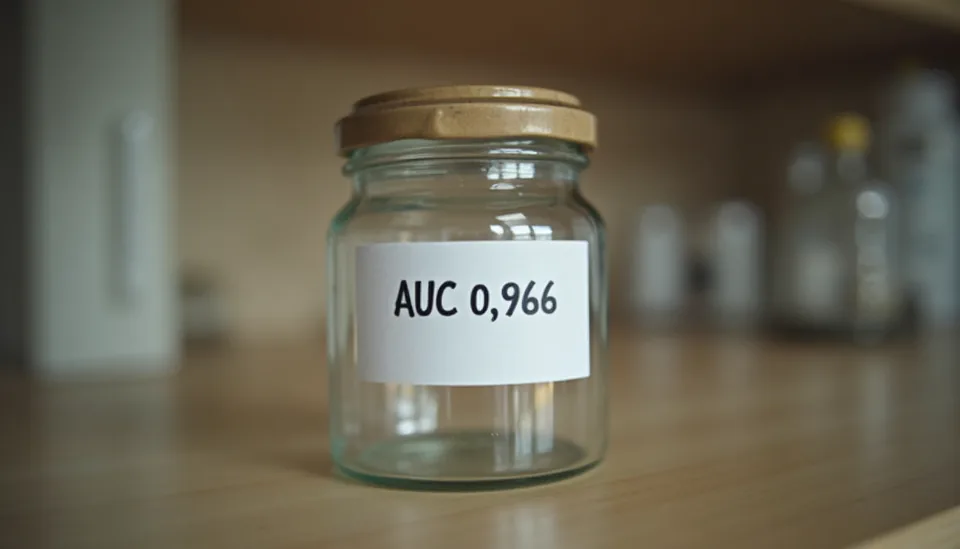
✓ como se pidió
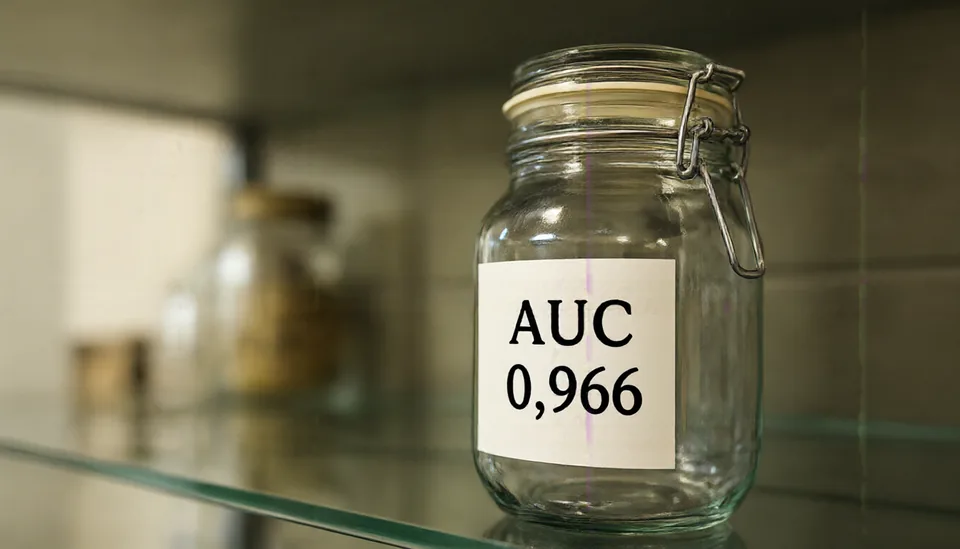
✓ Rayas moradas verticales
Se pidió PostgreSQL 19
Prompt completo
A yellow road sign on a mountain road at dusk, black letters reading "PostgreSQL 19", pine trees behind
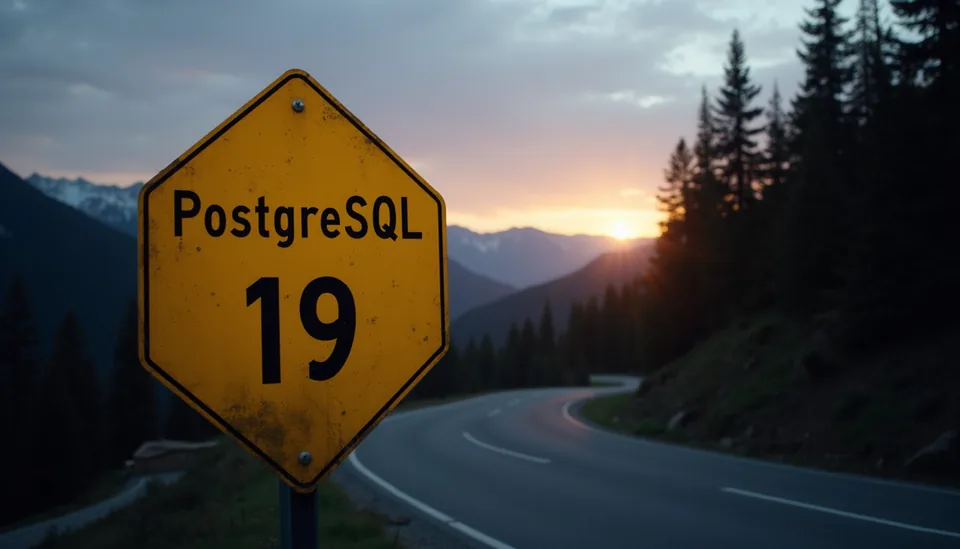
✓ como se pidió
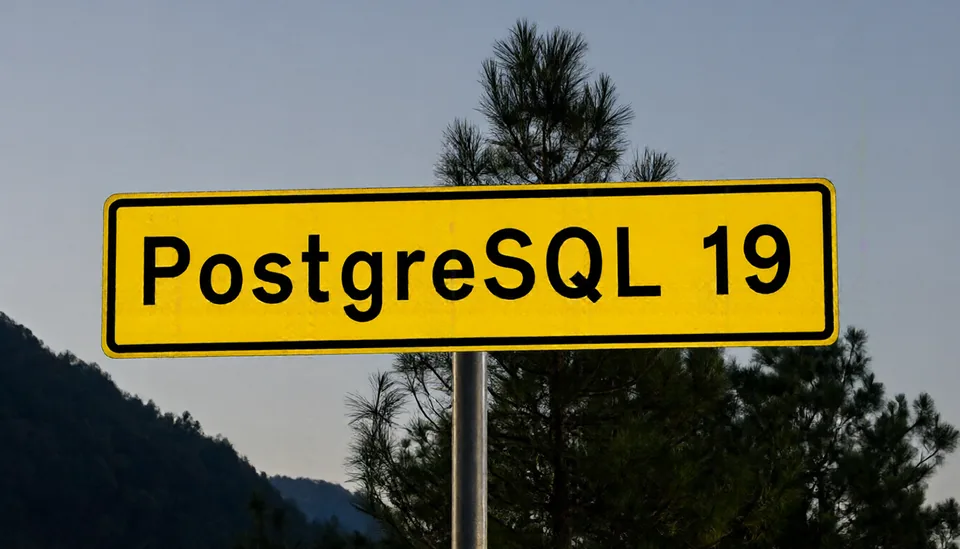
✓ como se pidió
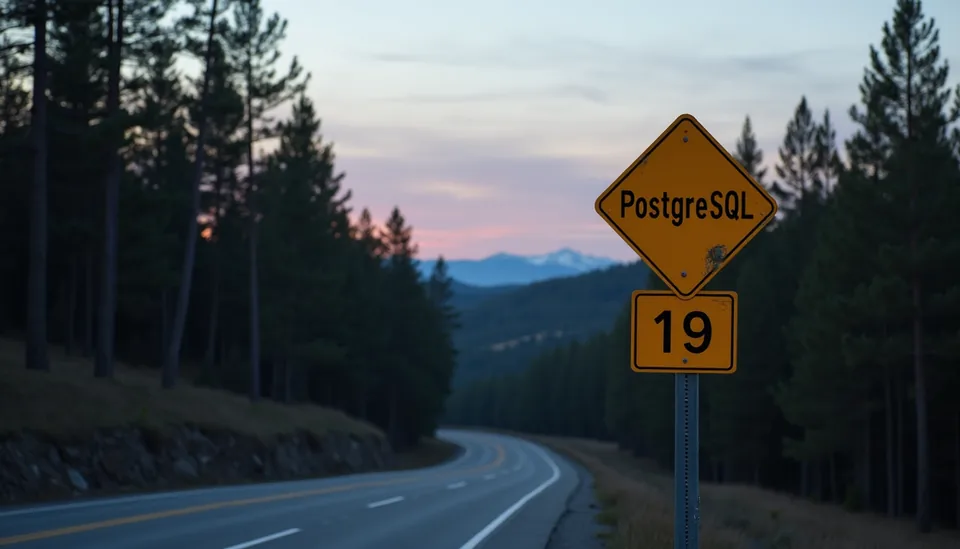
✓ El 19 va en otra placa
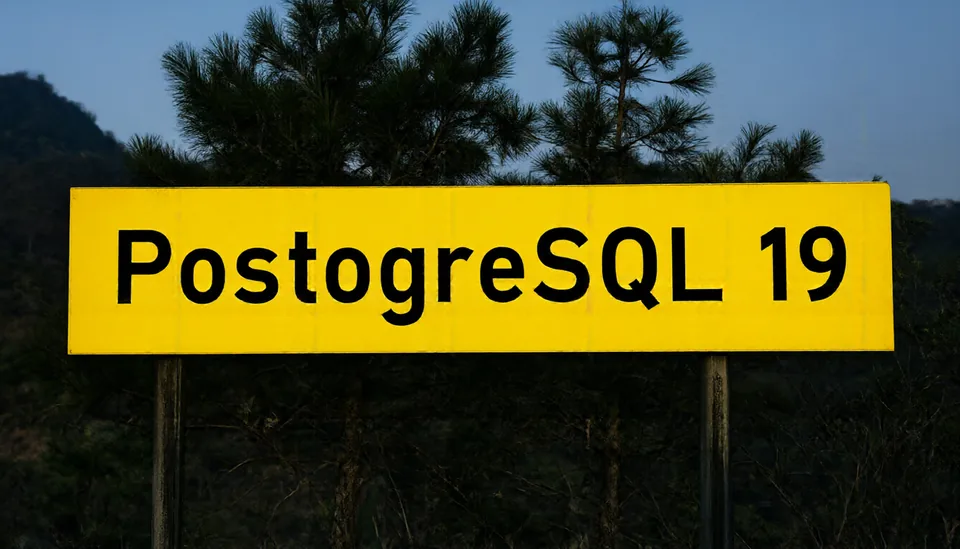
✗ «PostogreSQL»
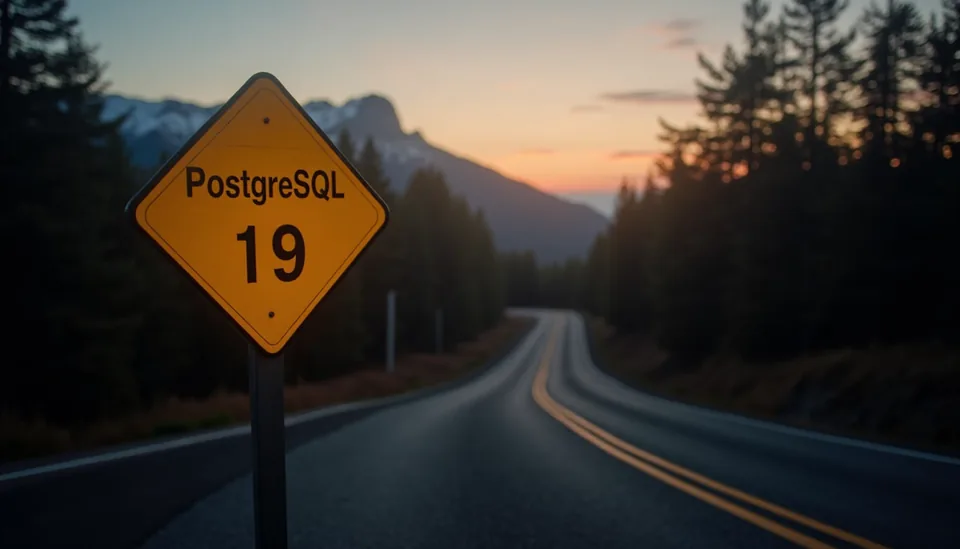
✓ como se pidió
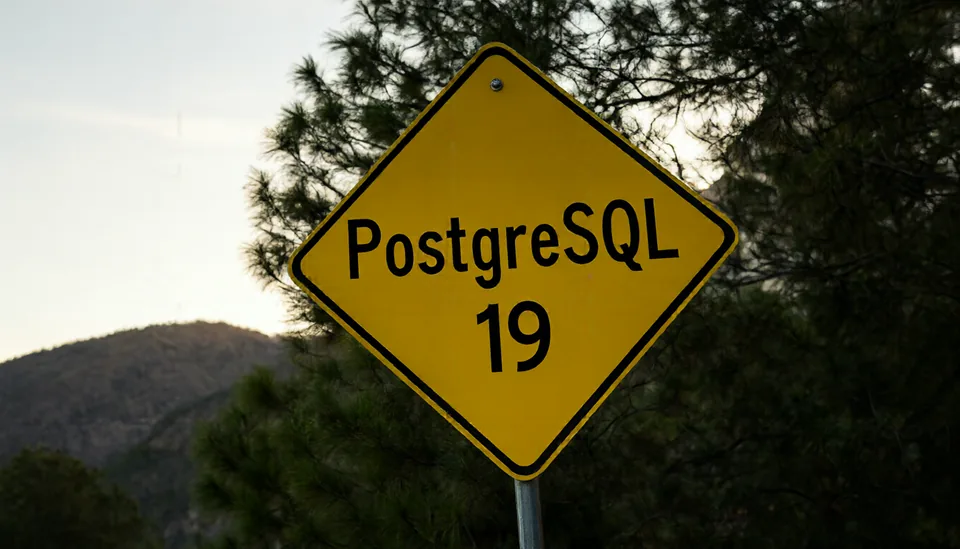
✓ como se pidió
Qwen sin cuantizar, en una A6000 de 48 GB arrendada, escribió exactos 17 de los 18 textos; el que quedó a medias fue «Post / greSQL», partido en dos líneas. La versión NF4 sacó 13: cinco empeoraron y uno mejoró. No aíslo la causa, porque además de cuantizar cambian la GPU y la versión de torch. El error más claro se repite: en la pizarra NF4 escribió «recido» las tres veces. Los dos Qwen ignoraron el afiche del primer prompt y pintaron el texto directo sobre la pared.
Las portadas de este blog
Cinco prompts reales de portada, tres seeds cada uno. Los revisé contra lo que pide el prompt: un robot, su acción y los objetos clave. ✓ si está todo, ≈ si falla un elemento, ✗ si falta la acción o el objeto principal. Son los prompts de producción sin cambios, y son largos: CLIP, uno de los dos codificadores de FLUX, corta su final a los 77 tokens, justo donde va la escena; el otro, T5, los recibe enteros. Comparo los dos flujos tal como corren, no la capacidad de cada modelo con un prompt hecho a su medida.
p0 Robot con lupa ante un podio de tres bloques; el más alto, agrietado
Prompt completo
umempart, pixel art, flat colors, retro 16-bit game sprite style, crisp pixel edges, dark navy background, teal and amber accent lighting, clean composition with empty space, no text, no letters, a single cute robot with a round helmet, one big glowing lens eye and an antenna with an amber spark on top, standing on the left third, holding a large magnifying glass up to a winners podium of three stacked blocks, the tallest middle block of the podium has a big crack running down it, wide horizontal composition, the robot is teal with amber details
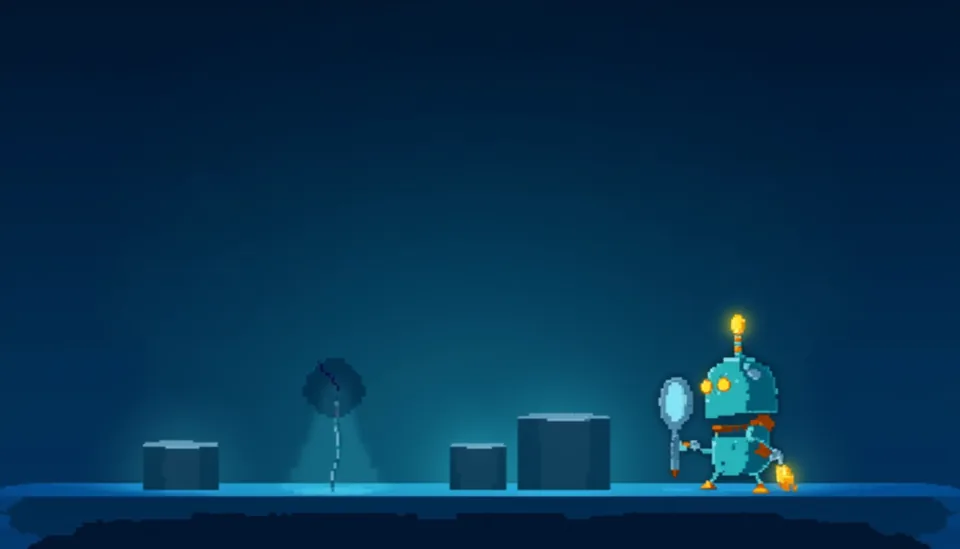
✗ Bloques sueltos: sin podio ni grieta
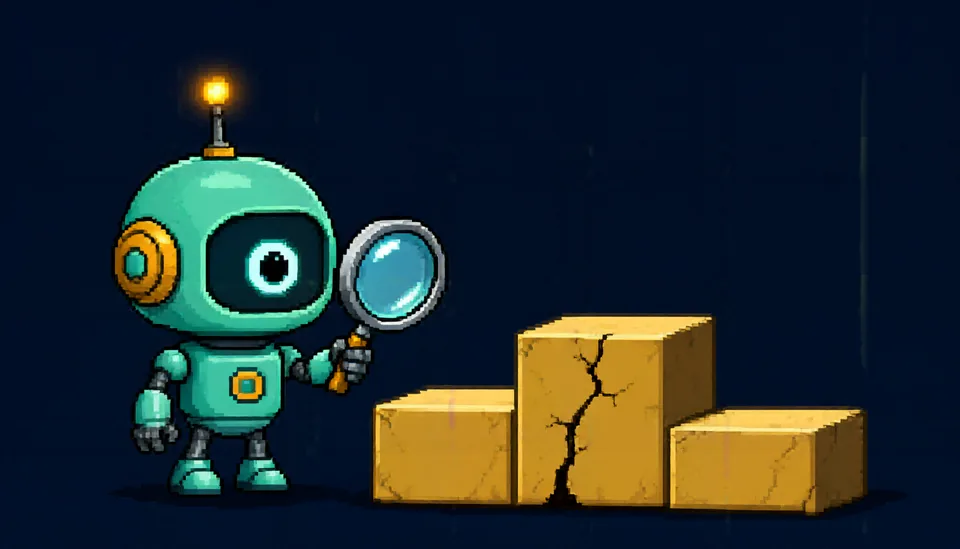
✓ como se pidió
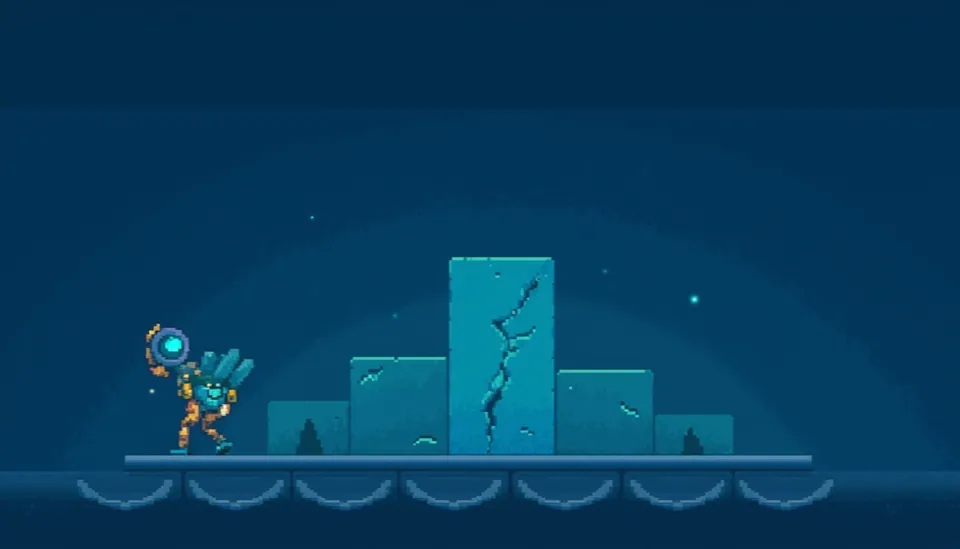
≈ Podio de cinco bloques, no tres
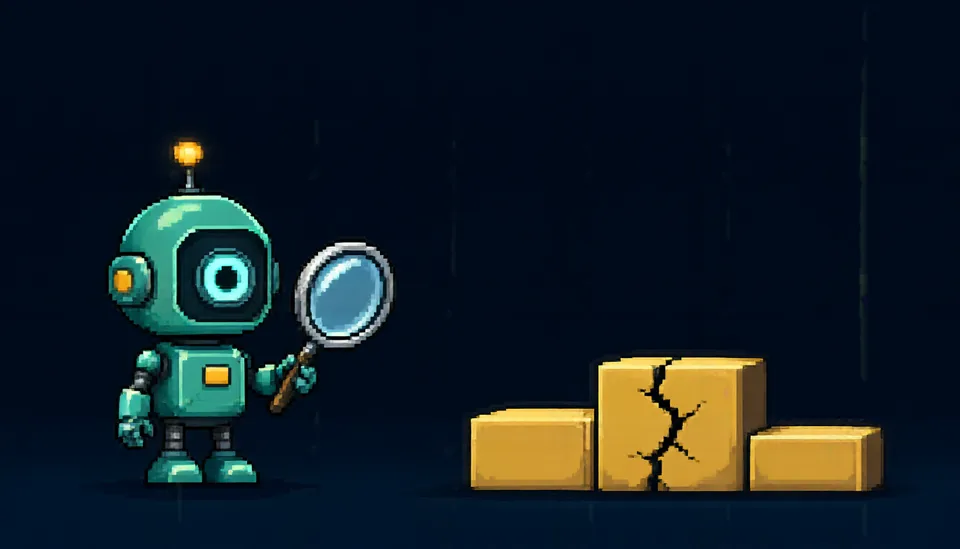
✓ como se pidió
✗ Sin lupa ni grieta
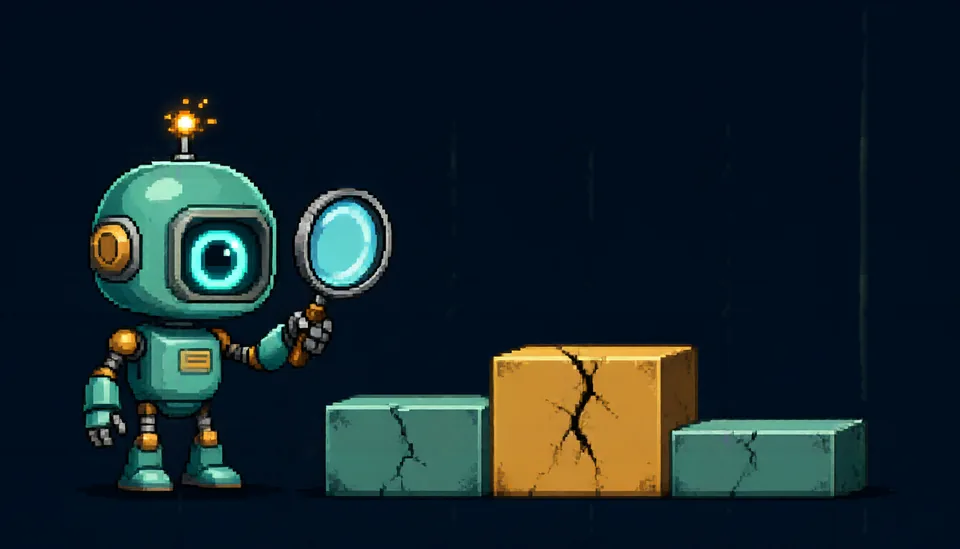
✓ Grieta en los tres bloques
p1 Robot que tira de un rollo de papel que se amontona en bucles
Prompt completo
umempart, pixel art, flat colors, retro 16-bit game sprite style, crisp pixel edges, dark navy background, teal and amber accent lighting, clean composition with empty space, no text, no letters, a single cute robot with a round helmet, one big glowing lens eye and an antenna with an amber spark on top, standing on the left third, pulling an extremely long paper scroll list that unrolls across the whole floor behind it and piles up in loops, the scroll covered in tiny rows of dots, dark navy background, wide horizontal composition, the robot is teal with amber details
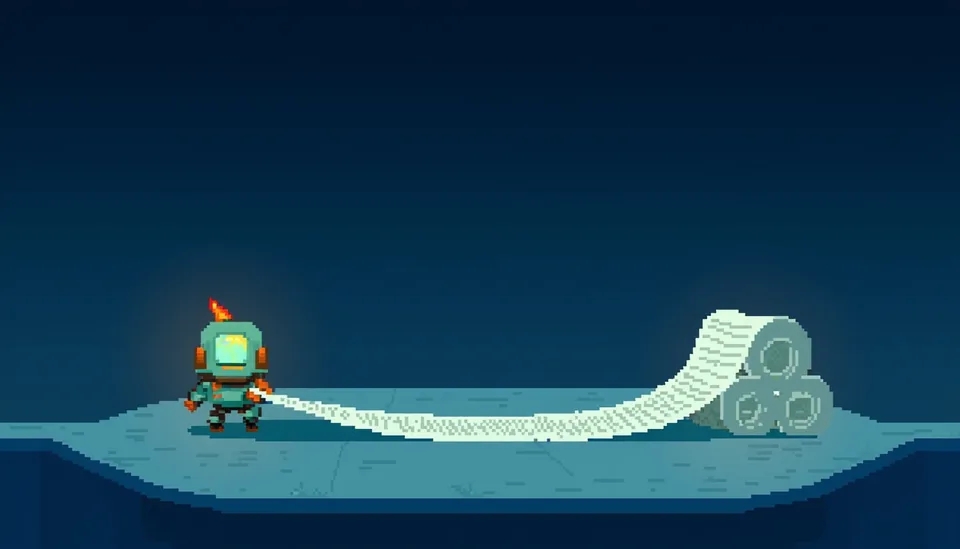
≈ Rollo largo, sin bucles
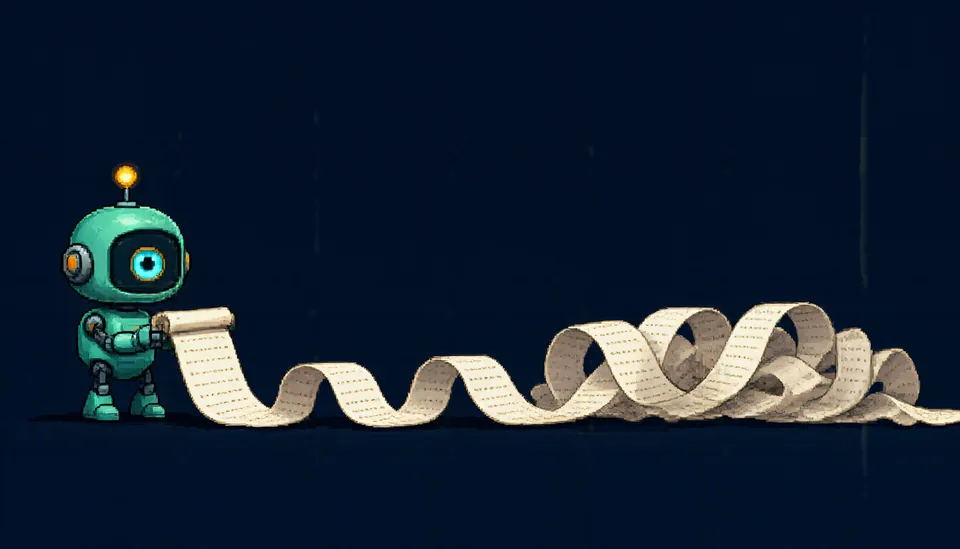
✓ como se pidió
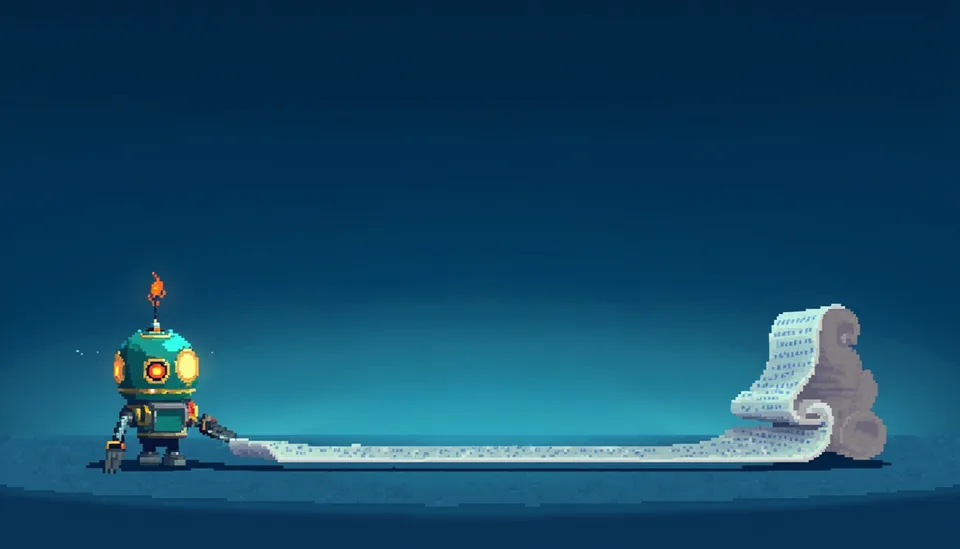
≈ Rollo largo, sin bucles
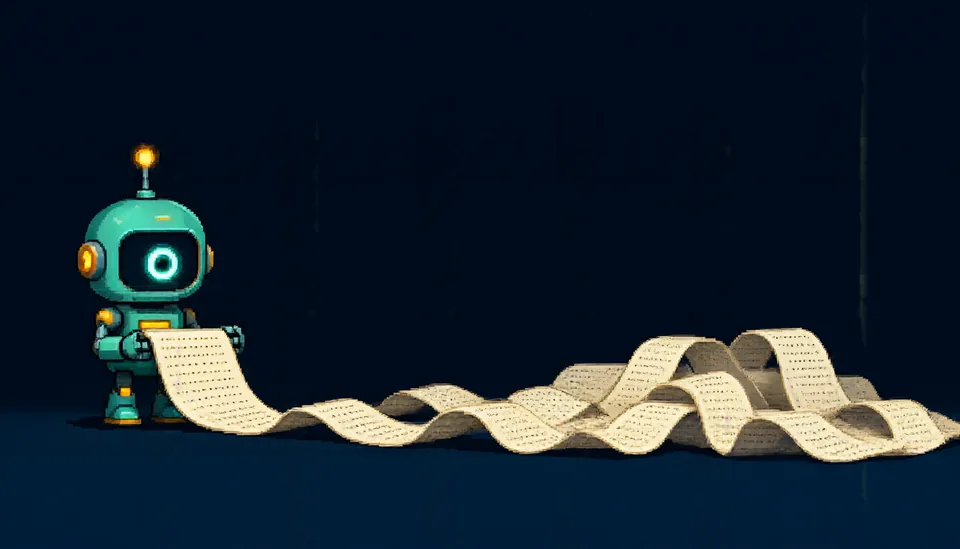
✓ como se pidió
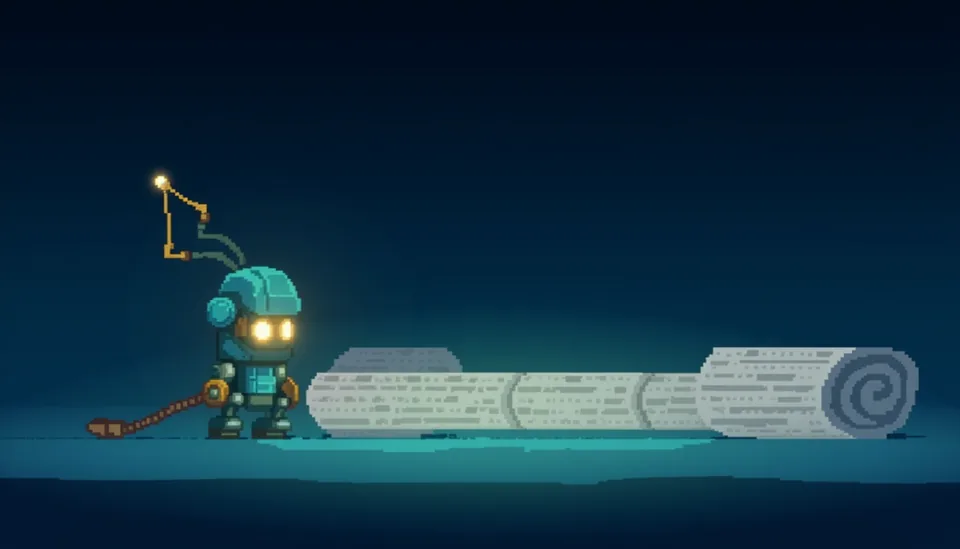
✗ Rollos cerrados; no tira de nada
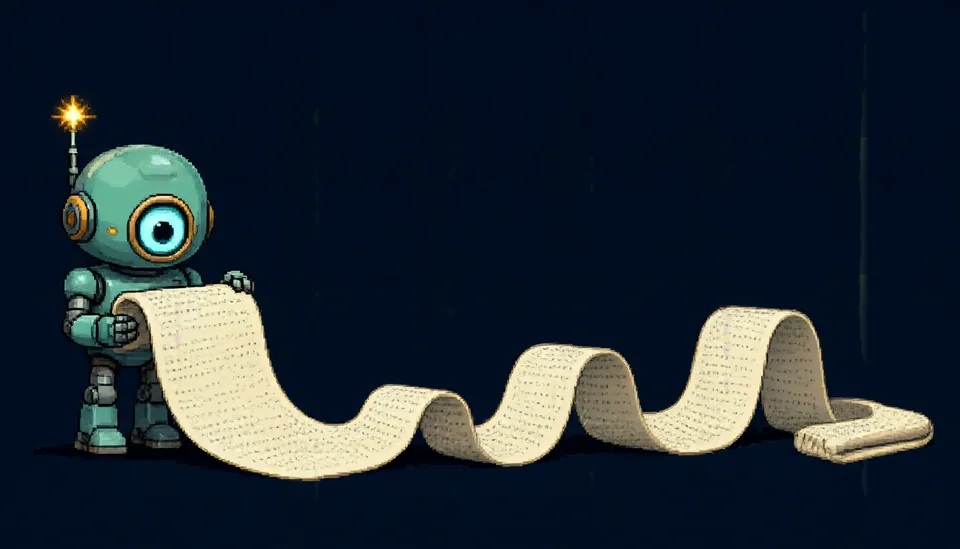
≈ Ondas, pero no se amontona en bucles
p2 Robot con una llave gigante frente a una puerta de bóveda redonda
Prompt completo
umempart, pixel art, flat colors, retro 16-bit game sprite style, crisp pixel edges, dark navy background, teal and amber accent lighting, clean composition with empty space, no text, no letters, a single cute robot with a round helmet and one big glowing lens eye holding a giant brass key in front of a round vault door, wide horizontal composition
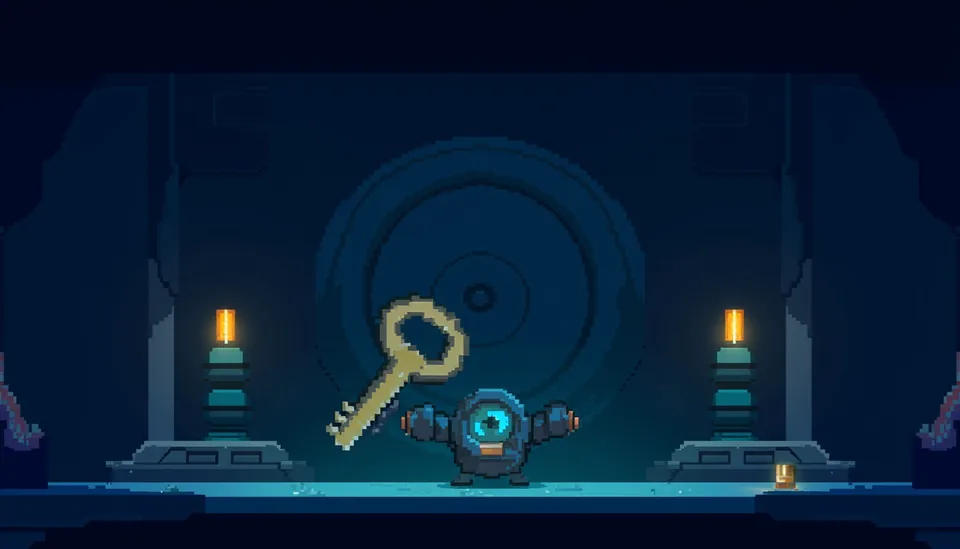
✗ La llave flota lejos del robot
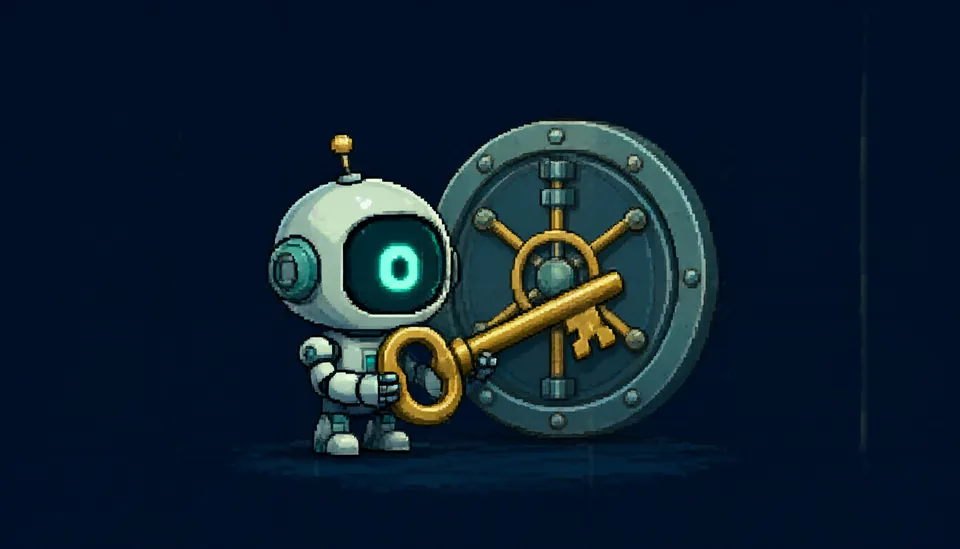
✓ como se pidió
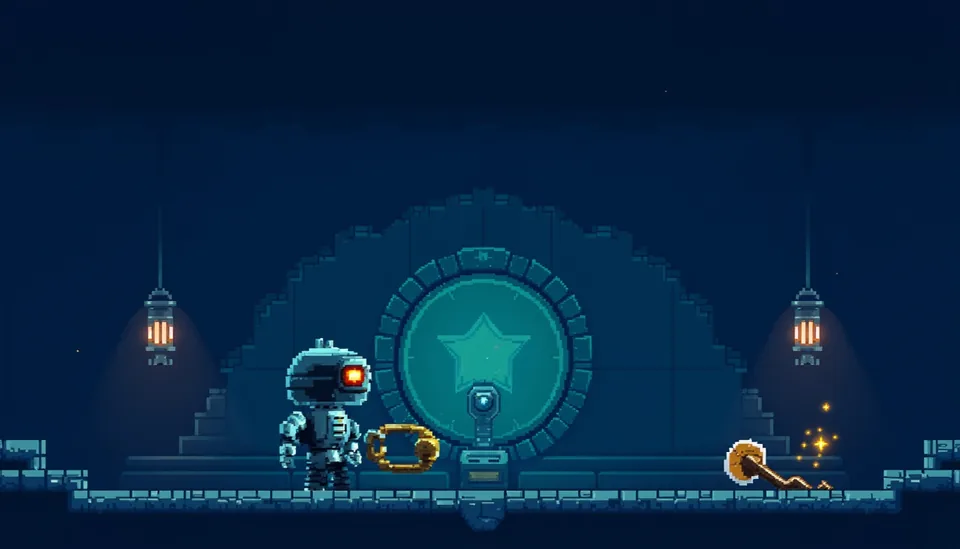
✗ La llave queda en el suelo
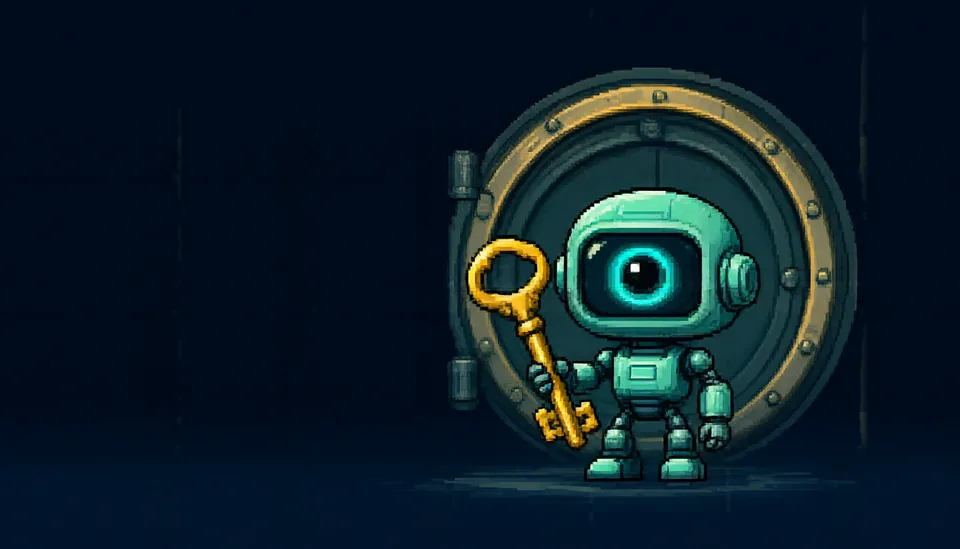
✓ como se pidió
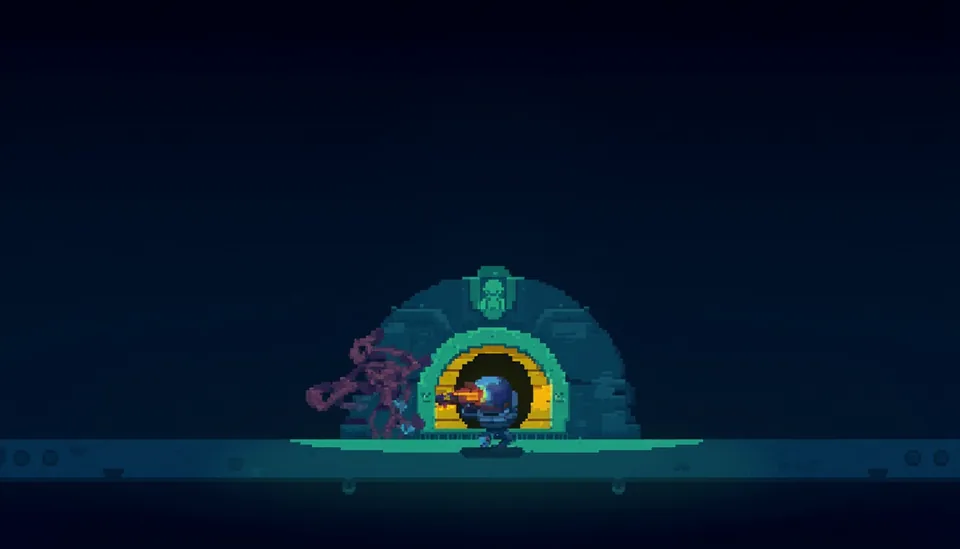
✗ Sin llave
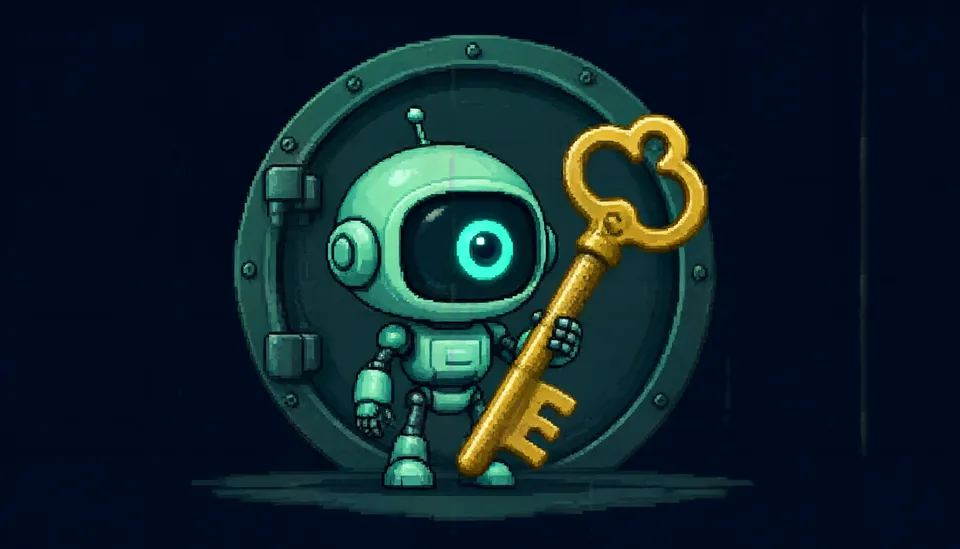
✓ como se pidió
p3 Robot juez en un escritorio, clasificando cuadros de película en dos canastos
Prompt completo
umempart, pixel art, flat colors, retro 16-bit game sprite style, crisp pixel edges, dark navy background, teal and amber accent lighting, clean composition with empty space, no text, no letters, a single cute robot judge with a round helmet sitting at a desk sorting a pile of film frames into two baskets, wide horizontal composition
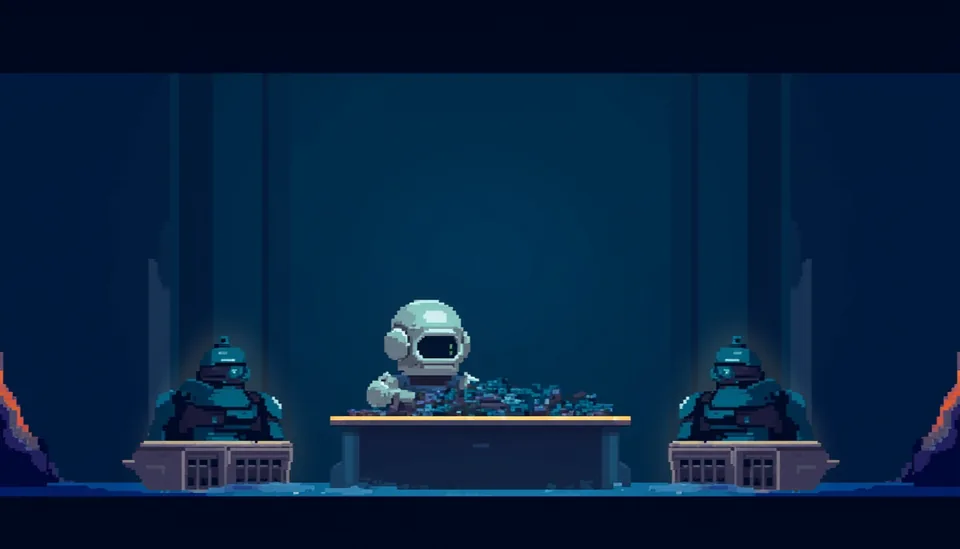
✗ Tres figuras en vez de un robot
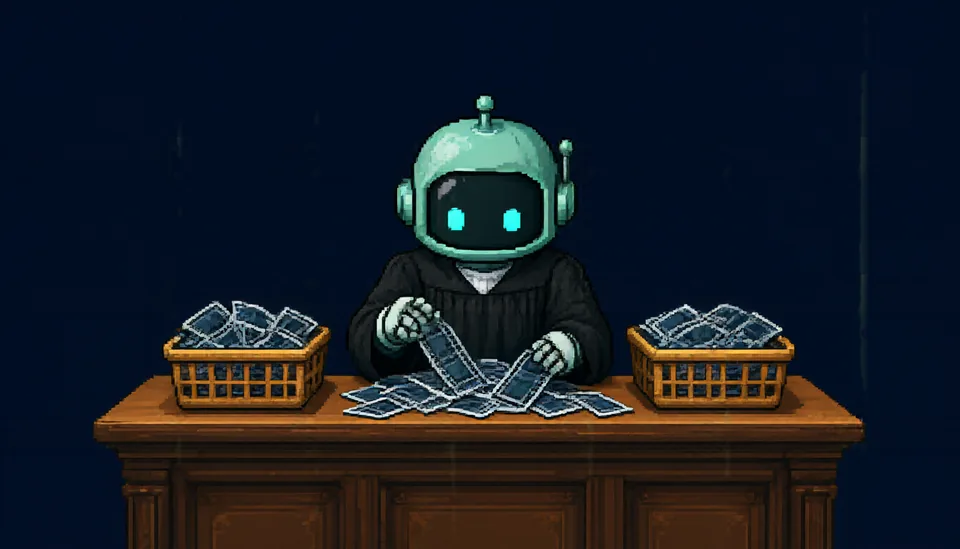
✓ Con toga de juez
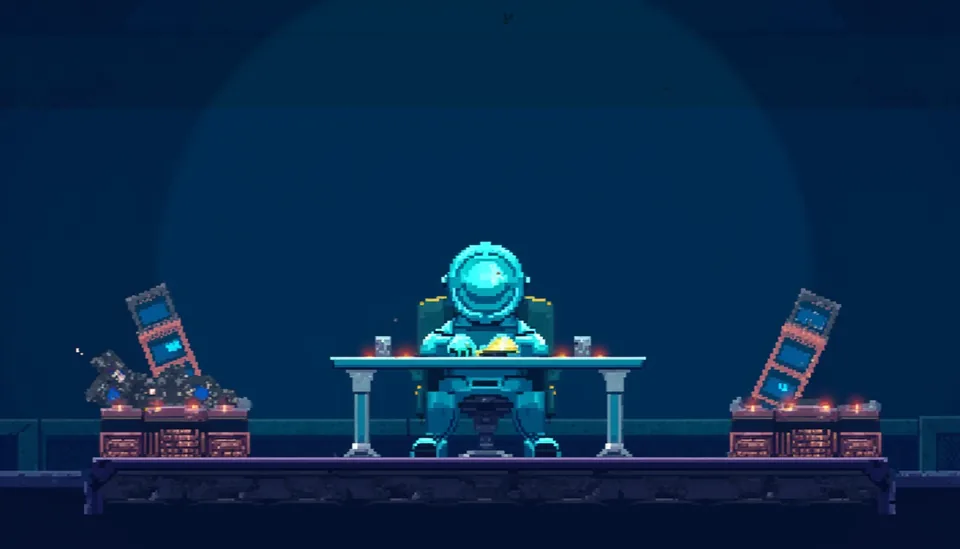
✗ No clasifica: los cuadros salen solos de los canastos
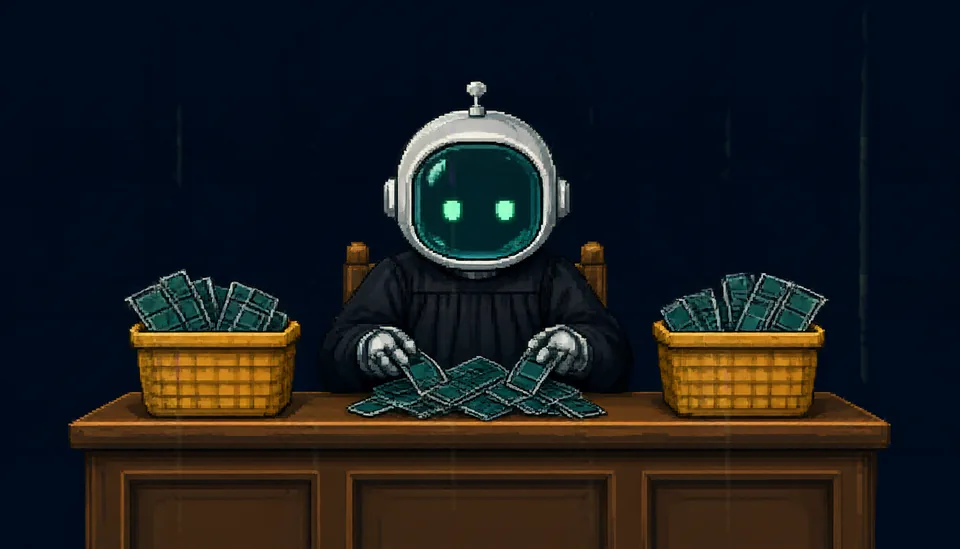
✓ Con toga de juez
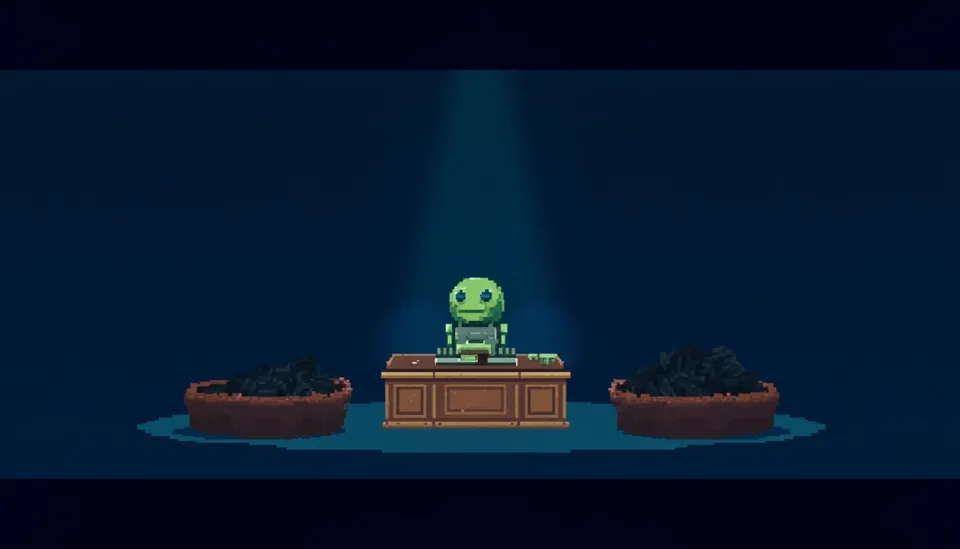
✗ Escritorio y canastos; no clasifica
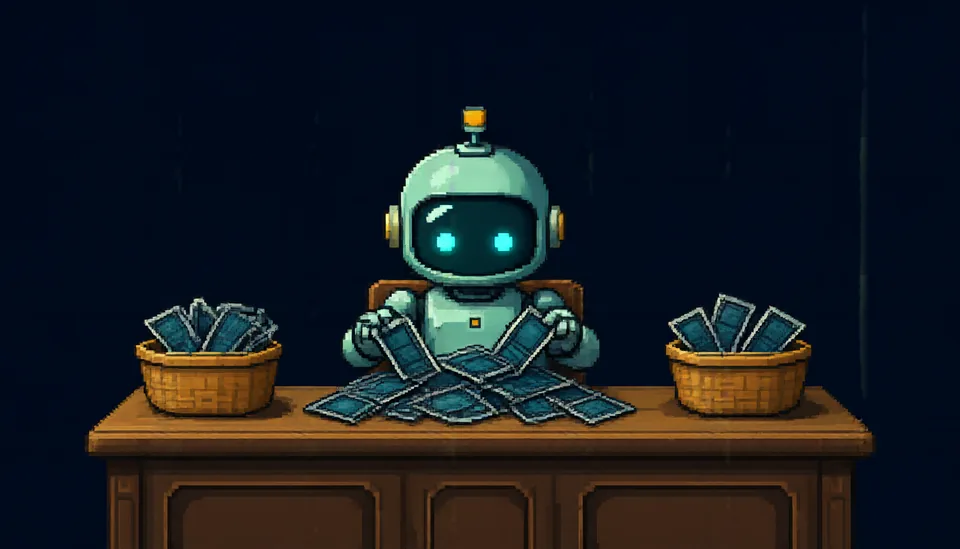
✓ como se pidió
p4 Robot con paraguas ante una ciudad de siete edificios
Prompt completo
umempart, pixel art, flat colors, retro 16-bit game sprite style, crisp pixel edges, dark navy background, teal and amber accent lighting, clean composition with empty space, no text, no letters, a single cute robot with an umbrella looking at a cloudy sky over a small city of seven buildings, wide horizontal composition
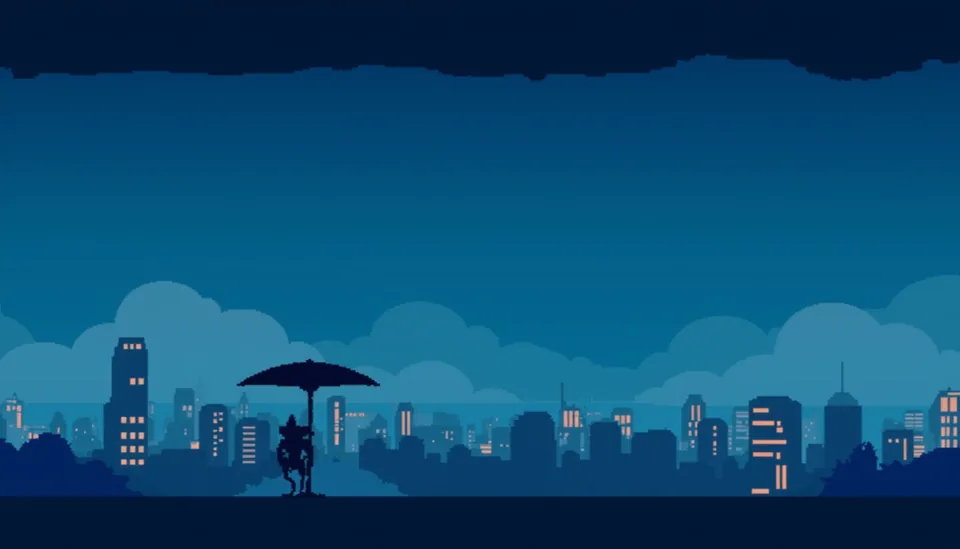
≈ Paraguas sí; decenas de edificios, no siete
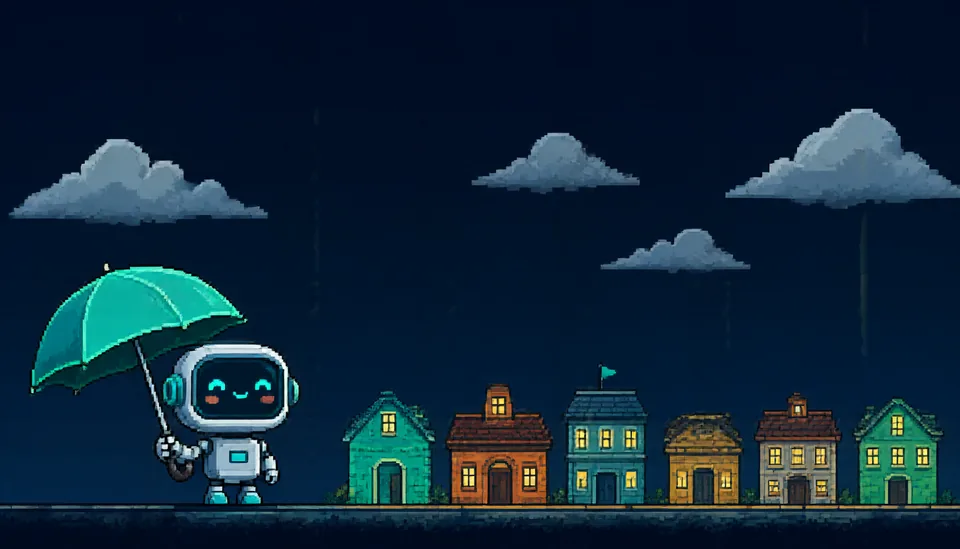
≈ 6 edificios
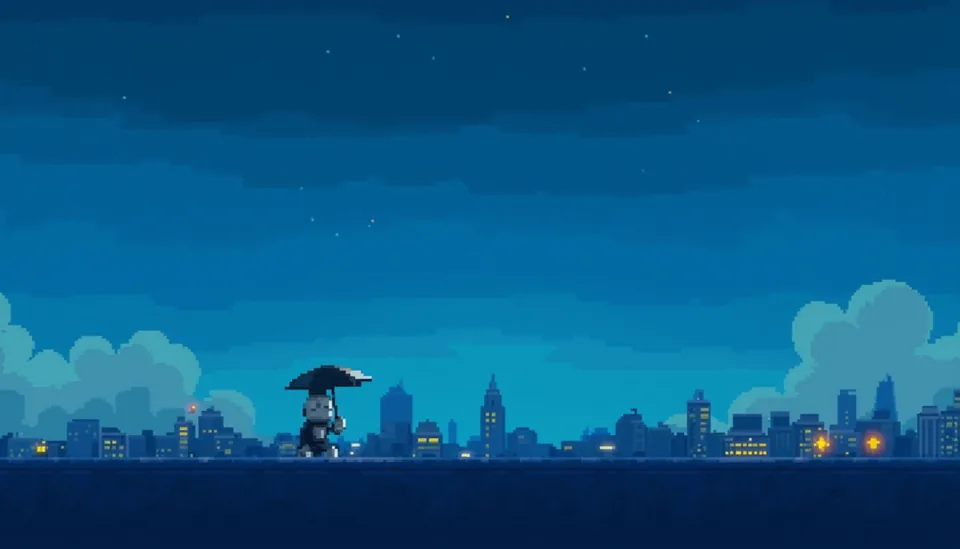
≈ Paraguas sí; decenas de edificios, no siete
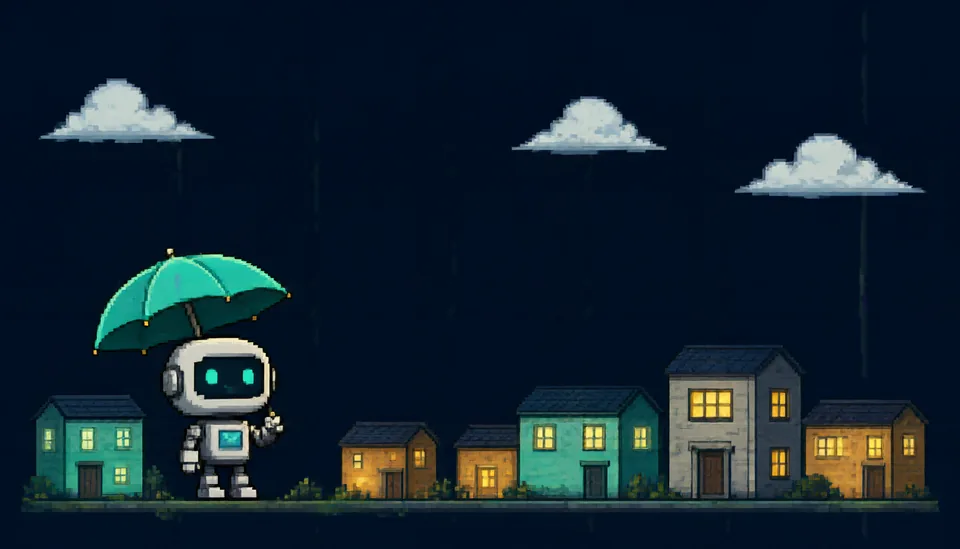
≈ 6 edificios
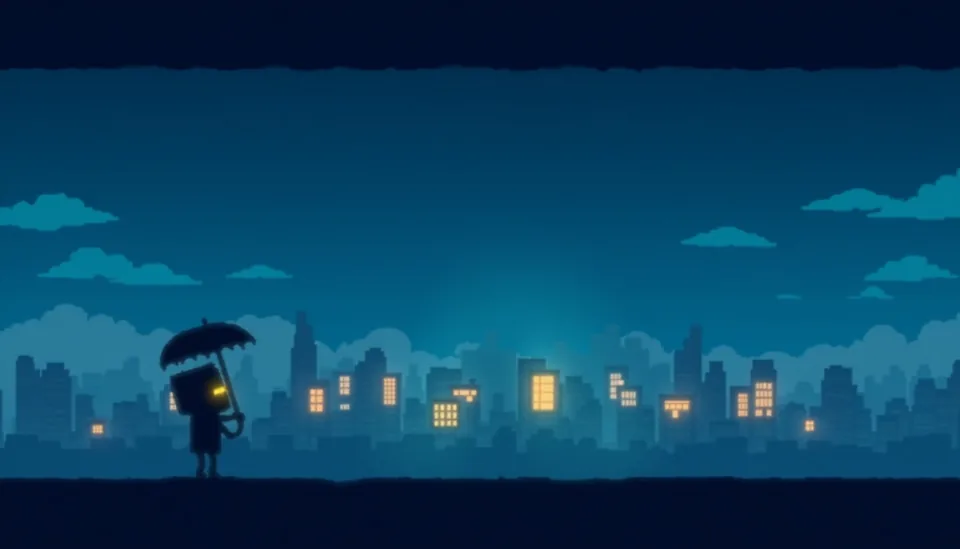
≈ Paraguas sí; decenas de edificios, no siete
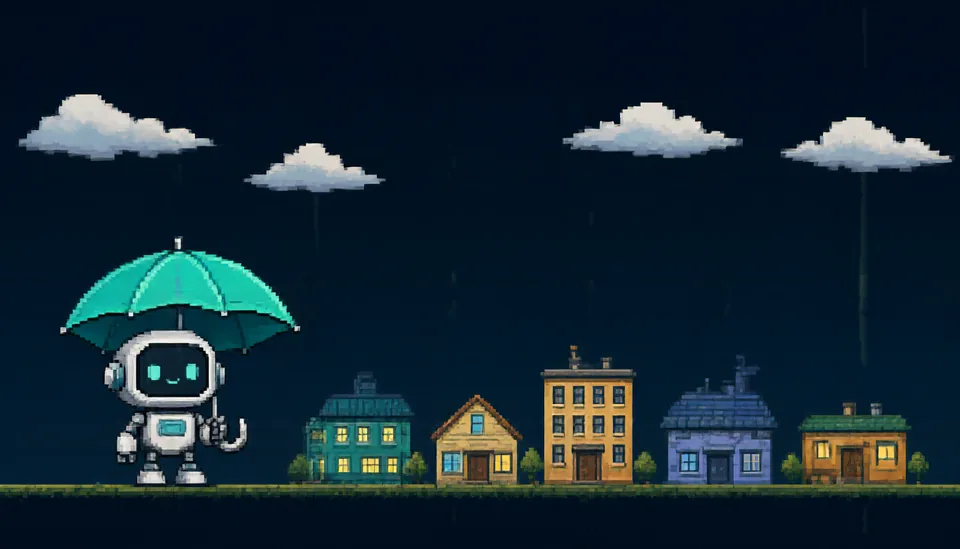
≈ 5 edificios
FLUX con la LoRA tiene el estilo: niebla, luz de borde y profundidad. Pero el sujeto sale chico y la acción se pierde: la llave flota lejos del robot, nadie clasifica los cuadros y la ciudad tiene decenas de edificios. En 6 portadas falla un elemento y en 9 falta lo principal. Qwen dibuja la escena en 11 de 15, con el robot grande y la acción clara, aunque sobre un fondo plano. Tampoco cuenta bien: pedí siete edificios y dibujó 6, 6 y 5.
Velocidad
nvidia-smi sobre la línea base al empezar: Qwen NF4 (VAE por tiles) 11,9 GiB, FLUX 13,1 GiB.
Pico de PyTorch: 36,8 GiB a 1344×768 y 32,6 GiB a 2752×1536.
Medianas de timing.jsonl y de los logs de FLUX, calculadas con timing.py.
Ya integrado en el studio, con la copia NF4 guardada en disco para no recuantizar en cada arranque, tres portadas de punta a punta tardaron 33,6 s, con la carga del modelo y el SSH incluidos. La de este post fue la primera que salió por ahí. Después regeneré con el mismo motor las 46 portadas del blog: dos seeds por post, elegí a ojo la que seguía la escena y repetí las dos que no la seguían.
Lo que se rompió y cómo lo arreglé
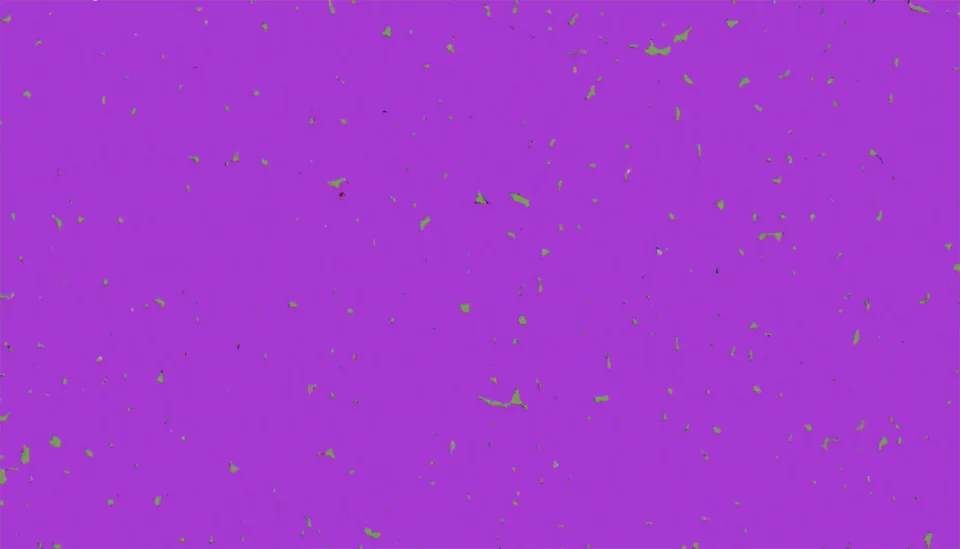
Para que todo cupiera en 16 GB, el VAE decodificaba la imagen por tiles, y eso dejaba rayas verticales moradas tenues en las superficies claras. No venían de NF4: aparecen igual en bf16 cuando se decodifica por tiles. Con tiles de 512 la raya baja pero no se va, y con tiles de 768 ya no cabe. Lo que funcionó fue separar el trabajo en dos fases: primero los latentes de todas las portadas, después saco el transformer y el codificador de la GPU y el VAE decodifica cada imagen entera. En la prueba de la etiqueta, decodificar y guardar tomó 0,77 s, con 7,1 GiB de pico de PyTorch en esa fase.
Veredicto
Para mis portadas, con estos prompts, Qwen NF4 pasa a ser el motor del perfil de portadas del studio. Siete veces más rápido en la misma tarjeta, con texto legible y la escena que pido, vale más que la atmósfera de la LoRA. FLUX con la LoRA queda instalado como respaldo para las escenas donde el ambiente importa más que el contenido.
Si el texto tiene que ser exacto, igual lo reviso a ojo: Qwen sin cuantizar escribió 17 de 18 en la A6000 que arrendé, y la versión de 16 GB, 13.
Preguntas frecuentes
¿Qwen-Image-2.1-Turbo cabe en una GPU de 16 GB?
En bf16 y con todo en la GPU, no: el pipeline pesa 32,5 GB en disco y mi intento con offload a 30 GB de RAM falló. Corre con el transformer y el codificador de texto cuantizados a NF4 con bitsandbytes. La copia cuantizada ocupa 10,6 GiB en disco y, en una RTX 4070 Ti SUPER, nvidia-smi marcó 11,9 GiB por encima de lo que la tarjeta tenía ocupado al empezar, con el VAE por tiles.
¿Cuánto más rápido es que FLUX?
En la misma tarjeta y a 1344×768, Qwen NF4 tardó 8,4 s por imagen (mediana de 36) y FLUX.1-dev Q6_K con la LoRA de portadas, 61 s (mediana de 15). Unas 7 veces. Qwen usa 8 pasos y FLUX 30. En el studio, tres portadas de punta a punta, con la carga del modelo incluida, tardaron 33,6 s.
¿Escribe texto mejor que FLUX?
En estas 18 imágenes con texto pedido, revisadas a ojo, Qwen NF4 escribió exacto 13 y FLUX 7. Qwen sin cuantizar, en una A6000 de 48 GB, escribió 17. La versión NF4 escribió «recido» en vez de «rápido» las tres veces.
¿Por qué no usar 8 bits en vez de NF4?
Porque el transformer en 8 bits (LLM.int8) devolvió un campo morado casi uniforme. Lo aislé en una A6000 cuantizando un componente a la vez: con el transformer en NF4 la imagen sale bien.
¿De dónde salían las rayas moradas?
De decodificar el VAE por tiles, que hacía falta para que todo cupiera en 16 GB. También aparecen en bf16 con tiles. Las quité generando primero los latentes, sacando el transformer y el codificador de la GPU y decodificando la imagen entera: decodificar y guardar tomó 0,77 s, con 7,1 GiB de pico de PyTorch en esa fase, en la prueba de la etiqueta.
¿Puedo reproducirlo?
Sí. Los prompts, los scripts de generación, la revisión imagen por imagen y los tiempos están en un gist enlazado en las fuentes.
Fuentes
- Qwen-Image-2.1-Turbo, la ficha del modelo.
- El pipeline de Qwen-Image en diffusers y la cuantización con bitsandbytes.
- QLoRA, el paper que define NF4, y LLM.int8(), el de la cuantización en 8 bits.
- FLUX.1-dev y su versión GGUF, de donde sale el Q6_K.
- gemma3:4b, el lector automático de control.
- Los prompts, los scripts, la revisión imagen por imagen y los tiempos.
Medido el 10 de octubre de 2026. FLUX.1-dev Q6_K GGUF con la LoRA ume_modern_pixelart (flux_batch.py, el motor del studio) y Qwen-Image-2.1-Turbo NF4 (torch 2.14.1, diffusers 0.41.0.dev0 en el commit 1d5d056, transformers 5.19.0, bitsandbytes 0.50.2) en la misma RTX 4070 Ti SUPER de 16 GB; Qwen bf16 en una RTX A6000 de 48 GB arrendada (torch 2.8.0). 1344×768, seeds 7, 21 y 88.
Comentarios
Todavía no hay comentarios. El primero es tuyo.