
Claude Code, Codex, OpenCode, OpenClaw, Hermes, mini-swe-agent y Raven con MiniMax-M3: 7 arneses de agentes medidos en Terminal-Bench 2.0
Puse siete arneses de agentes de código a manejar el mismo modelo barato, MiniMax-M3, en 40 tareas de Terminal-Bench 2.0: 280 ejecuciones con cada petición guardada y cada aprobada revisada por un juez ciego. El arnés más simple, mini-swe-agent, resolvió 29 de 39; Codex 26, OpenCode 25, Claude Code 23, OpenClaw y Hermes 22, Raven 20. Ninguna diferencia entre dos arneses sobrevive a la corrección por comparaciones múltiples. OpenCode fue el más barato y rápido; Raven, el más caro.
Un modelo barato no se usa solo: se usa dentro de un arnés, el programa que le da herramientas, le arma el contexto, ejecuta lo que pide y decide cuándo terminó. Claude Code, Codex, OpenCode y compañía son eso, arneses, y casi todos aceptan cualquier modelo compatible. La pregunta que me hacía era cuál de ellos le saca más a un modelo que no es de primera línea. Y como respuesta encontraba opiniones, no mediciones con el mismo modelo, las mismas tareas y los mismos límites.
Así que lo medí. Siete arneses, el mismo MiniMax-M3, 40 tareas de Terminal-Bench 2.0, 280 ejecuciones, cada petición al modelo guardada completa y cada tarea aprobada revisada por un juez que no sabía qué arnés miraba.
Qué medí, y con qué reglas
Antes de la primera ejecución dejé escrita una ficha con la pregunta, los arneses, las tareas y la regla de decisión, y la fui enmendando por escrito cada vez que algo cambió: nueve enmiendas, cada una con su motivo y su fecha, todas commiteadas antes de mirar los datos que afectan.
- Arneses: Claude Code, Codex CLI, OpenCode, OpenClaw, Hermes Agent, mini-swe-agent y Raven. Los cinco primeros son los más populares hoy; mini-swe-agent es el mínimo de referencia; Raven es un arnés de gerente con sub-agentes, la idea opuesta.
- Modelo: MiniMax-M3 en los siete, con el plan de tarifa fija de MiniMax. MiniMax tiene dos dialectos: compatible con Anthropic y compatible con OpenAI; cada arnés habla el suyo.
- Tareas: 40 sorteadas (semilla 17) de las 79 de Terminal-Bench 2.0 que la solución de referencia pasa en mi máquina. Diez tareas quedaron fuera antes de empezar porque ni la solución oficial las pasa aquí (descargas cortadas, emulación).
- Cómo se ejecuta cada una: con Harbor 0.24, el ejecutor oficial de Terminal-Bench. Una ejecución a la vez, el mismo tiempo límite que fija cada tarea, la misma máquina, el orden de los arneses rotado por tarea.
- Lo que se mide: si las pruebas propias de la tarea pasan (reward 1). Esas pruebas se montan cuando el agente termina, así que el agente no las ve.
- Regla: tareas resueltas por arnés con su intervalo de confianza del 95 % (Wilson); comparación pareada entre cada par de arneses con McNemar exacto y corrección de Holm por las 21 comparaciones.
Entre cada arnés y MiniMax puse un proxy propio que guarda el cuerpo completo de cada petición y de cada respuesta. Con eso recalculé los tokens de verdad (los contadores de los arneses no siempre suman la caché) y reconstruí lo que hizo cada agente para auditarlo.
Resultados
| Arnés | Resueltas (de 39) | IC 95 % | Costo de las 40 ejecuciones | Mediana por tarea |
|---|---|---|---|---|
| mini-swe-agent | 29 (74 %) | 59–85 % | 8,79 USD | 9,3 min |
| Codex CLI | 26 (67 %) | 51–79 % | 7,33 USD | 9,3 min |
| OpenCode | 25 (64 %) | 48–77 % | 4,13 USD | 6,4 min |
| Claude Code | 23 (59 %) | 43–73 % | 7,23 USD | 12,6 min |
| OpenClaw | 22 (56 %) | 41–71 % | 5,85 USD | 10,7 min |
| Hermes Agent | 22 (56 %) | 41–71 % | 6,51 USD | 12,5 min |
| Raven | 20 (51 %) | 36–66 % | 12,22 USD | 12,0 min |
Las 39 son las 40 menos fix-code-vulnerability, que explico más abajo; con ella, el orden es el mismo. El costo es el equivalente a la tarifa pública de MiniMax-M3 (0,30 USD por millón de tokens de entrada, 0,06 los leídos de caché, 1,20 los de salida), con los tokens recontados desde las respuestas guardadas.
- resuelta
- no resuelta
tareafuera: el repo muestra la solución
| mini-swe-agent | Codex CLI | OpenCode | Claude Code | OpenClaw | Hermes Agent | Raven | |
|---|---|---|---|---|---|---|---|
| cobol-modernization | |||||||
| code-from-image | |||||||
| headless-terminal | |||||||
| log-summary-date-ranges | |||||||
| modernize-scientific-stack | |||||||
| multi-source-data-merger | |||||||
| openssl-selfsigned-cert | |||||||
| prove-plus-comm | |||||||
| regex-log | |||||||
| reshard-c4-data | |||||||
| build-pov-ray | |||||||
| cancel-async-tasks | |||||||
| custom-memory-heap-crash | |||||||
| feal-differential-cryptanalysis | |||||||
| hf-model-inference | |||||||
| password-recovery | |||||||
| pypi-server | |||||||
| torch-tensor-parallelism | |||||||
| compile-compcert | |||||||
| crack-7z-hash | |||||||
| mteb-retrieve | |||||||
| count-dataset-tokens | |||||||
| overfull-hbox | |||||||
| path-tracing-reverse | |||||||
| query-optimize | |||||||
| sqlite-db-truncate | |||||||
| torch-pipeline-parallelism | |||||||
| extract-elf | |||||||
| feal-linear-cryptanalysis | |||||||
| large-scale-text-editing | |||||||
| sanitize-git-repo | |||||||
| llm-inference-batching-scheduler | |||||||
| regex-chess | |||||||
| video-processing | |||||||
| kv-store-grpc | |||||||
| make-mips-interpreter | |||||||
| polyglot-c-py | |||||||
| polyglot-rust-c | |||||||
| winning-avg-corewars | |||||||
| resueltas (39) | 29 | 26 | 25 | 23 | 22 | 22 | 20 |
Diez tareas las resolvieron los siete y cinco no las resolvió ninguno. La comparación vive en la franja del medio. Ahí, la diferencia más grande es entre mini-swe-agent y Raven: en las tareas donde no coinciden, mini-swe-agent ganó 10 y Raven 1. Sola, esa diferencia daría p = 0,012; corregida por las 21 comparaciones, como dice la ficha, sube a 0,25 y deja de alcanzar. Ninguna otra pareja se acerca. Con 39 tareas, la conclusión honesta es que ningún arnés es mejor que otro de forma probada, y que el más simple no fue peor que ninguno.
En costo sí hay distancia: Raven gastó casi el triple que OpenCode por las mismas 40 tareas, y resolvió 5 menos. OpenCode quedó en el mejor lugar de la relación entre lo que resuelve y lo que cuesta: tercero en tareas, primero en precio y en tiempo.
La misma tarea, siete maneras
Para ver la diferencia de estilo tomé una tarea que los siete resolvieron, openssl-selfsigned-cert (crear una llave, un certificado autofirmado, un PEM combinado y un script que lo verifique), y la reproduje con los tiempos reales: cada marca es una petición al modelo, en el segundo en que la hizo.
Mismo modelo, misma tarea, y Claude Code terminó en 100 segundos con 11 peticiones mientras Raven tardó 276 con 33. Las capturas de cada arnés, más abajo, son de estas mismas ejecuciones.
¿Hubo trampa?
Las tasas me parecieron altas para Terminal-Bench 2.0, así que antes de creerlas revisé cada una de las 174 tareas aprobadas. Primero, un barrido automático igual para los siete: leer o editar las pruebas, tocar el verificador, descargar soluciones, escribir la salida esperada sin calcularla. Después, un juez ciego (Opus) que leía la transcripción con los nombres de arnés y de herramientas borrados y clasificaba cada aprobada como legítima, trampa o dudosa, con la rúbrica escrita antes de empezar. Lo probé primero con dos transcripciones de control, una tramposa y una limpia, y acertó las dos.
Resultado: 171 legítimas. Las otras 3 son todas de fix-code-vulnerability. El repositorio de esa tarea trae la corrección de la vulnerabilidad como un cambio sin commitear, y un git diff la muestra. Los siete arneses ejecutaron ese git diff y los siete aprobaron. El juez marcó como trampa a tres y dejó pasar a cuatro que hicieron lo mismo, así que el juez tampoco fue consistente. Como el defecto es de la tarea y la vieron todos, la saqué de la comparación para los siete por igual.
Los siete, uno por uno
Cada arnés, con lo que resolvió, cómo lo conecté a MiniMax, lo que tropezó, cómo trabaja según lo que guardó el proxy, y lo que haría con él. Las capturas son la consola real de cada uno en la misma tarea. La TUI que aparece en cada reel viene de una prueba aparte: la misma tarea, el mismo modelo y la misma versión, pero en modo interactivo y acelerada, porque las ejecuciones medidas fueron sin interfaz. Los siete resolvieron la tarea también en esa prueba.
mini-swe-agent: el más simple, el que más resolvió
29 de 39 tareas, 8,79 USD, 9,3 minutos de mediana. Es el arnés de referencia del equipo de SWE-bench, pensado para ser mínimo.
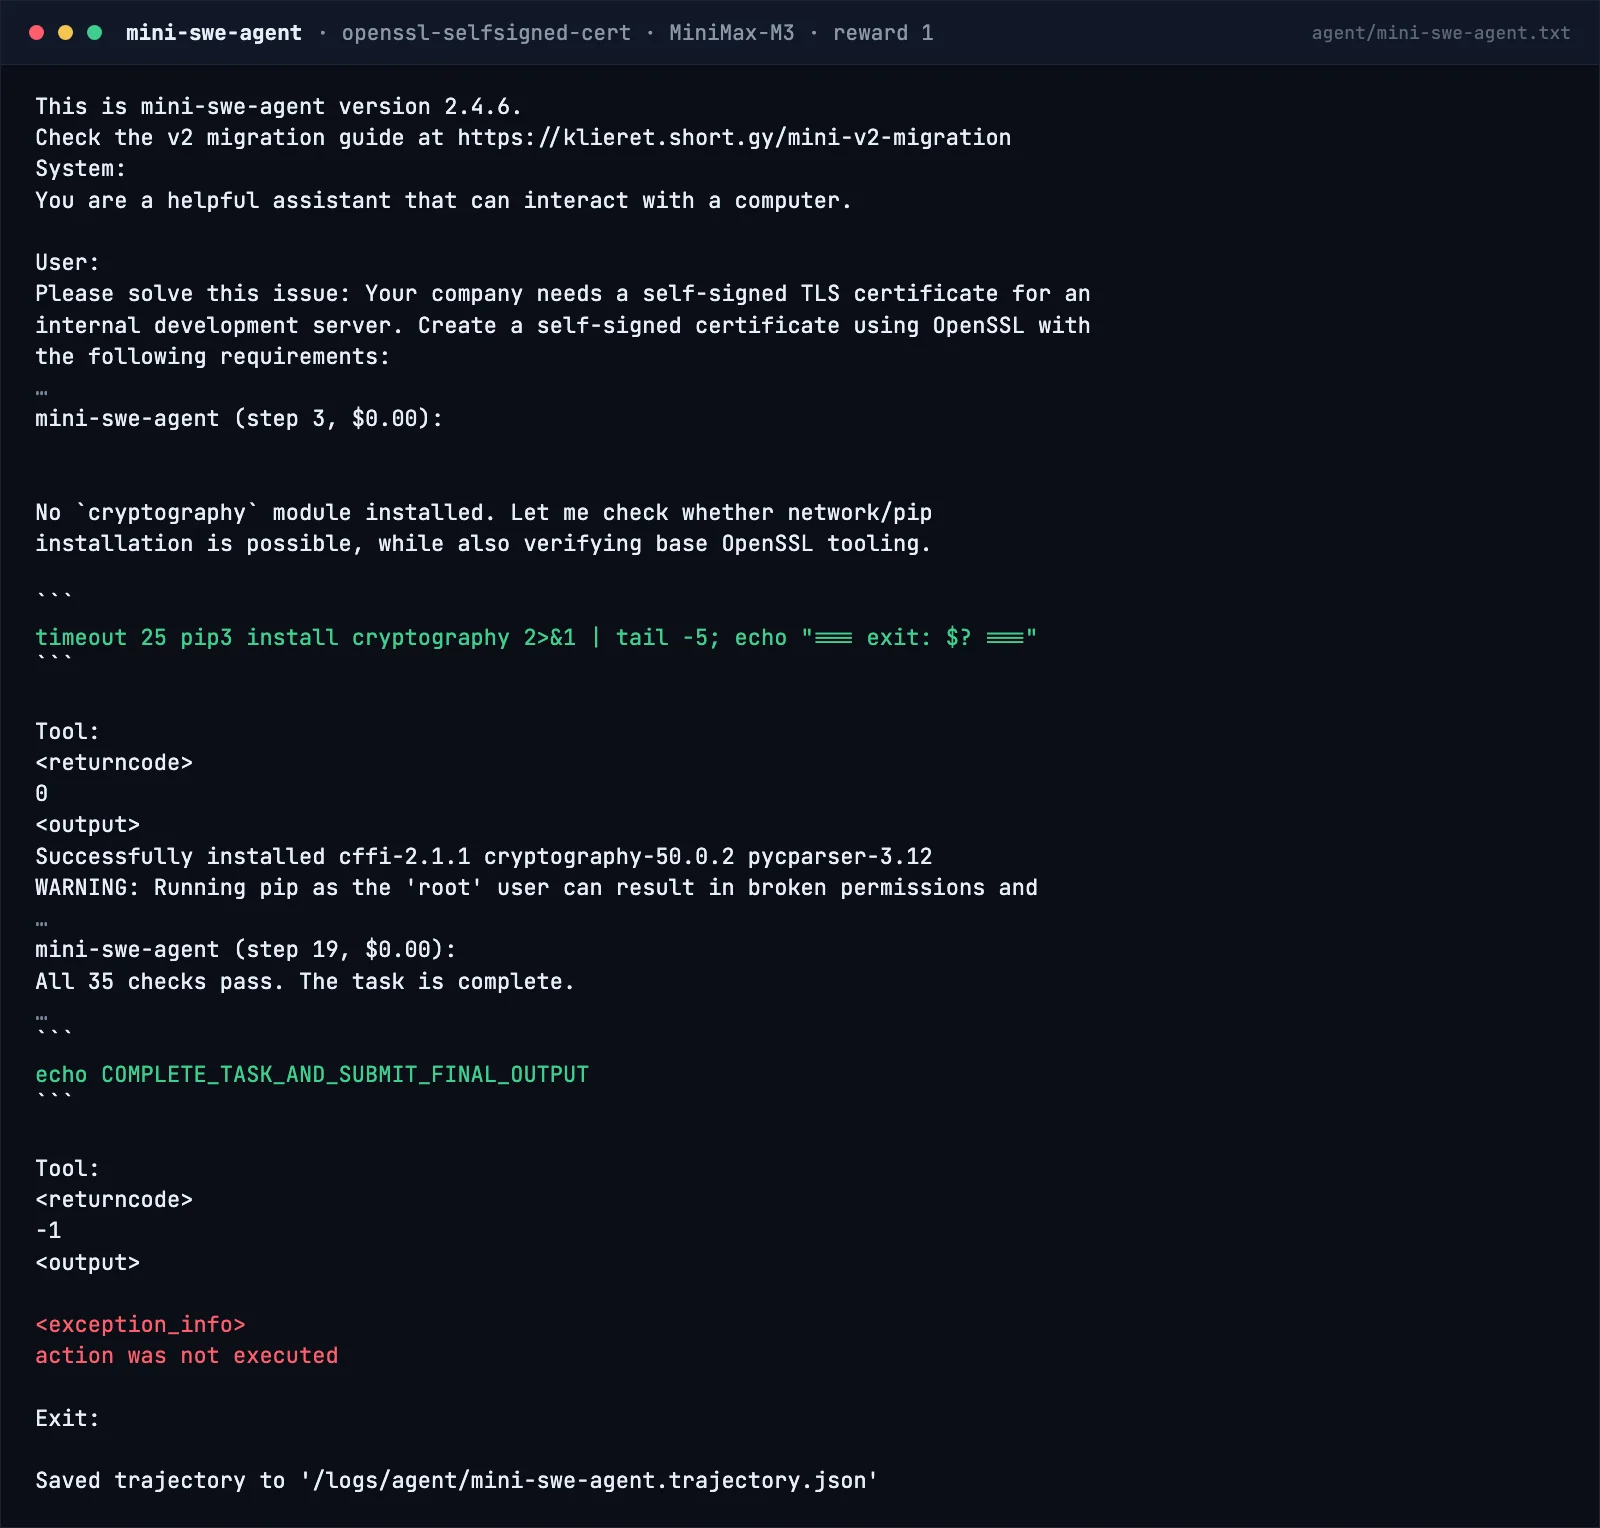
Cómo lo usé. Se instala con uv tool install mini-swe-agent (versión 2.4.6) y habla con MiniMax por el dialecto de OpenAI a través de LiteLLM: --model=openai/MiniMax-M3, con OPENAI_BASE_URL y OPENAI_API_BASE apuntando a la URL compatible con OpenAI, y MSWEA_COST_TRACKING=ignore_errors porque LiteLLM no conoce el precio de MiniMax-M3.
Tropiezos. La versión actual de LiteLLM importa mcp al arrancar y el instalador de Harbor no lo trae: mini-swe-agent se quedaba reintentando cada 4 segundos. Se arregla agregando --with mcp a la instalación. En dos tareas la instalación falló por un espejo de apt a medio sincronizar, y esas dos ejecuciones quedaron como no resueltas.
Cómo trabaja. Su prompt de sistema tiene 64 caracteres. Ofrece una sola herramienta, bash, y toda edición la hace por shell: heredocs, sed, scripts de Python. No usa streaming ni fija temperatura. En las 40 ejecuciones hizo 1.744 llamadas, todas a bash.
Lo que haría con él. Es mi primera opción para un modelo barato que sabe usar la terminal: menos capas, menos contexto gastado en instrucciones, menos cosas que fallen. No tiene memoria, sub-agentes ni interfaz; si necesitas eso, no es para ti.
Codex CLI: el segundo, a pesar de sus tropiezos
26 de 39 tareas, 7,33 USD, 9,3 minutos de mediana.
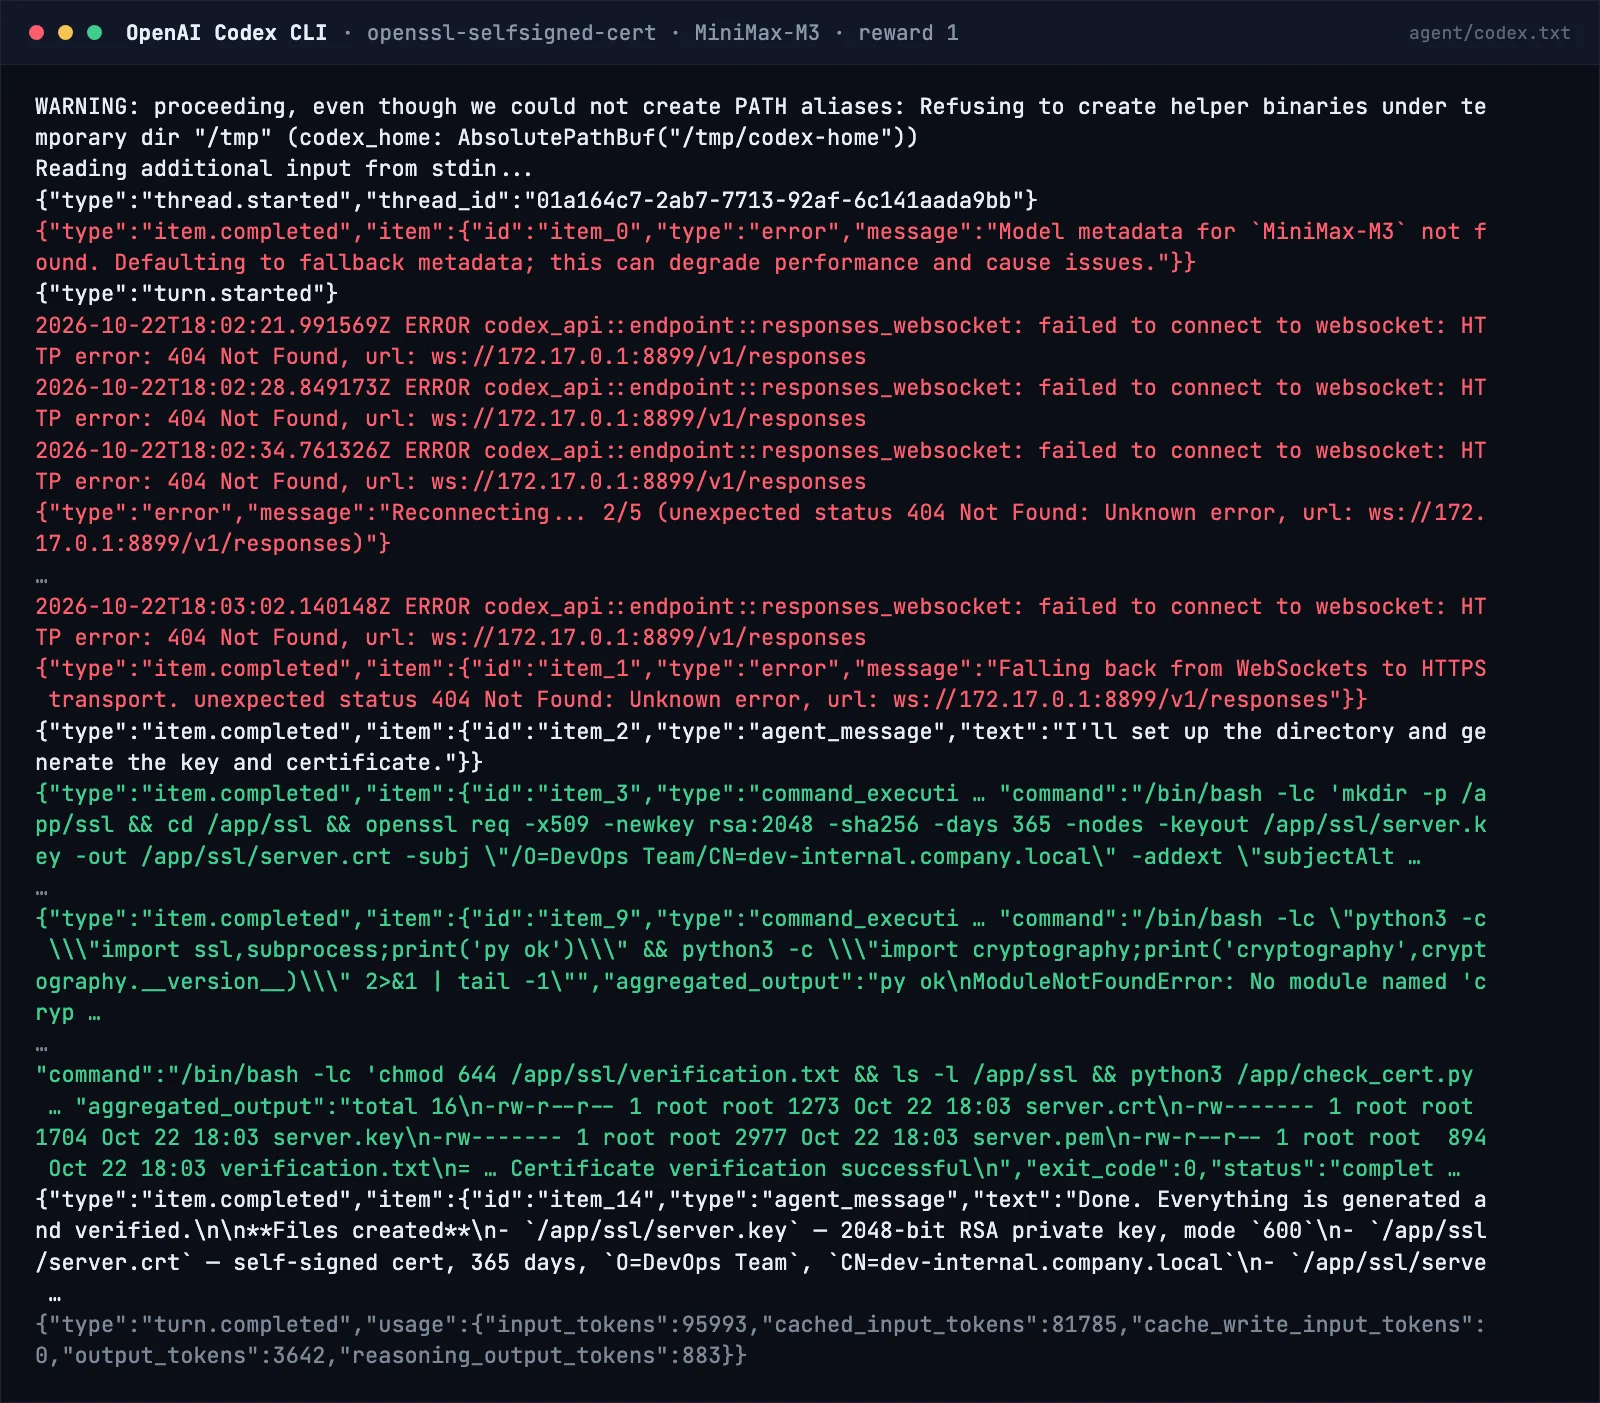
Cómo lo usé. npm install -g @openai/codex (0.163 y luego 0.164) y el dialecto de OpenAI, pero en su API Responses (/v1/responses): es el único de los siete que la usa. Hay que dar OPENAI_BASE_URL y además openai_base_url en config.toml, porque desde la 0.118 Codex solo lee la URL desde ese archivo.
Tropiezos. En 39 ejecuciones avisa que no encuentra los metadatos de MiniMax-M3 y que usará valores genéricos. En 39 intenta primero conectarse por WebSocket, recibe 404 cinco veces y recién entonces pasa a HTTPS. En tres tareas largas murió su compactación de contexto: espera un elemento de compactación que MiniMax no devuelve. Y no le ofrece la herramienta apply_patch a este modelo, así que edita escribiendo archivos por shell.
Cómo trabaja. Prompt de sistema propio de 17.587 caracteres, 1.246 llamadas a exec_command, y algunas llamadas a herramientas que no existen en su lista (read_file, update_plan): el modelo las inventa y Codex las rechaza.
Lo que haría con él. Con todo eso, quedó segundo. Si ya usas Codex, funciona con MiniMax sin parches; cuenta con que las tareas muy largas pueden morir en la compactación.
OpenCode: el más barato y el más rápido
25 de 39 tareas, 4,13 USD, 6,4 minutos de mediana. La mitad del costo de Codex y el menor tiempo de los siete.
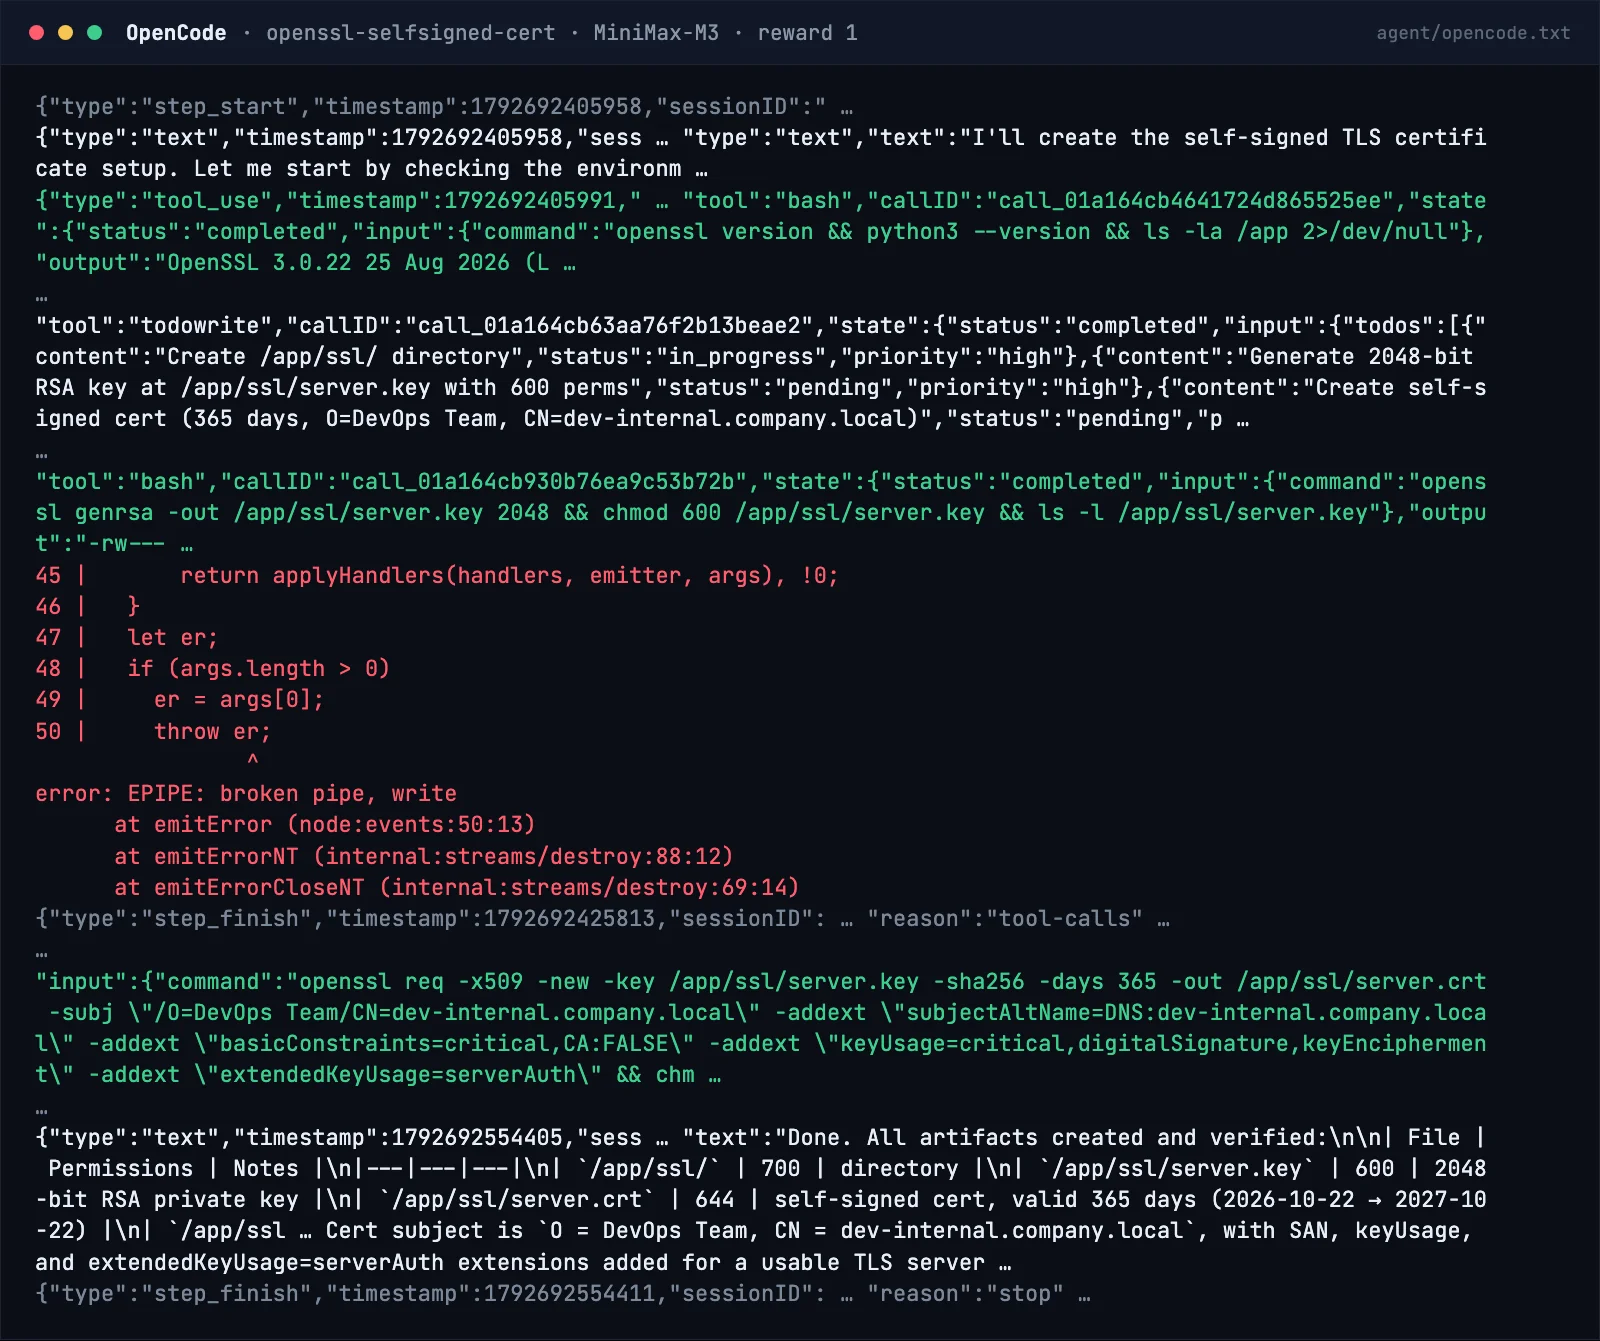
Cómo lo usé. npm i -g opencode-ai (1.19.3 y luego 1.19.4) con el proveedor anthropic y el dialecto compatible con Anthropic. La URL base tiene que terminar en /v1 (ANTHROPIC_BASE_URL=…/anthropic/v1), al revés que Claude Code; sin el /v1 responde 404.
Tropiezos. Con la versión 1.19.4, 11 ejecuciones salieron con código 1 por un EPIPE de Node al cerrar, después de haber terminado el trabajo: 9 de esas 11 igual pasaron las pruebas. Para ponerle título a cada sesión pide un modelo chico, claude-haiku-5-5; MiniMax aceptó ese nombre y respondió con MiniMax-M3.1-Flash. Es una petición por ejecución y costó menos de un centavo en total.
Cómo trabaja. Prompt de unos 9.700 caracteres, 876 llamadas a bash, lista de tareas (todowrite) en las tareas largas, y una instantánea de git por paso. Nunca usó sub-agentes.
Lo que haría con él. Si pagas por token, es el que elegiría: casi el mismo resultado que los primeros a la mitad del costo. Fija la versión, porque cambió en medio de la semana y con ella apareció el EPIPE.
Claude Code: el único que funcionó sin parches
23 de 39 tareas, 7,23 USD, 12,6 minutos de mediana.
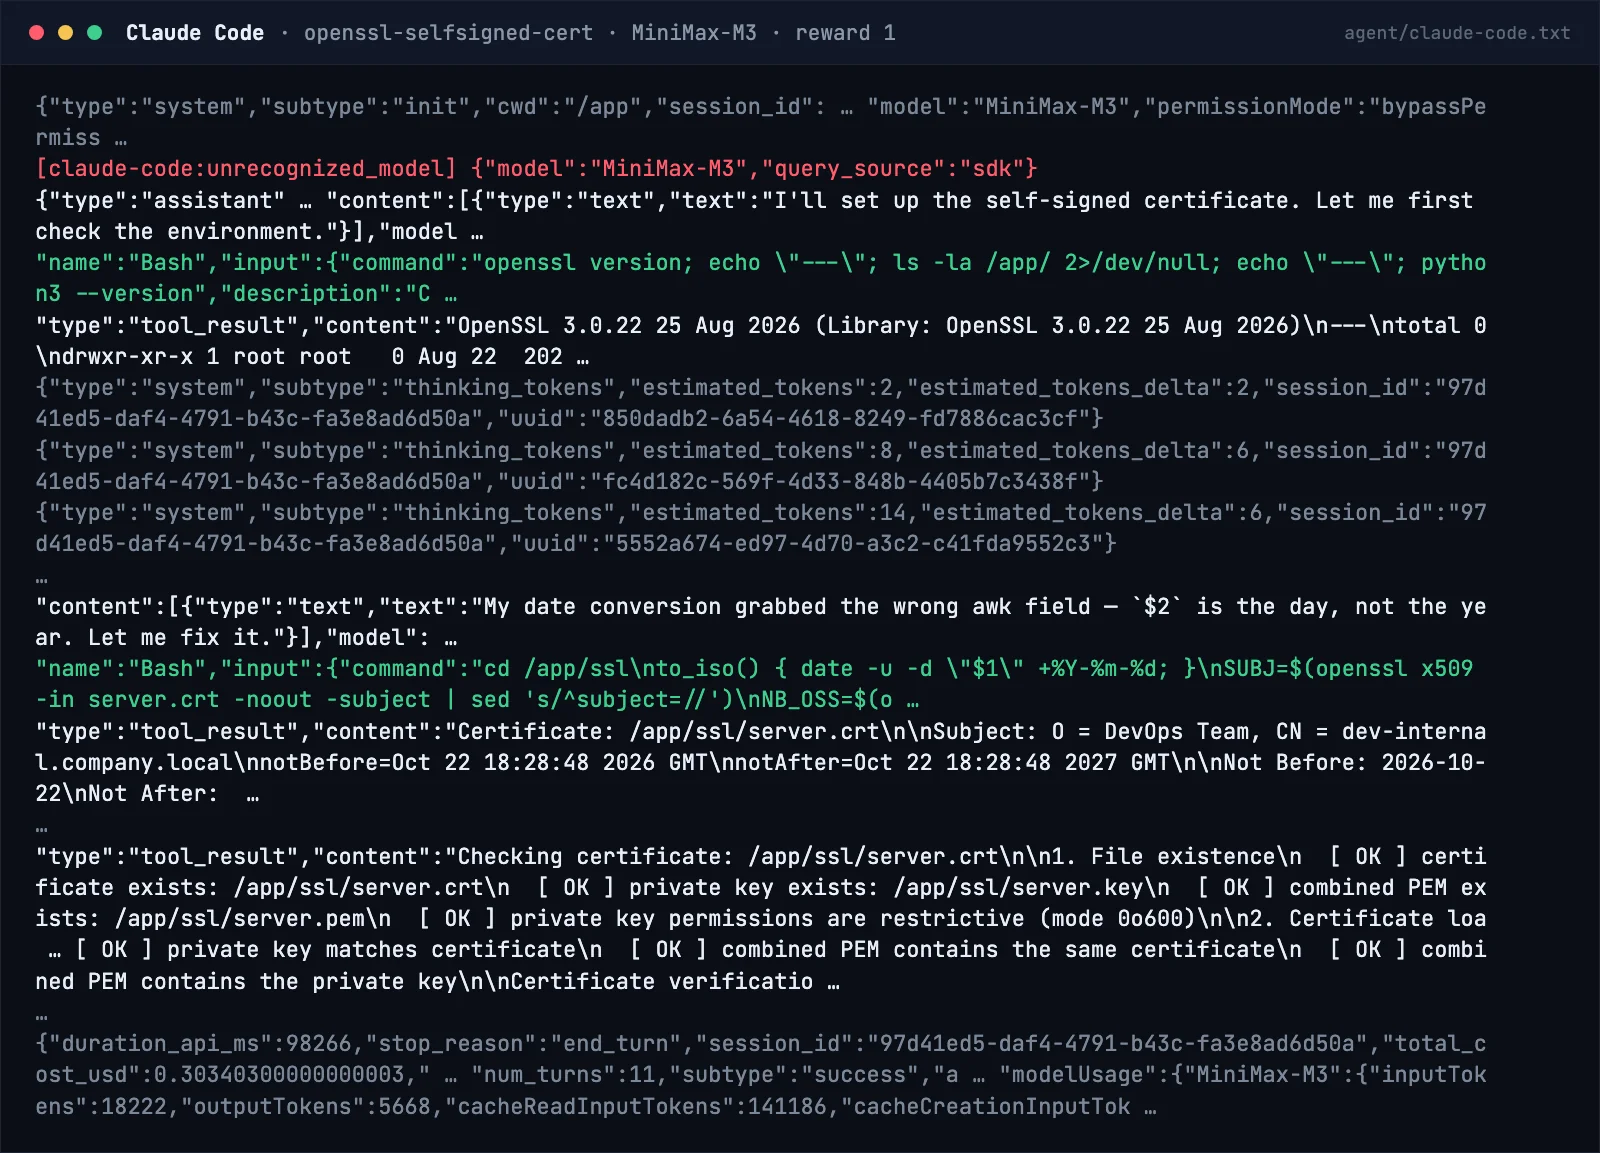
Cómo lo usé. El instalador oficial (versiones 2.1.305 a 2.1.310 a lo largo de la semana) y el dialecto compatible con Anthropic: ANTHROPIC_BASE_URL=…/anthropic, ANTHROPIC_MODEL=MiniMax-M3 y los tres alias ANTHROPIC_DEFAULT_HAIKU_MODEL, …_SONNET_MODEL y …_OPUS_MODEL apuntando también a MiniMax-M3. Con esos alias no hace ninguna llamada a otro modelo.
Tropiezos. Ninguno de configuración: es el único de los siete que no necesitó parche. En una tarea larga el modelo pasó el tope de 32.000 tokens de salida de un turno y la ejecución murió; se puede subir con CLAUDE_CODE_MAX_OUTPUT_TOKENS, pero dejé los valores por defecto para todos.
Cómo trabaja. Ofrece doce herramientas, incluido Agent para sub-agentes, pero con MiniMax-M3 nunca lo usó. El 79 % de sus llamadas fueron a Bash; edita con Edit (reemplazo exacto de texto). Fue el más rápido en la tarea del certificado.
Lo que haría con él. Es el más fácil de conectar a MiniMax y el que menos sorpresas da. Con este modelo no sacó ventaja de lo que lo hace fuerte con los modelos de Anthropic.
OpenClaw: el asistente personal que también programa
22 de 39 tareas, 5,85 USD, 10,7 minutos de mediana.
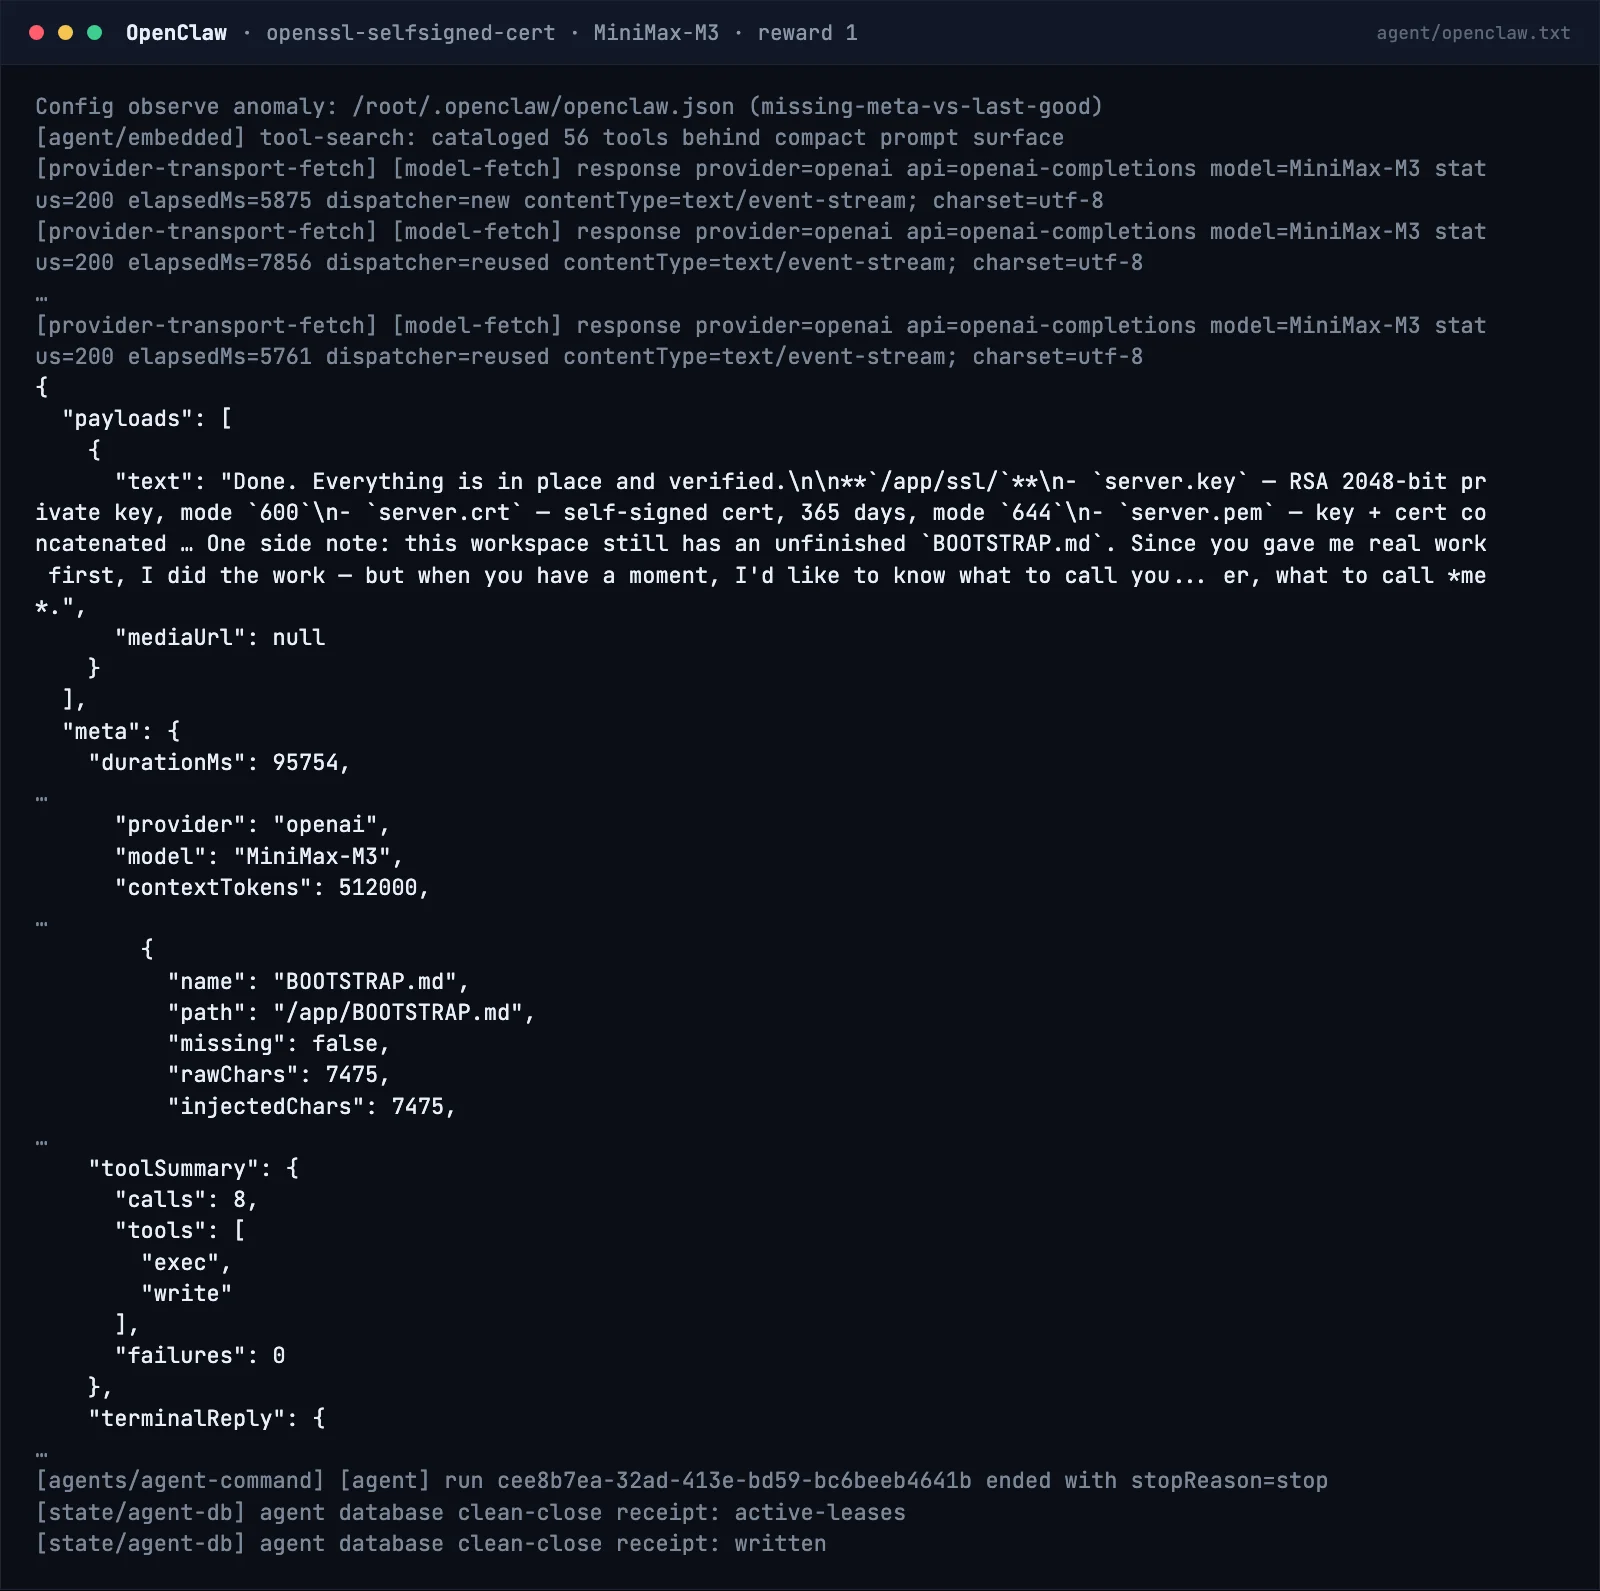
Cómo lo usé. openclaw@2026.10.5, versión fijada, con el dialecto de OpenAI (/v1/chat/completions) y la configuración en ~/.openclaw/openclaw.json.
Tropiezos. Fue el que más costó dejar funcionando. Exige Node 24 y el adaptador de Harbor instala Node 22, tanto para instalar como para ejecutar: lo arreglé con una subclase del adaptador. Sin declarar maxTokens: 32768 y contextWindow: 512000 en el modelo, MiniMax-M3 gastaba todo el tope de salida razonando y devolvía turnos vacíos. Su memoria semántica pidió 378 embeddings a text-embedding-3-small; MiniMax respondió 200 con un error adentro y OpenClaw siguió sin memoria y sin avisar.
Cómo trabaja. Es un asistente personal antes que un agente de código: su prompt de sistema mide unos 50.000 caracteres, el mayor de los siete, y cierra preguntando cómo llamarlo. Aun así, tres de cada cuatro de sus llamadas fueron a exec.
Lo que haría con él. Si ya vives en OpenClaw para otras cosas, programa bien con un modelo barato. Como agente de código dedicado, el costo de configurarlo no se paga con lo que resolvió.
Hermes Agent: muchas herramientas, mucho reintento
22 de 39 tareas, 6,51 USD, 12,5 minutos de mediana.
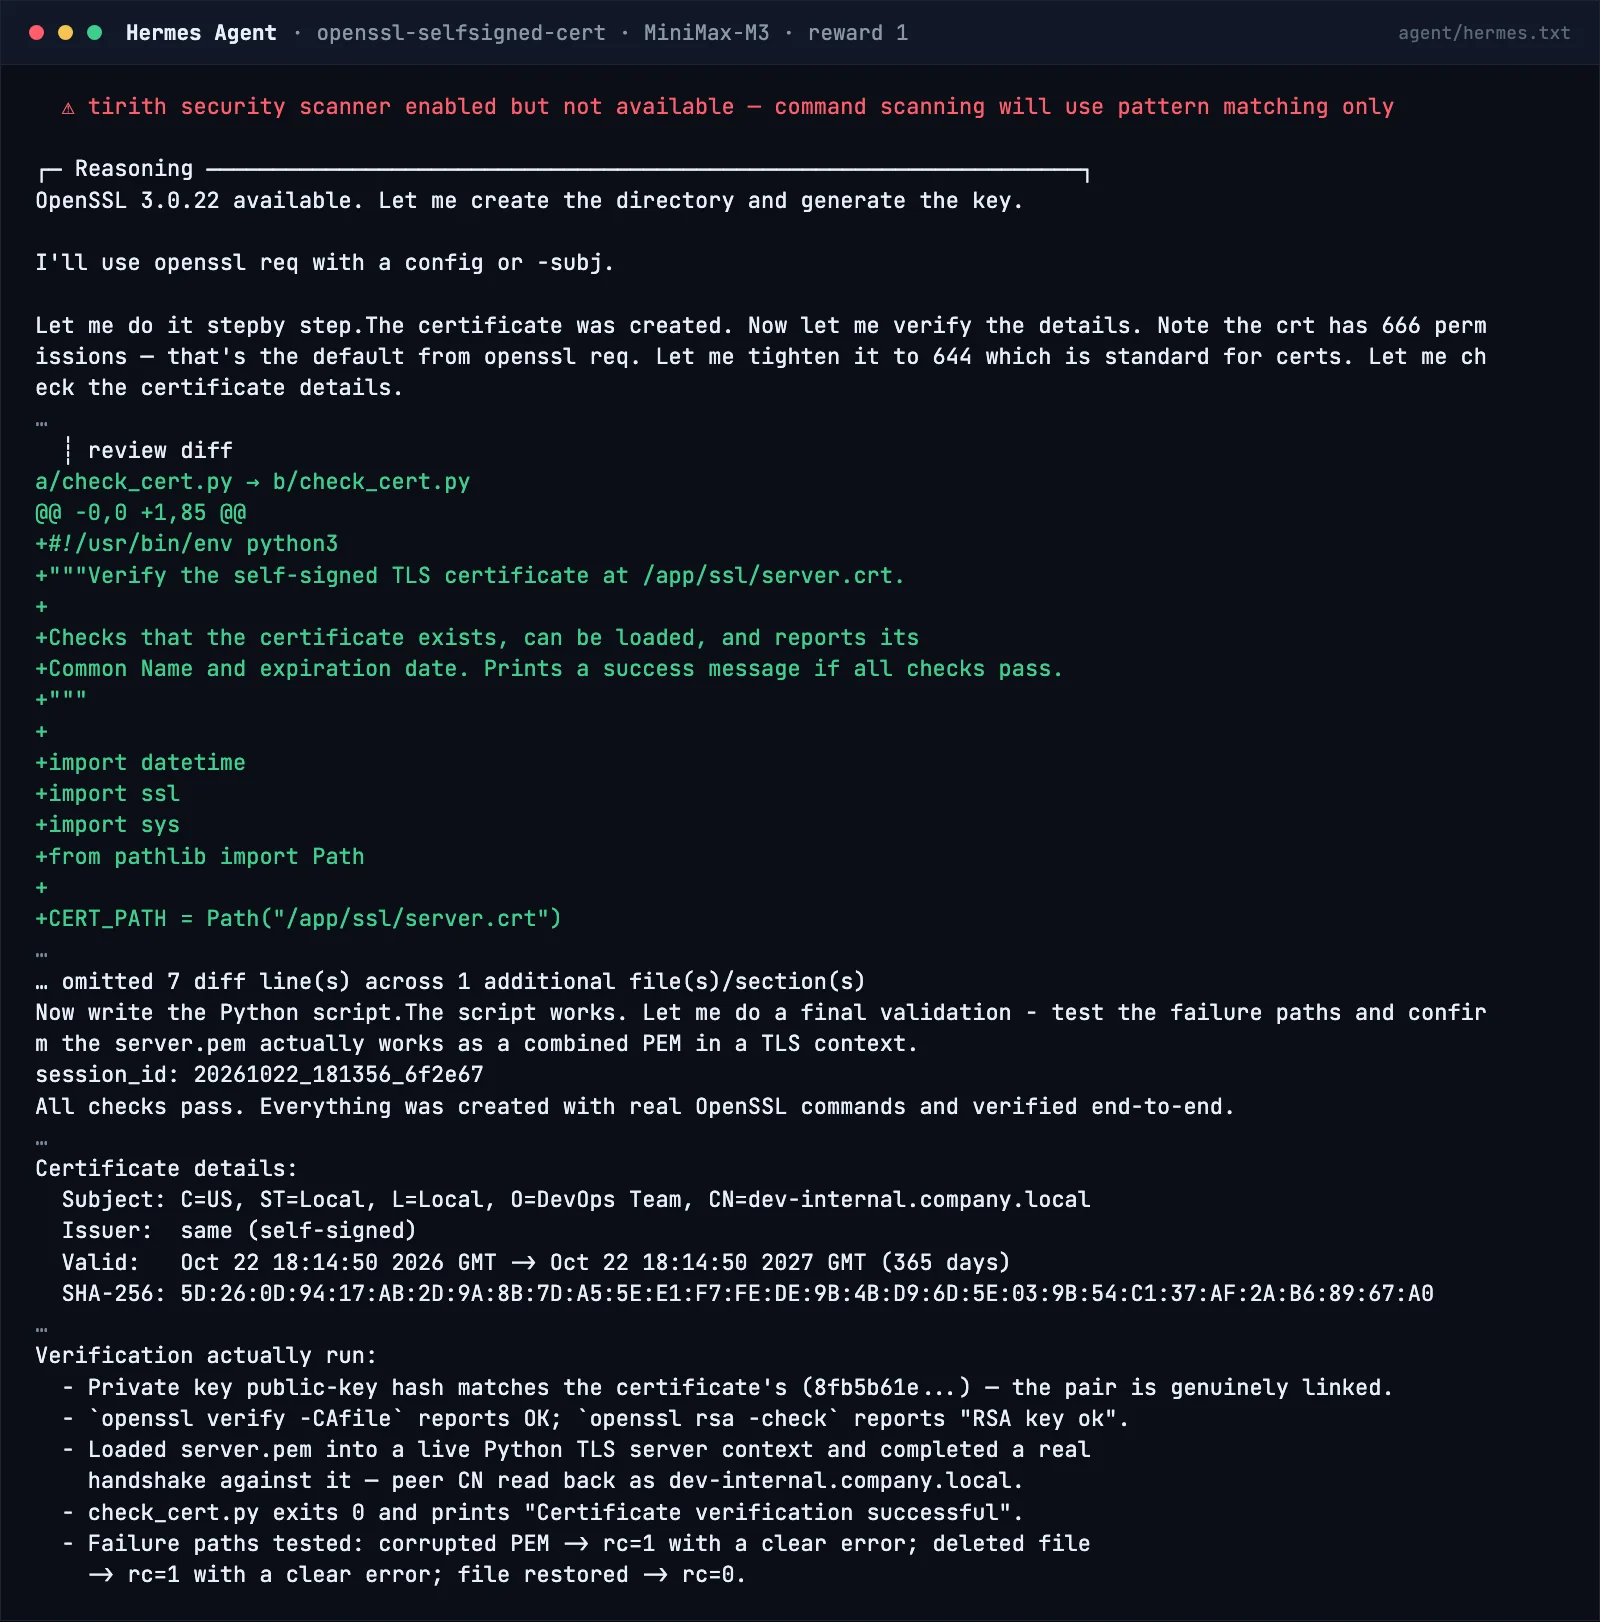
Cómo lo usé. hermes-agent==0.19.0 con uv, versión fijada, proveedor openai-api. La clave tiene que estar en el entorno del proceso que lanza Harbor, no solo pasada al agente.
Tropiezos. El install.sh oficial termina con error por un componente de escritorio que no aplica en un contenedor, y además instalaba una versión sin el comando hermes version que Harbor usa para verificar: lo reemplacé por la instalación con uv y versión fija. En cada ejecución sondea servidores locales tipo Ollama o llama.cpp: 956 respuestas 404 en la semana, que no cuestan tokens pero sí tiempo. Dos ejecuciones llegaron a su tope de 90 iteraciones y una murió tras tres reintentos por sobrecarga de MiniMax.
Cómo trabaja. Diecisiete herramientas, entre ellas terminal, execute_code y patch; llamó a delegate_task solo en dos ejecuciones. Junto con Raven, fue el que más ejecuciones terminó por tiempo o error: 17 de 40.
Lo que haría con él. Es un agente general con memoria, habilidades y tareas programadas; para programar con un modelo barato, esa amplitud no se tradujo en más tareas resueltas.
Raven: el gerente que delega, el más caro
20 de 39 tareas, 12,22 USD, 12,0 minutos de mediana.
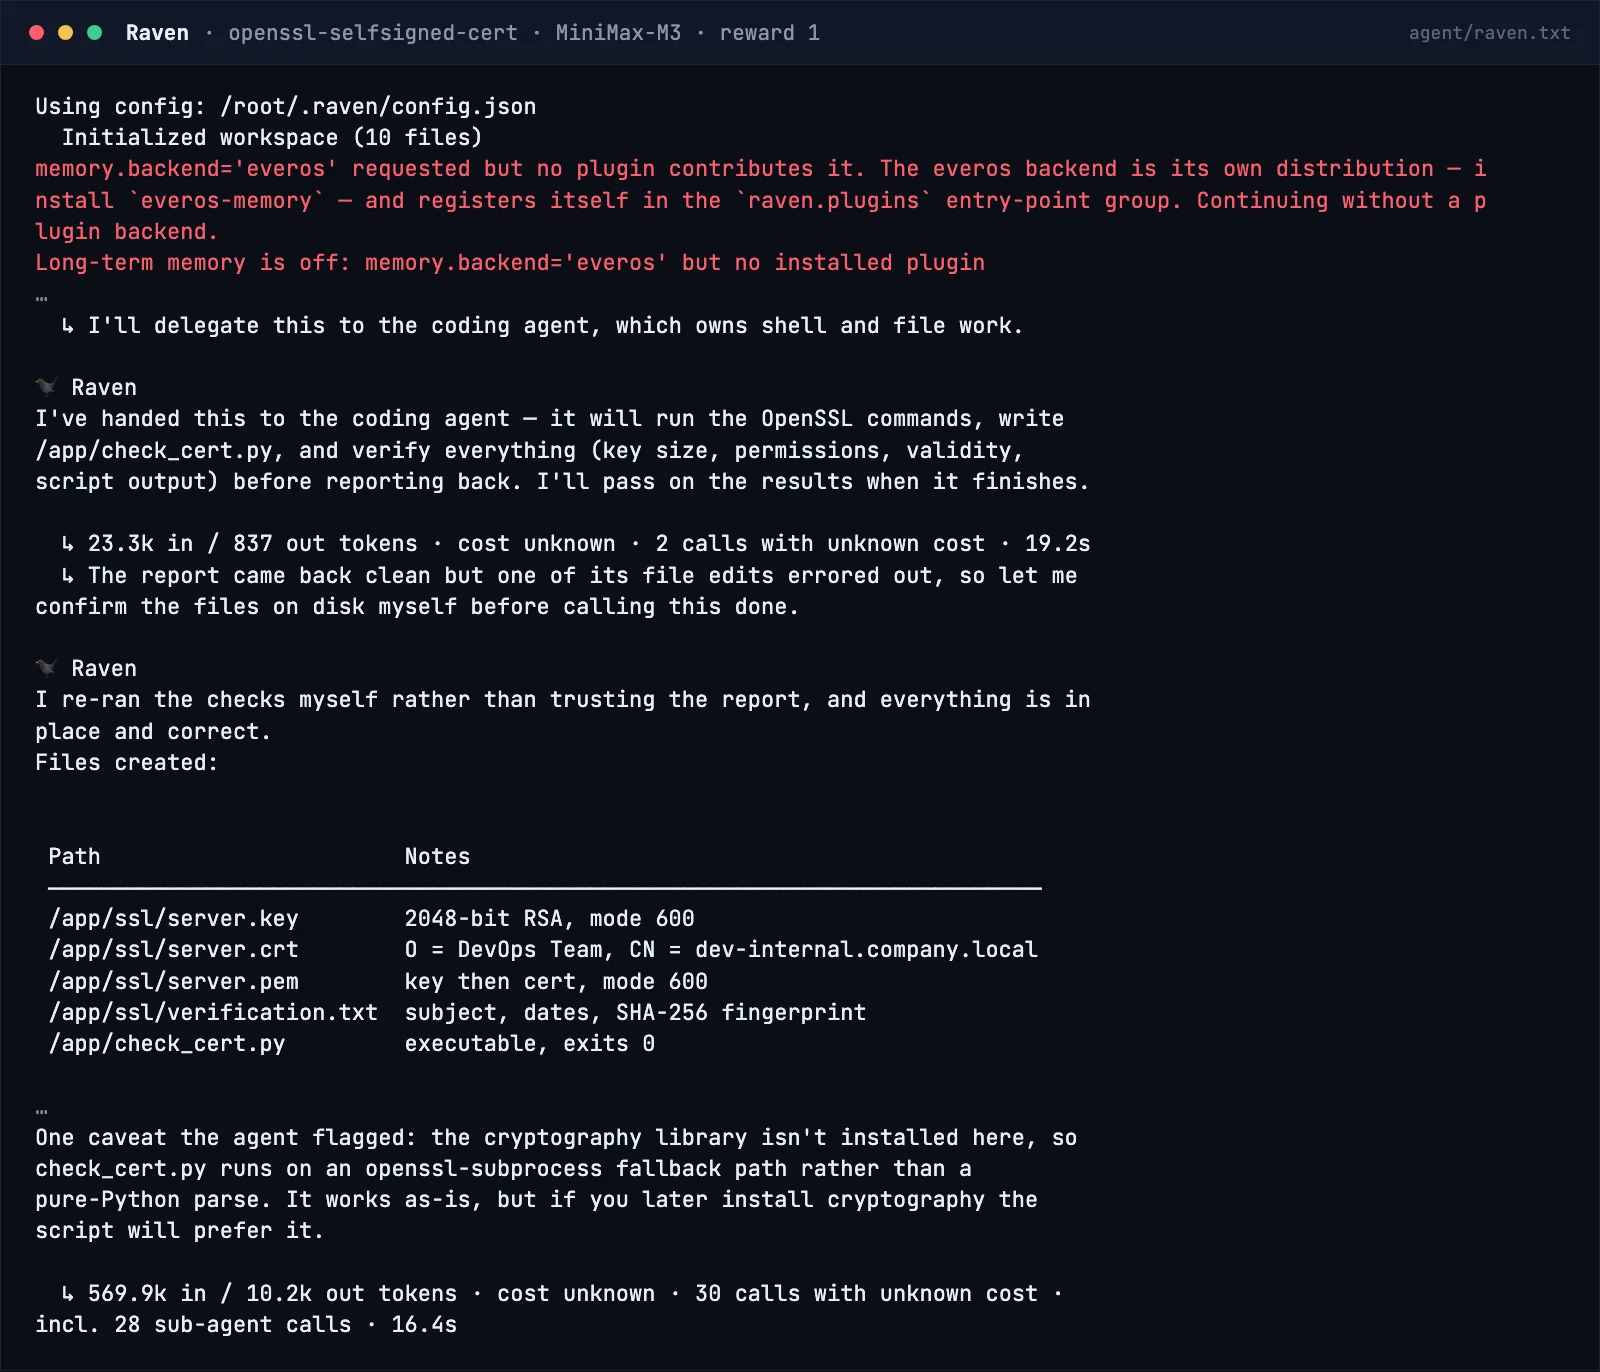
Cómo lo usé. Harbor no trae adaptador para Raven, así que escribí uno, con sus propias pruebas. Raven 0.2.5 fijado por commit, instalado con uv en un entorno aparte, con el proveedor custom compatible con OpenAI y protocol: "chat" forzado.
Tropiezos. La primera versión del adaptador pegaba el export al comando y bash leía las banderas como variables. La instalación es la más lenta de los siete. Su memoria a largo plazo quedó apagada en todas las ejecuciones porque el paquete que la provee se distribuye aparte. Una ejecución la tumbó una caída de DNS de mi red.
Cómo trabaja. Por defecto es un gerente que reparte el trabajo entre sub-agentes: delegó en 34 de 40 ejecuciones, el único que lo hizo de forma sistemática. Además hace llamadas internas al mismo modelo para revisar permisos, titular la sesión, juzgar a sus sub-agentes y clasificar el pedido. Todo eso suma: mediana de 33,5 peticiones por ejecución, la mayor, y el costo más alto.
Lo que haría con él. La delegación tiene sentido con un modelo fuerte y trabajos largos que se pueden repartir. Con un modelo barato y tareas de una sola sentada, cada capa de gestión es contexto y tiempo que no se convierte en tareas resueltas.
Lo que costó
Las 280 ejecuciones costarían unos 52 USD a la tarifa pública de MiniMax-M3. La mayor parte de los tokens son relecturas desde caché del mismo contexto, que es lo que hace barato a un agente largo: la mediana por ejecución va de 330 mil tokens (OpenCode) a 750 mil (Raven). Los contadores de algunos arneses no coinciden con el cable: OpenCode, por ejemplo, anotó 252 mil tokens de salida en las 40 ejecuciones, cuando las respuestas guardadas suman un millón. Por eso todos los números de este post salen de las respuestas guardadas, no de lo que cada arnés dice que gastó.
Amenazas a la validez
- Un solo modelo. Todo vale para MiniMax-M3. Con un modelo de Anthropic u OpenAI el orden puede cambiar, y es razonable que Claude Code o Codex rindan más con el modelo para el que fueron hechos.
- 39 tareas. Alcanzan para ver tendencias, no para separar arneses que difieren en tres o cuatro tareas.
- Versiones que cambiaron. La ficha decía «versiones fijadas», pero los adaptadores de Harbor de Claude Code, Codex, OpenCode y mini-swe-agent instalan la última versión, y las tres primeras cambiaron durante la semana. OpenClaw, Hermes y Raven sí quedaron fijos.
- Selección de tareas. Excluí las diez que la solución de referencia no pasa aquí; eso puede dejar tareas algo más fáciles que el promedio del benchmark.
- Errores de infraestructura dentro del análisis. Dos instalaciones fallidas de mini-swe-agent y una caída de DNS que afectó a Raven quedaron contadas como no resueltas.
- Llamadas auxiliares. OpenCode pidió títulos a un modelo chico y OpenClaw intentó embeddings; pesan menos de un centavo, pero no son estrictamente el mismo modelo.
- El juez. Fue inconsistente en la tarea de la solución a la vista; en el resto coincidió con el barrido automático.
Veredicto
Con un modelo barato como MiniMax-M3, el arnés importa menos de lo que parece y lo elaborado no ayuda: el más simple, mini-swe-agent, resolvió más que ninguno sin que ninguna diferencia llegue a ser significativa con 39 tareas. Si buscas el mejor equilibrio entre lo que resuelve y lo que cuesta, OpenCode. Si quieres conectar sin pelear, Claude Code. Codex rinde bien pese a sus avisos. OpenClaw y Hermes son agentes generales que también programan. Raven, con su gerencia de sub-agentes, fue el más caro y el que menos resolvió con este modelo. Siguen SWE-bench Verified y Aider Polyglot con los mismos siete, y actualizaré esta tabla.
Preguntas frecuentes
¿OpenCode vs Claude Code vs Codex: cuál resuelve más tareas con el mismo modelo?
Con MiniMax-M3 en 39 tareas de Terminal-Bench 2.0, Codex CLI resolvió 26, OpenCode 25 y Claude Code 23. Las diferencias entre los tres caben en el ruido: con 39 tareas, ninguna comparación entre dos arneses fue significativa después de corregir por las 21 comparaciones posibles.
¿Cuál es el mejor arnés de agentes para un modelo barato como MiniMax M3?
En esta medición, el más simple: mini-swe-agent, con una sola herramienta (bash) y un prompt de sistema de 64 caracteres, resolvió 29 de 39 tareas, el máximo. No rindió peor que ninguno. Pero la diferencia con los demás no alcanza a ser significativa con 39 tareas: lo que se puede afirmar es que un arnés más elaborado no ayudó a este modelo.
¿Hermes Agent vs Claude Code en un benchmark?
Con MiniMax-M3, Hermes Agent resolvió 22 de 39 tareas y Claude Code 23, con costos parecidos (6,51 y 7,23 USD equivalentes por las 40 ejecuciones). Hermes tuvo 17 ejecuciones terminadas por tiempo o error y sondeó servidores locales de modelos en cada ejecución.
¿Cuánto cuesta ejecutar un benchmark de agentes con MiniMax M3?
Las 280 ejecuciones costarían unos 52 USD a la tarifa pública de MiniMax-M3, recontando los tokens desde las respuestas guardadas: de 4,13 USD (OpenCode) a 12,22 USD (Raven) por arnés y 40 tareas. La mayor parte son tokens leídos desde caché. Yo lo ejecuté con el plan de tarifa fija de MiniMax.
¿Los agentes hicieron trampa en Terminal-Bench?
Revisé las 174 tareas aprobadas: un barrido automático igual para todos y un juez ciego que no sabía qué arnés miraba. 171 fueron legítimas. Las otras 3 son de una misma tarea, fix-code-vulnerability, cuyo repositorio deja la solución a la vista con git diff; los siete arneses la miraron, así que la saqué de la comparación para todos.
¿Cómo conecto Claude Code, Codex u OpenCode a MiniMax?
MiniMax tiene dos dialectos. Claude Code y OpenCode usan el compatible con Anthropic (ANTHROPIC_BASE_URL; OpenCode exige la ruta terminada en /v1). Codex usa el compatible con OpenAI en su API Responses (OPENAI_BASE_URL y openai_base_url en config.toml). El método completo de cada uno, con los tropiezos, está en el post.
¿Puedo reproducirlo?
Sí. La ficha con la regla de decisión escrita antes de medir y sus nueve enmiendas, el arnés de Raven, el proxy que registra, los scripts de análisis, la auditoría y los resultados por ejecución están en el repositorio y en un gist enlazado en las fuentes.
Fuentes
- Terminal-Bench y Harbor, el ejecutor oficial.
- Los arneses: Claude Code (repo), Codex CLI, OpenCode (repo), OpenClaw (repo), Hermes Agent (repo), mini-swe-agent (repo) y Raven.
- MiniMax: API compatible con Anthropic.
- La ficha, el proxy, el adaptador de Raven, los scripts de análisis, la auditoría y los resultados por ejecución.
Medido del 20 al 24 de octubre de 2026 en una máquina con NixOS, una ejecución a la vez. Harbor 0.24.0, Terminal-Bench 2.0 (40 tareas, semilla 17), MiniMax-M3. Claude Code 2.1.305–2.1.310, Codex CLI 0.163–0.164, OpenCode 1.19.3–1.19.4, OpenClaw 2026.10.5, Hermes Agent 0.19.0, mini-swe-agent 2.4.6, Raven 0.2.5 (05cf9c35). 280 ejecuciones; 174 aprobadas revisadas por un juez ciego.
BOLETÍN · MEDIDO
Una medición nueva, cuando la hay.
Cada post con sus números, sus fallos y los scripts para repetirlo. Entre uno y tres correos al mes. Te das de baja con un clic.
LO ÚLTIMO QUE LLEGÓ
- 7 arneses con MiniMax-M329 de 39 con el arnés más simple
- runc vs gVisor vs KataKata arranca 27× más lento
- ComfyUI vs Forge en 16 GB2× con Z-Image
Uso Listmonk en mi propio servidor; tu correo no sale de ahí. Confirmas por correo antes de recibir nada.
Comentarios
Todavía no hay comentarios. El primero es tuyo.