
ComfyUI vs Forge en una GPU de 16 GB: empatan en SDXL y ComfyUI es el doble de rápido con Z-Image, cuando los modelos no caben
Medí ComfyUI, Forge Neo y el Forge original con los mismos archivos, semillas y ajustes en una RTX 4070 Ti SUPER, con diffusers como línea base. Con SDXL empatan en 6,7 s por imagen. Con Z-Image Turbo, que no cabe junto a su codificador de texto, ComfyUI tarda 6,75 s y Forge Neo 13,4 s; con Qwen-Image fp8, 75,7 s contra 96,0 s. Los logs apuntan a cómo cada uno gestiona la memoria entre la RAM y la GPU.
Uso ComfyUI para las imágenes y los videos del estudio en esta tarjeta de 16 GB, y nunca lo había comparado con Forge en la misma máquina. Lo que encuentro sobre cuál de los dos es más rápido son videos y opiniones. Casi nadie corre las dos herramientas con los mismos archivos, la misma semilla y los mismos ajustes, y anota el tiempo.
Antes de medir encontré lo primero: el Forge original tiene su último commit en la rama principal el 26 de junio de 2025, y su código solo trae motores para SD 1.5, SD 2, SDXL, SD 3.5, Flux y Chroma. Su continuación es Forge Neo, que corre Z-Image, Qwen-Image y Wan 2.2. Así que comparé ComfyUI con Forge Neo en todo, y con el Forge original solo donde puede: SDXL.
Qué medí, y con qué reglas
Antes de la primera corrida dejé escrita una ficha con los modelos, los ajustes, las métricas y la regla de decisión, y la fui enmendando por escrito antes de cada cambio.
- Herramientas: ComfyUI v0.41.3 y Forge Neo (commit f7f23149), las dos con PyTorch 2.13 y Python 3.12, sin xformers, SageAttention ni FlashAttention. El Forge original (commit dfdcbab6) corre con su propia pila, PyTorch 2.3.1 y Python 3.10, la que trae su instalador.
- Modelos: SDXL base 1.0 en fp16 (1024², 30 pasos, Euler, CFG 7). Z-Image Turbo en bf16 con su codificador Qwen3 de 4B (1024², 8 pasos, res_multistep, CFG 1, shift 3). Qwen-Image 2512 en fp8 con su codificador Qwen2.5-VL de 7B (1328², 20 pasos, Euler, CFG 4, shift 3,1). Los mismos archivos en todas las herramientas.
- Imágenes: 12 prompts fijos y 3 semillas, 36 imágenes pareadas por herramienta y modelo, en bloques intercalados (ComfyUI, Forge, ComfyUI, Forge…) con el servidor reiniciado entre bloques.
- Tiempo: un cronómetro externo alrededor de cada petición HTTP completa, hasta tener el PNG en la mano. Aparte, el arranque en frío: desde que lanzo el proceso hasta la primera imagen (con el proceso reiniciado, no con la caché de disco vacía).
- Memoria: el pico de VRAM de toda la tarjeta y el de RAM del árbol de procesos del servidor, muestreados cada 100 ms.
- Regla: una herramienta es «más rápida» si el intervalo de confianza del 95 % de la mediana de la razón de tiempos excluye 1 y la diferencia es de al menos 5 %; «empatan» si el intervalo cabe entero en ±5 %.
- Línea base: diffusers sin interfaz, con ajustes lo más parecidos posible, como referencia de cuánto cuesta generar con otra biblioteca. Es otro motor, así que no aísla el costo de la interfaz.
Lo que se rompió antes de medir
- El puerto 8188 ya estaba ocupado, por el ComfyUI de producción de esta máquina. La primera prueba le habló a ese servidor, que no tiene estos modelos, y respondió con error. ComfyUI medido corre en el 8288.
- La caché de ComfyUI me falseó el primer tiempo. En la prueba de humo, la primera imagen medida tardó 0,05 s: el calentamiento usaba el mismo prompt y la misma semilla, y ComfyUI reutiliza las salidas de los nodos cuyas entradas no cambiaron. Forge no tiene esa caché. Lo corregí antes de medir: el calentamiento usa un prompt fuera del set, y los pares van ordenados de modo que dos peticiones seguidas nunca comparten prompt, así ninguna herramienta reaprovecha la codificación de texto de la anterior. Es una ventaja real de ComfyUI cuando repites un prompt, pero no la medí.
- NixOS: Triton busca la librería de CUDA con
/sbin/ldconfig, que ahí no existe, y Python no encontraba los certificados para bajar archivos. Lo resolví conTRITON_LIBCUDA_PATHySSL_CERT_FILE.
Velocidad: empatan mientras el modelo cabe
SDXL · 1024², 30 pasos · cabe en la tarjeta tiempo real
Z-Image Turbo · 1024², 8 pasos · 19 GiB de modelos para 16 GB ×2 acelerado
Qwen-Image 2512 fp8 · 1328², 20 pasos · 28 GiB de modelos para 16 GB ×12 acelerado
Con SDXL no hay diferencia. ComfyUI y Forge Neo tardan 6,71 s por imagen, y el Forge original 6,76 s. Las tres comparaciones empatan con la regla: ComfyUI contra Forge Neo da una razón de 1,004, con un intervalo de 0,997 a 1,007. La línea base, diffusers solo, tarda 6,85 s, un 2 % más que las herramientas.
Con Z-Image Turbo, ComfyUI tardó 6,75 s y Forge Neo 13,4 s: la razón es 0,506, con un intervalo de 0,502 a 0,510. Con Qwen-Image fp8, 75,7 s contra 96,0 s: 0,787, de 0,785 a 0,788. En los dos casos ComfyUI es más rápido según la regla. La variación de imagen a imagen es baja: entre el percentil 10 y el 90, las herramientas se alejan de su mediana un 4 % como mucho (Forge Neo con Z-Image); diffusers con Z-Image llega a 15 %. La excepción es la primera imagen medida de cada bloque en Forge Neo: con Z-Image tardó entre 14,7 y 29,5 s y con Qwen-Image entre 126 y 171 s, porque el calentamiento no lo deja en régimen. Son 3 de 36 imágenes y no cambian la mediana.
Por qué: los pesos, entre la RAM y la GPU
SDXL cabe entero en la tarjeta. Z-Image Turbo no: su modelo de difusión pesa 11,5 GiB en disco y su codificador de texto 7,5 GiB. Qwen-Image tampoco: 19 GiB de modelo y 8,7 GiB de codificador. Cada herramienta tiene que decidir qué tiene en la GPU y cuándo.
Los logs muestran dos estrategias distintas. ComfyUI v0.41 anota que prepara cada modelo para «dynamic VRAM loading», que usa «async weight offloading with 2 streams» y, desde la primera imagen, «0 models unloaded»: su contador de descargas de modelos queda en cero. Eso no significa que no mueva pesos, solo que no lo hace descargando modelos. Forge Neo, en cada imagen, anota tres líneas «Moving model(s) has taken X seconds» y descargas parciales de varios GB («Unloaded partially»); ese cronómetro cubre toda la gestión de memoria al cargar modelos, no solo las copias. Con Z-Image esas tres líneas suman una mediana de 7,2 s por imagen, y la diferencia entre las dos herramientas es de 6,6 s: los dos números son del mismo tamaño, lo que es consistente con que esa gestión explique la brecha. Con Qwen-Image suman 9,4 s de una diferencia de 20,3 s; el resto supongo que viene de calcular con parte del modelo todavía en la RAM, pero eso no lo medí.
La línea base va en la misma dirección. diffusers, cuando el modelo no cabe, mueve modelos enteros entre la RAM y la GPU (enable_model_cpu_offload), y con Z-Image tardó 15,8 s por imagen: más que Forge Neo y más del doble que ComfyUI.
Calidad: prácticamente la misma imagen
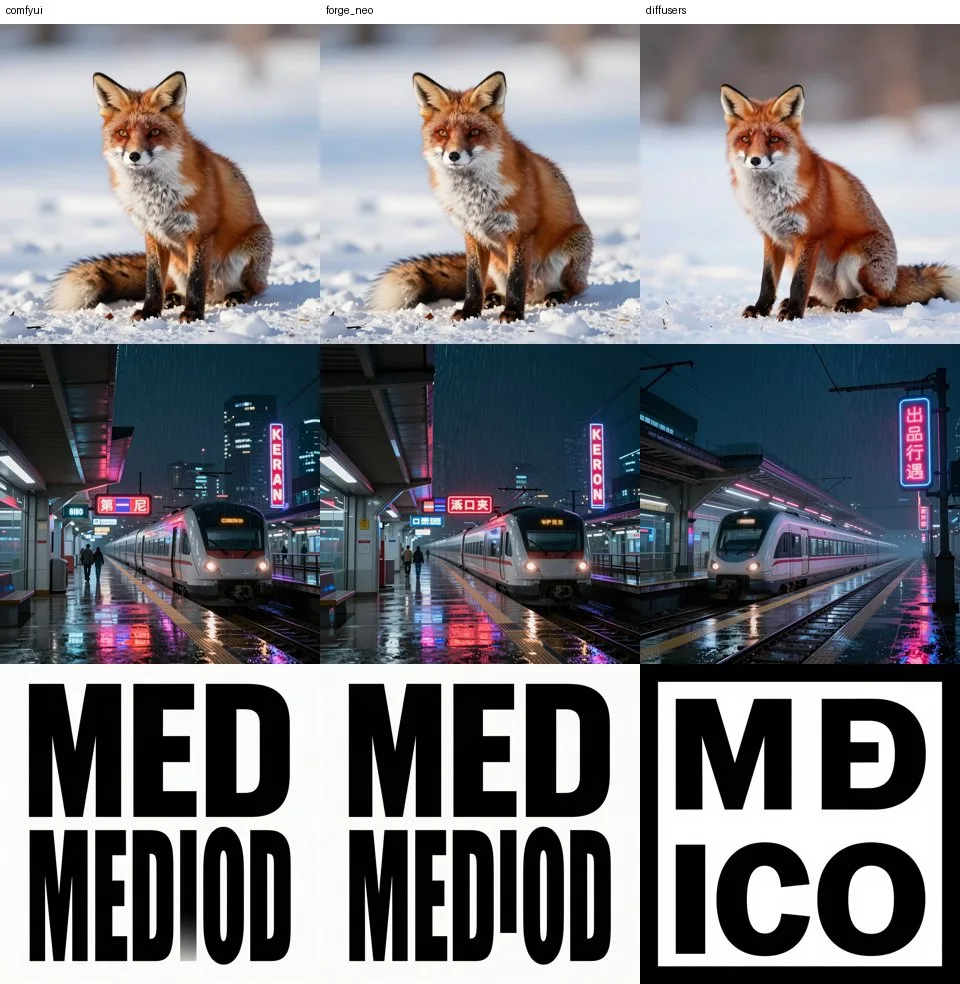
Con la misma semilla, ComfyUI y Forge Neo dan prácticamente la misma imagen en los tres modelos, con diferencias en detalles y en el texto dibujado, señal de que generan el ruido inicial igual. El Forge original y diffusers dan otra composición con la misma semilla, igual de válida. El puntaje CLIP de cada imagen contra su prompt va de 24 a 42 según la imagen, y su promedio por herramienta quedó entre 30,0 y 30,9. CLIP mide cuánto se parece la imagen al texto, no su calidad estética: lo único que puedo decir es que los promedios quedaron próximos en este conjunto, sin prueba de equivalencia.
Arranque en frío y memoria
Desde que lanzo el proceso hasta la primera imagen, ComfyUI fue más rápido en los dos modelos que no caben: con Z-Image, entre 24 y 29 s contra 37 a 55 s de Forge Neo; con Qwen-Image, entre 100 y 121 s contra 127 a 147 s. Con SDXL, todas tardan entre 10 y 23 s.
En memoria de video, ComfyUI llega más cerca del techo: 15,5 GiB de pico con Z-Image y con Qwen-Image, contra 13,9 y 14,2 GiB de Forge Neo. En RAM del sistema van parejos: unos 21 GiB con Z-Image en las dos, y 25,6 contra 27,1 GiB con Qwen-Image. Esta máquina tiene 31 GB de RAM, así que Qwen-Image fp8 la deja casi llena.
Una curiosidad: Wan 2.2
Corrí un solo clip de video por herramienta, con la receta que ya uso en esta tarjeta: Wan 2.2 A14B en GGUF Q5_K_M (modelos de ruido alto y bajo), 832x480, 81 cuadros (5 s a 16 fps), 20 pasos con el cambio de modelo en el 10. ComfyUI tardó 877 s y Forge Neo 932 s, y los dos videos se parecen mucho (cuadro a los 2,5 s de cada uno en el gist). En una primera corrida Forge Neo cambió de modelo en el paso 18 y no en el 10, porque por defecto mide ese cambio por nivel de ruido y no por pasos; lo detectó la auditoría y repetí su clip con el cambio por pasos. Es un solo clip por herramienta, así que no alcanza para afirmar que uno sea más rápido.
Amenazas a la validez
- Una sola tarjeta, una sola máquina con 31 GB de RAM y un sistema (NixOS). Con más RAM o una tarjeta de 24 GB el orden puede cambiar.
- Las dos herramientas cambian cada semana. Lo medido vale para las versiones fijadas; Forge Neo puede incorporar algo parecido a la carga dinámica de ComfyUI.
- Usé los ajustes por defecto de cada herramienta, y no son simétricos: ComfyUI usa por defecto el asignador
cudaMallocAsyncy Forge Neo el nativo. Forge Neo sugiere en su log--cuda-mallocy tiene--pin-shared-memoryy--cuda-stream; no los probé. - El orden de los bloques fue fijo (ComfyUI primero) y solo hubo tres reinicios por herramienta; no controlé temperatura ni frecuencia de la tarjeta.
- El Forge original solo lo medí con SDXL, y con otra versión de PyTorch.
- La línea base de Z-Image usa el repositorio oficial en formato diffusers y su planificador por defecto, porque diffusers no tiene res_multistep; no hay línea base para Qwen-Image fp8.
- La explicación por la gestión de memoria se apoya en los tiempos que anotan los propios logs, no en un experimento que la cambie.
- Wan 2.2 es una sola corrida por herramienta.
Veredicto
En esta tarjeta de 16 GB y con estos modelos: con SDXL, que cabe entero, da lo mismo ComfyUI, Forge Neo o el Forge original en tiempo, y ComfyUI y Forge Neo dan además prácticamente la misma imagen con la misma semilla. Con Z-Image Turbo y Qwen-Image fp8, que no caben, ComfyUI fue más rápido: el doble con Z-Image y 21 % menos de tiempo por imagen con Qwen-Image, y sus logs apuntan a cómo gestiona la memoria. Forge Neo sigue siendo la forma de usar Forge con estos modelos, y el Forge original quedó atrás.
Preguntas frecuentes
¿ComfyUI vs Forge: cuál es más rápido?
Depende de si el modelo cabe en la tarjeta. Con SDXL, que cabe entero en 16 GB, ComfyUI, Forge Neo y el Forge original empatan: 6,71, 6,71 y 6,76 segundos por imagen. Con Z-Image Turbo, cuyo modelo y codificador de texto suman 19 GiB, ComfyUI tardó 6,75 s y Forge Neo 13,4 s. Con Qwen-Image en fp8, unos 28 GiB entre modelo y codificador, 75,7 s contra 96,0 s.
¿Por qué ComfyUI es más rápido cuando el modelo no cabe?
Los logs apuntan a la gestión de memoria. ComfyUI v0.41 anota «dynamic VRAM loading» y su contador de descargas queda en «0 models unloaded»; Forge Neo anota en cada imagen tres líneas «Moving model(s) has taken X seconds», que con Z-Image suman 7,2 s, del mismo tamaño que la diferencia de 6,6 s entre los dos. Con Qwen-Image suman 9,4 s de una diferencia de 20,3 s. Es consistente con esa explicación, pero no lo probé apagando nada.
¿Sigue existiendo Forge?
El Forge original de lllyasviel tiene su último commit en la rama principal el 26 de junio de 2025, y su código solo trae motores para SD 1.5, SD 2, SDXL, SD 3.5, Flux y Chroma: no Z-Image, Qwen-Image ni Wan 2.2. Su continuación activa es Forge Neo, de Haoming02, que sí los soporta. Medí el original solo con SDXL.
¿La calidad de imagen cambia entre ComfyUI y Forge?
En mis imágenes, ComfyUI y Forge Neo dan prácticamente la misma imagen con la misma semilla, con diferencias en detalles y en el texto dibujado. El puntaje CLIP promedio contra el prompt quedó entre 30,0 y 30,9 en todas las herramientas; eso mide correspondencia con el texto, no calidad estética.
¿Y con video, Wan 2.2?
Lo corrí una sola vez, como curiosidad: un clip de 81 cuadros a 832x480 con Wan 2.2 A14B en GGUF Q5_K_M tardó 877 s en ComfyUI y 932 s en Forge Neo. Con un solo clip no hay forma de decir que uno sea más rápido.
¿Puedo reproducirlo?
Sí. La ficha con las reglas fijadas antes de medir y sus cinco enmiendas, los prompts, el arnés de medición, la línea base, el puntaje y los tiempos crudos están en el repositorio y en un gist enlazado en las fuentes.
Fuentes
- ComfyUI, Forge Neo y el Forge original.
- Los modelos: Stable Diffusion XL base 1.0, Z-Image Turbo y su versión para ComfyUI, Qwen-Image para ComfyUI y Wan 2.2.
- ComfyUI-GGUF, para cargar los GGUF de Wan en ComfyUI.
- diffusers, la línea base, y CLIP ViT-L/14, para el puntaje de similitud imagen–texto.
- La ficha, los prompts, el arnés, la línea base, el puntaje y los tiempos.
Medido el 18 de octubre de 2026 en una RTX 4070 Ti SUPER de 16 GB (Ada, sm_89) con 31 GB de RAM, en NixOS. ComfyUI v0.41.3 (8713616), Forge Neo f7f23149, Forge original dfdcbab6, diffusers 0.41.0; PyTorch 2.13.0+cu130 (el Forge original, 2.3.1+cu121). 36 imágenes por herramienta y modelo: 12 prompts y 3 semillas.
BOLETÍN · MEDIDO
Una medición nueva, cuando la hay.
Cada post con sus números, sus fallos y los scripts para repetirlo. Entre uno y tres correos al mes. Te das de baja con un clic.
LO ÚLTIMO QUE LLEGÓ
- ComfyUI vs Forge en 16 GB2× con Z-Image
- NVFP4 vs FP8 vs GGUF en 16 GB2,3× más rápido
- Qwen-Image NVFP4 en Ada19/21 con menos grano
Uso Listmonk en mi propio servidor; tu correo no sale de ahí. Confirmas por correo antes de recibir nada.
Comentarios
Todavía no hay comentarios. El primero es tuyo.