
NVFP4 sin Blackwell: corrí el Qwen-Image de NVIDIA en una RTX 4070 Ti SUPER y el grano de NF4 estaba en 8 matrices
NVIDIA publicó Qwen-Image en NVFP4 solo para Blackwell. En una RTX 4070 Ti SUPER su ruta oficial no carga, y los pesos expandidos a bf16 corren más lento que NF4 (145 s contra 102 s por imagen) sin escribir mejor. Lo que sí encontré es el origen del grano de NF4: no estaba en las capas con peor error, sino en 8 matrices de los bloques del borde que NVIDIA dejó sin cuantizar. Dejarlas en bf16 lo quita a menos de medio segundo más por imagen.
NVIDIA publicó Qwen-Image en NVFP4, su formato de 4 bits para Blackwell; la ficha fecha el lanzamiento el 12 de octubre. La ficha declara un solo hardware compatible, la GB300. Yo tengo una RTX 4070 Ti SUPER de 16 GB, de la generación Ada, sin tensor cores FP4, y con ella genero las portadas de este blog usando Qwen-Image en NF4. Quería saber dos cosas: si esos pesos sirven de algo en mi tarjeta y si son mejores que el NF4 que ya uso.
Qué es NVFP4 y en qué se diferencia de NF4
Los dos guardan cada peso en 4 bits, y los dos necesitan escalas para volver al valor real. La diferencia está en el tamaño del bloque y en qué representan los 16 códigos.
- NVFP4 guarda un número de punto flotante de 4 bits (E2M1: signo, dos bits de exponente y uno de mantisa, valores de 0 a 6). Cada bloque de 16 pesos tiene su propia escala en FP8, y cada matriz una escala global en FP32. En Blackwell, los tensor cores multiplican en FP4 directamente, con pesos y activaciones en 4 bits.
- NF4, el formato de QLoRA que usa bitsandbytes, pone sus 16 niveles en los cuantiles de una distribución normal, y escala cada bloque de 64 pesos con su valor absoluto máximo.
Así se ven 64 pesos reales de una capa de modulación del bloque 30, sacados de los dos archivos:
▮ base bf16 · ● NVFP4 expandido (error en estos 64: 9,1 %) ·◆ NF4 expandido (error en estos 64: 8,7 %)
Primer bloque NVFP4, tal como está en el archivo
- 0xdccódigo 1100-2,0código 1101-3,0
- 0x93código 00111,5código 1001-0,5
- 0x5fcódigo 1111-6,0código 01013,0
- 0x57código 01116,0código 01013,0
- 0x29código 1001-0,5código 00101,0
- 0x4bcódigo 1011-1,5código 01002,0
- 0x01código 00010,5código 00000,0
- 0xf9código 1001-0,5código 1111-6,0
peso = E2M1 × escala del bloque × escala global → -2,0 × 4,5 × 0,0017439 = -0,01570 (base -0,01941)
NVFP4 usa cuatro escalas donde NF4 usa una, así que cada grupo de 16 se ajusta a su propio rango. En este segmento las dos quedan parecidas, y NF4 incluso un poco más cerca (8,7 % contra 9,1 %). Las diferencias aparecen al mirar las matrices enteras, más abajo. En memoria cuestan lo mismo: 4 bits por peso más 8 bits de escala cada 16 en NVFP4, o 32 cada 64 en NF4 sin doble cuantización (como lo carga diffusers aquí). Son 4,5 bits por peso en los dos.
La ruta oficial, en una tarjeta de 16 GB
Corrí el contenedor de la ficha tal cual (TensorRT-LLM VisualGen 1.3.0rc28 con trtllm-serve), primero con la configuración de la ficha y después con cpu_offload_config activado, que no cambió nada visible en la carga. Las dos veces se quedó sin memoria en el mismo punto, con 14,00 GiB ya asignados, mientras cargaba el codificador de texto después del transformer. Ese codificador viene en bf16 y su archivo pesa 15,4 GiB, casi lo mismo que la tarjeta entera.
Leyendo el código del contenedor encontré algo curioso: trae un kernel Marlin para NVFP4 que declara soporte para sm_89 a sm_99 y para sm_120 y sm_121, un rango que incluye la mía, aunque solo se usa si la capa lo permite de forma explícita. Con el pipeline sin cargar, nunca llegué a usarlo. Las líneas están en el gist.
Correr los pesos NVFP4 en Ada
Si el hardware no multiplica en FP4, se puede guardar la matriz empaquetada en la GPU y expandirla a bf16 justo antes de cada multiplicación. Las activaciones quedan en bf16, así que esto es NVFP4 solo para los pesos (W4A16), no el W4A4 que corre Blackwell. Escribí un expansor de unas 50 líneas: una tabla de 256 entradas convierte cada byte en sus dos valores E2M1, y la escala de cada bloque multiplica una vista de 16 en 16. En una matriz de 12.288×3.072 tarda 0,96 ms, contra 4,15 ms de la versión directa.
Antes de generar, dos controles. Leer los nibbles en el orden equivocado sube el error de 9,47 % a 141 %, así que el orden de lectura importa y el mío es el correcto. Y el codificador de texto del repositorio de NVIDIA es idéntico, bit a bit, al del modelo base (459 de 459 tensores del primer fragmento), así que las dos variantes reciben el mismo texto codificado.
Con el codificador de texto y el transformer en el mismo proceso, NF4 se quedó sin memoria aunque liberé el codificador. Por eso codifico los textos en un proceso aparte, que guarda los embeddings y termina antes de cargar el transformer.
NVFP4 expandido tarda 43 s más por imagen que NF4: sin tensor cores FP4, el formato solo sirve para guardar los pesos, y la expansión se paga en cada pasada. Los 2 GiB de más, en cambio, casi no son del formato. NVIDIA dejó en bf16 los bloques 0, 1, 58 y 59, y eso solo suma unos 1,8 GiB frente a tenerlos en 4 bits. La copia NF4 de bitsandbytes cuantiza 846 matrices: las 784 de NVIDIA, las de esos cuatro bloques y seis más fuera de los bloques.
Calidad: el error de cada matriz
Antes de generar una sola imagen medí cuánto se aleja cada formato de los pesos originales, en las 784 matrices que NVIDIA cuantizó (14 por bloque, bloques 2 a 57). El error es relativo: la norma de la diferencia dividida por la norma del original.
| Métrica | NVFP4 | NF4 |
|---|---|---|
| Error mediano | 9,47 % | 9,33 % |
| Percentil 90 (rango más cercano) | 9,52 % | 10,15 % |
| Máximo | 9,59 % | 12,89 % |
| Matrices donde queda más cerca | 254 | 530 |
En la mediana gana NF4. En el peor caso gana NVFP4, que es muy parejo: todas sus matrices quedan entre 6,3 y 9,6 %. Los peores casos de NF4 no están repartidos al azar.
parte de los pesos cuantizados
- ■ modulación (img_mod.1 / txt_mod.1)
- 6,34 B · error mediano: NF4 11,3 % · NVFP4 9,3 %
- ● las otras 672
- 12,68 B · error mediano: NF4 9,3 % · NVFP4 9,5 %
Las capas de modulación (img_mod.1 y txt_mod.1) calculan, a partir del paso de difusión, el desplazamiento, la escala y la compuerta que se aplican a cada bloque, como en el adaLN de DiT. Son 112 de las 784 matrices, pero cada una tiene 18.432×3.072 pesos: juntas suman 6,34 de los 19,02 mil millones cuantizados, un tercio. Sus pesos tienen colas muy pesadas: la curtosis mediana es 157,6, contra 0,66 en el resto. En esas capas NF4 tiene 11,3 % de error mediano y NVFP4 9,3 %. En el resto, NF4 queda mejor (9,27 % contra 9,48 %). Dentro de las 112, el error de NF4 sube con la curtosis (correlación de rangos 0,75) y con la profundidad: su mediana es 9,4 % en los bloques 2 a 13, donde NF4 todavía le gana a NVFP4, 10,8 % en los bloques 14 a 29 y 12,1 % del 30 al 57.
NF4 está pensado para pesos con distribución normal, y estos no lo son. El mecanismo exacto no lo tengo: la razón entre el máximo y la desviación de cada bloque de 64 es casi igual en las capas de modulación y en el resto (2,65 contra 2,61), así que no es un valor extremo dentro de cada bloque. Lo que separa a estas capas es la forma de la matriz entera. Como se ve más abajo, este peor error no es lo que produce el grano.
Calidad: el texto dentro de la imagen
Los mismos seis prompts con texto en español del post anterior, con las semillas 7, 21 y 88, a 1344×768, con los pasos (50), el CFG (4) y el negativo de la ficha de NVIDIA. Revisé cada imagen a tamaño completo con el mismo criterio: ✓ si cada carácter salió como se pidió, ≈ si solo falla un espacio, ✗ si hay un carácter de más, de menos o equivocado.
Se pidió MEDIDO EN UN PORTÁTIL
Prompt completo
A minimalist concert poster on a brick wall, bold sans-serif headline reading "MEDIDO EN UN PORTÁTIL", flat colors, soft daylight
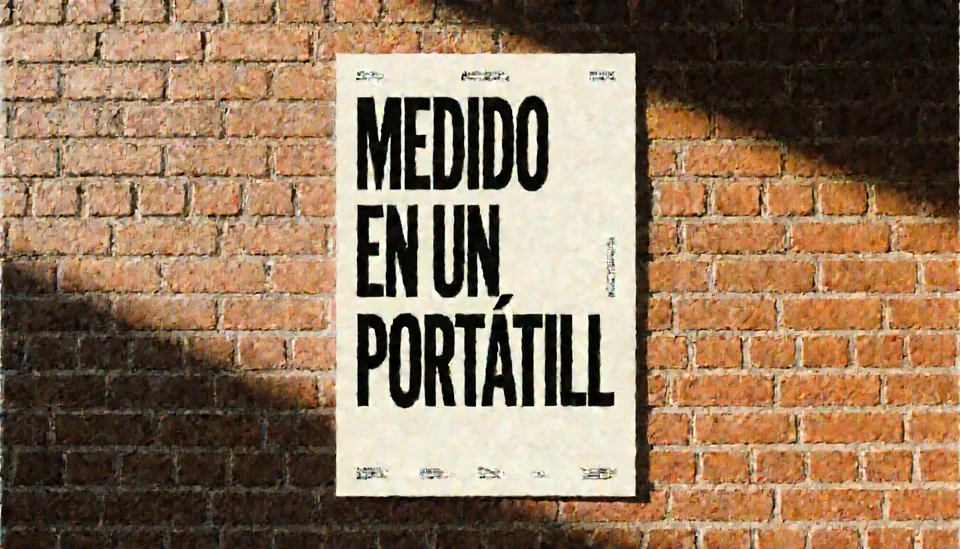
✗ PORTÁTILL
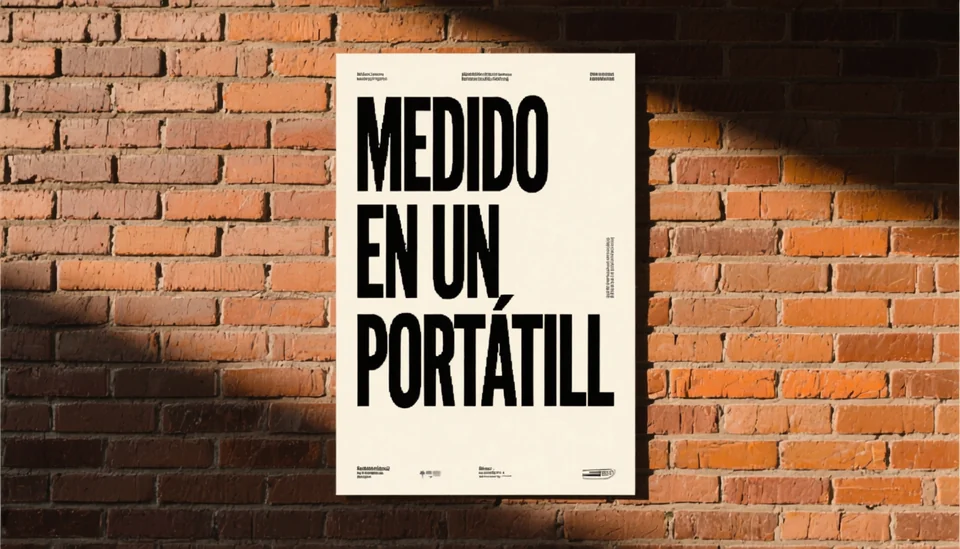
✗ PORTÁTILL
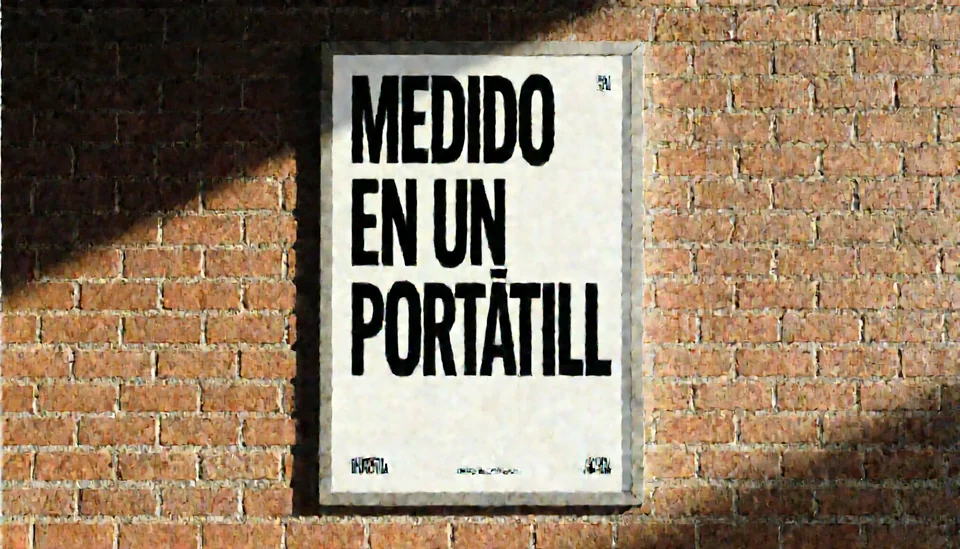
✗ PORTĀTILL
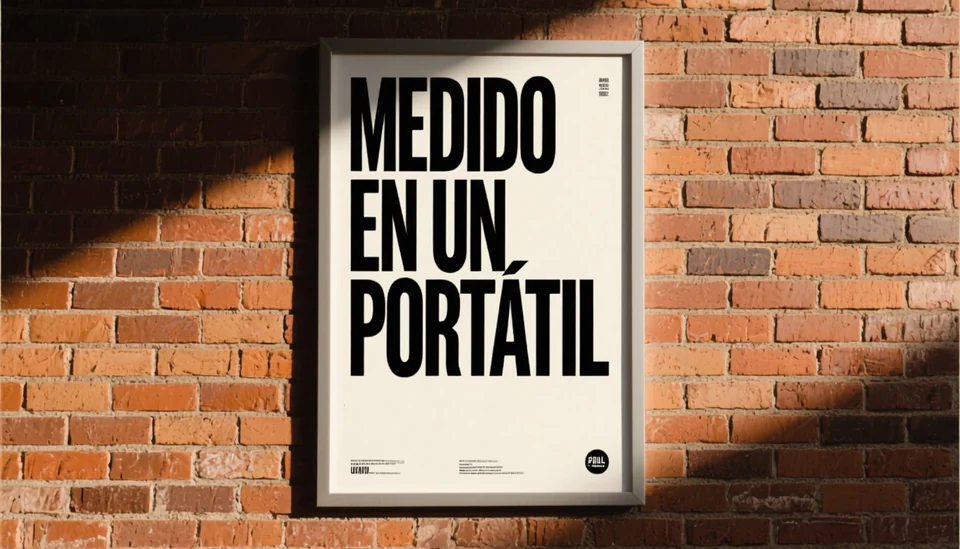
✓ como se pidió
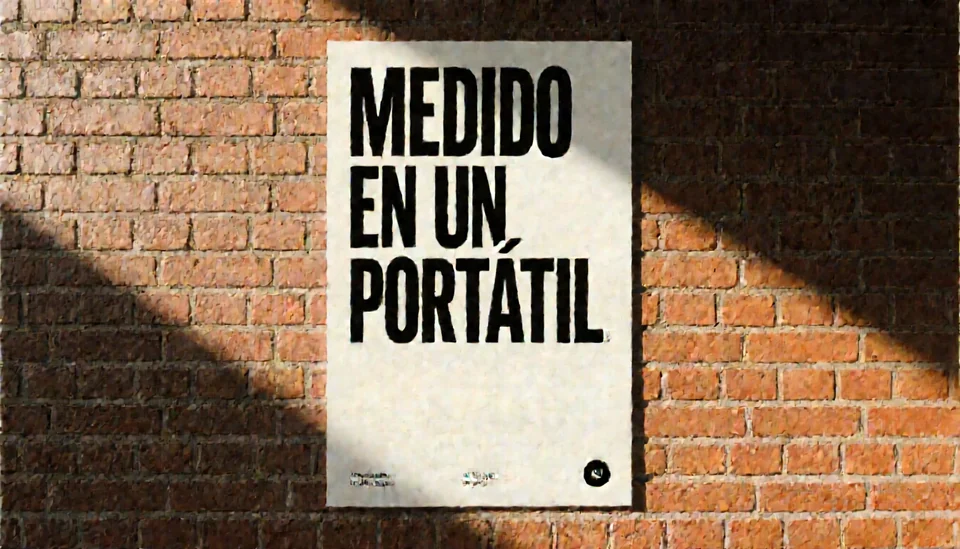
✗ PORTÁTIL.
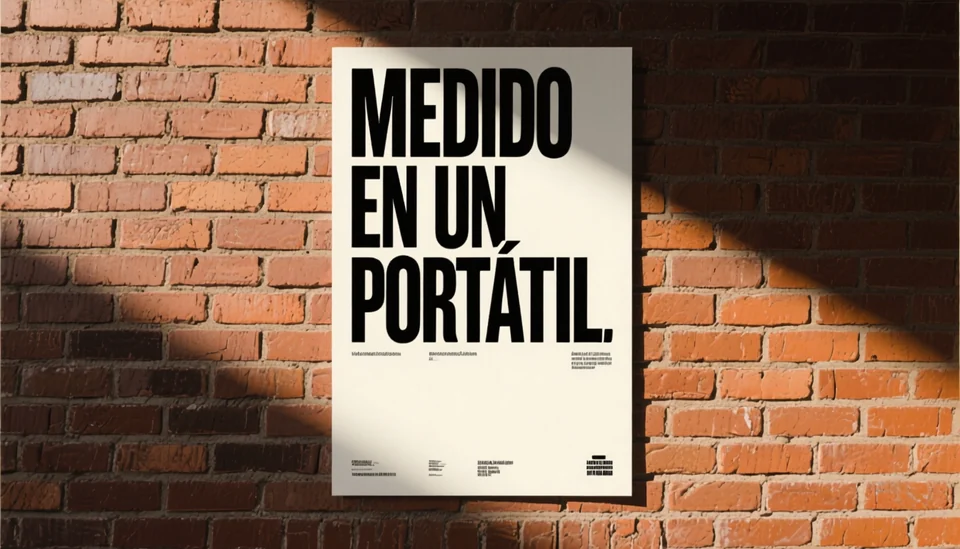
✗ PORTÁTIL.
Se pidió 18 a 21 % más rápido
Prompt completo
A green school chalkboard with neat white chalk handwriting that reads "18 a 21 % más rápido", a piece of chalk on the ledge, classroom light
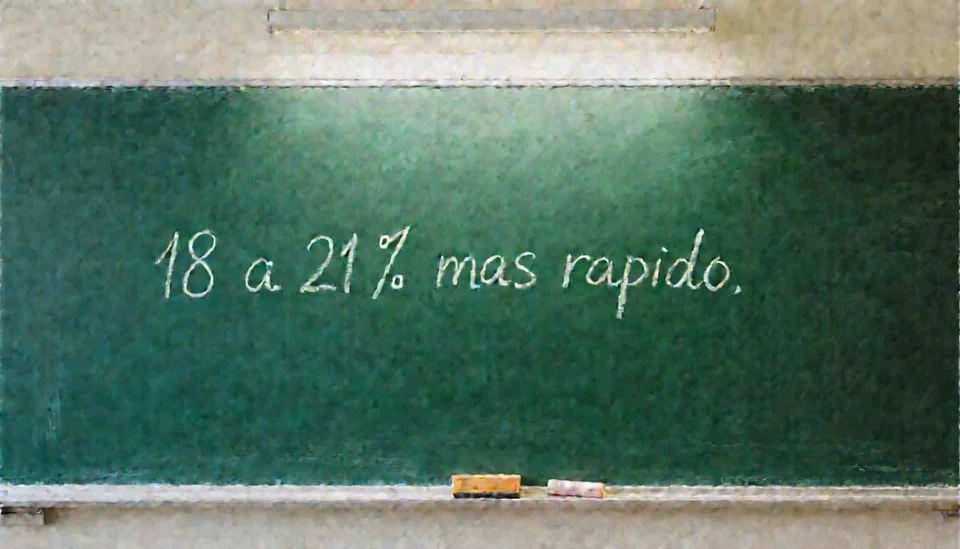
✗ mas rapido.
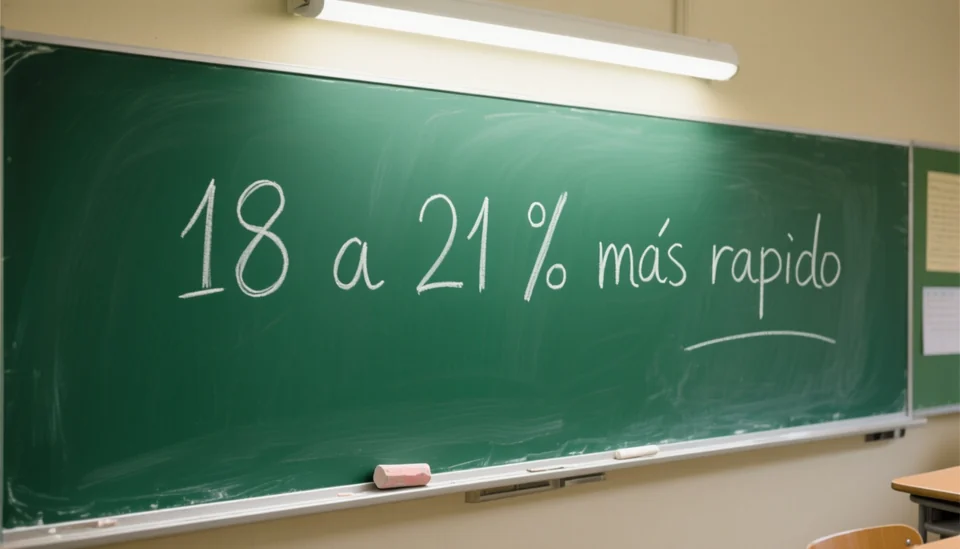
✗ rapido sin tilde
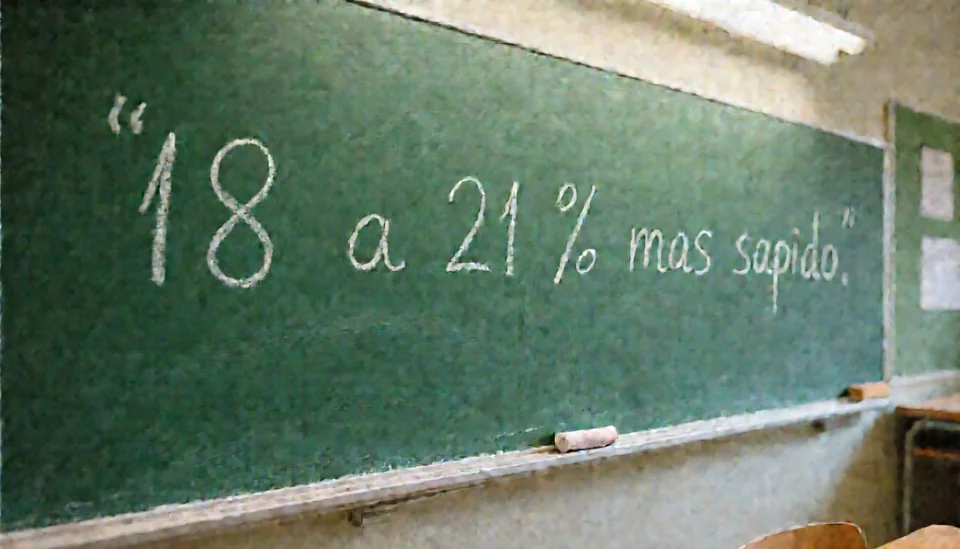
✗ mas sapido
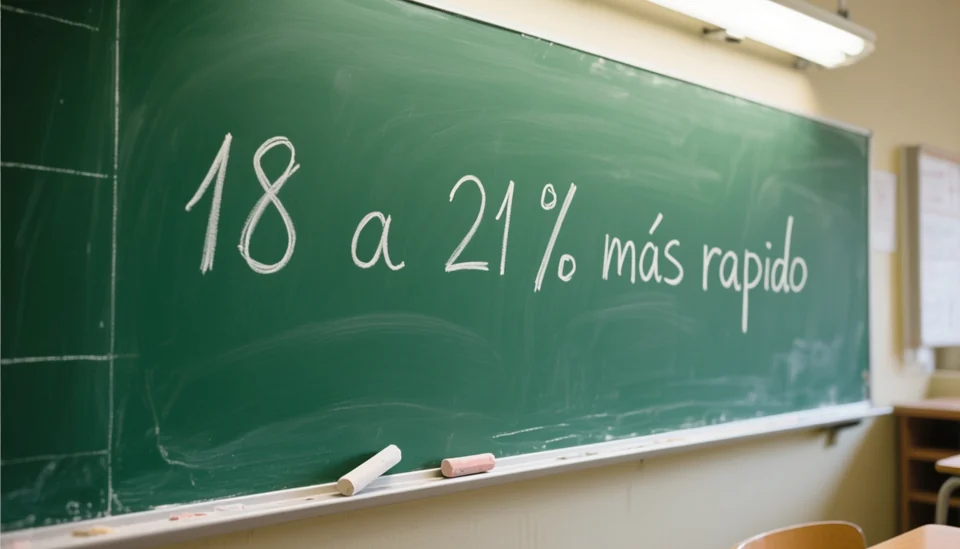
✗ rapido sin tilde
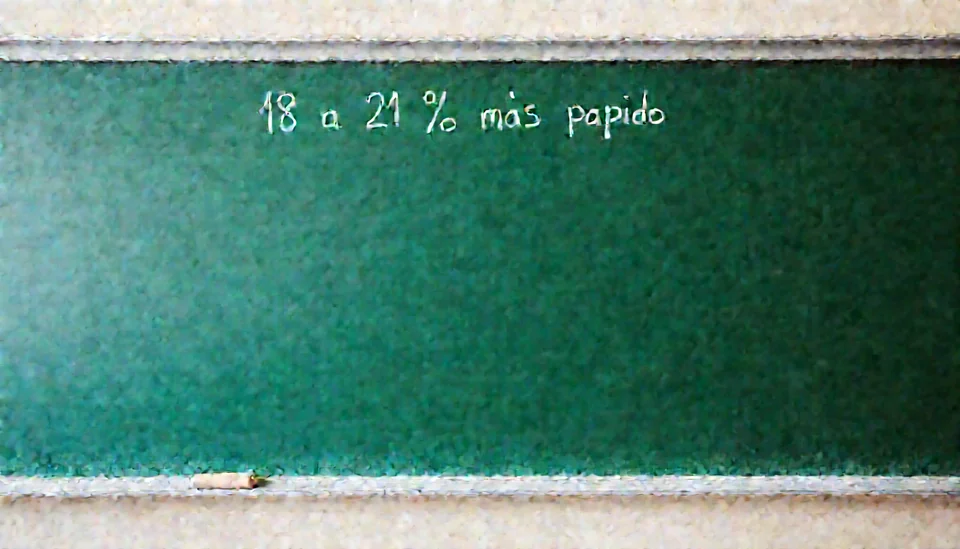
✗ mas papido
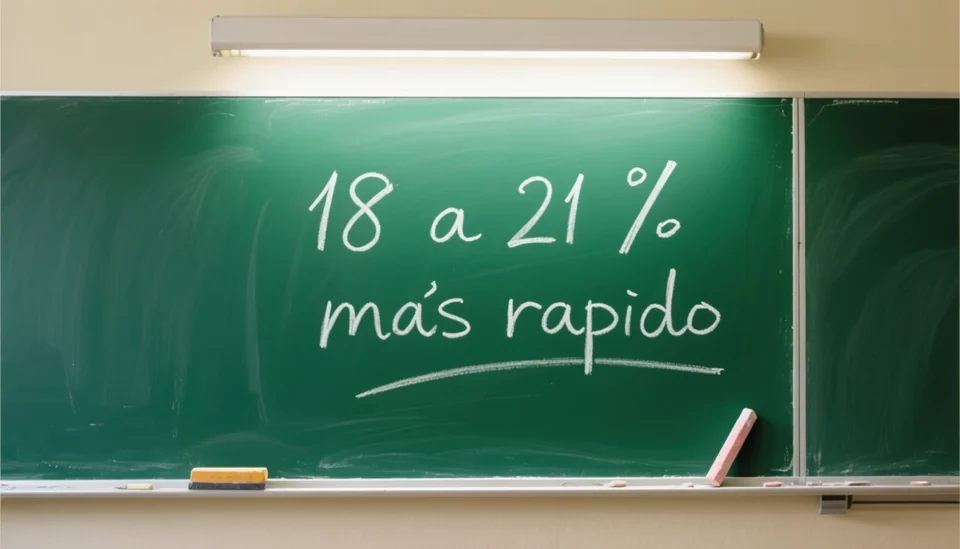
✗ rapido sin tilde
Se pidió efraingaray.com
Prompt completo
A pink neon sign glowing on a dark tiled wall at night, the sign spells "efraingaray.com", reflections on wet floor
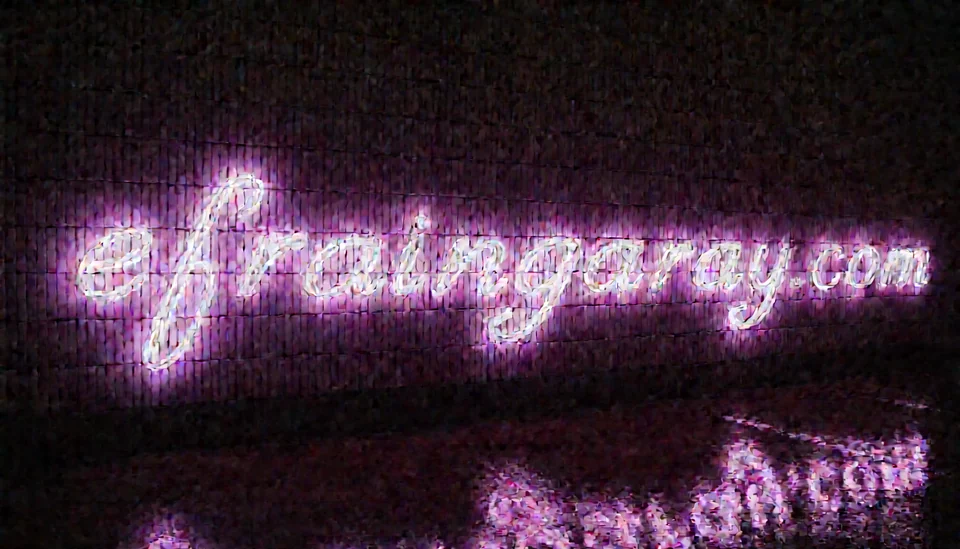
✓ como se pidió
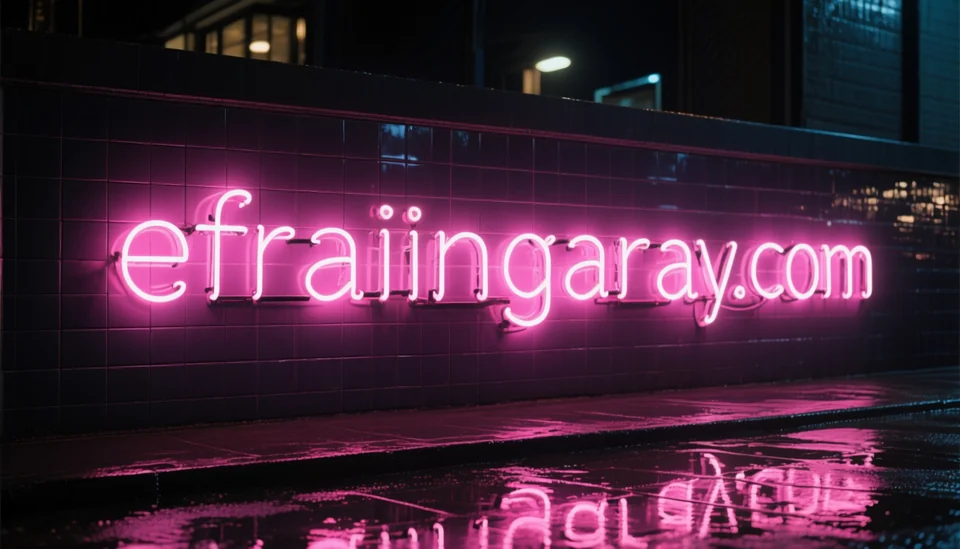
✗ efraiingaray.com
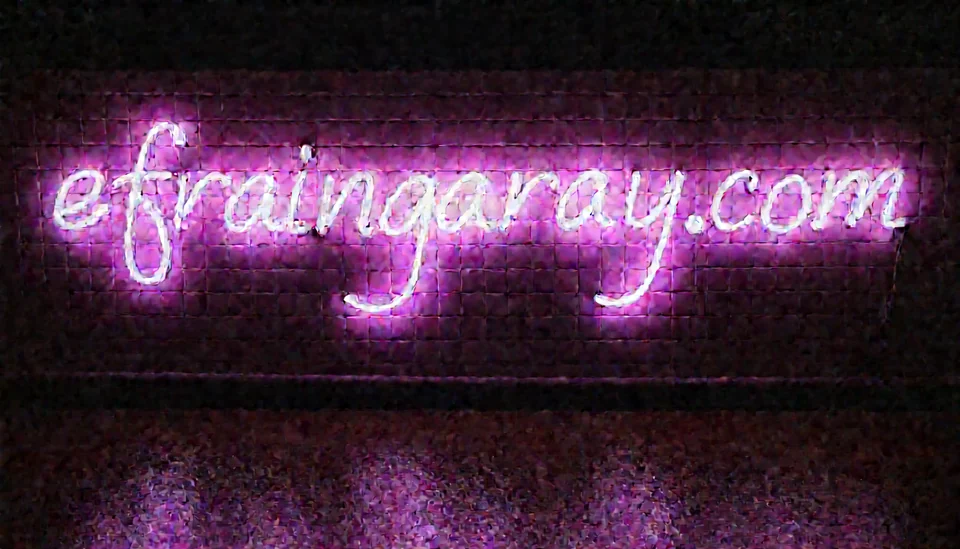
✓ como se pidió
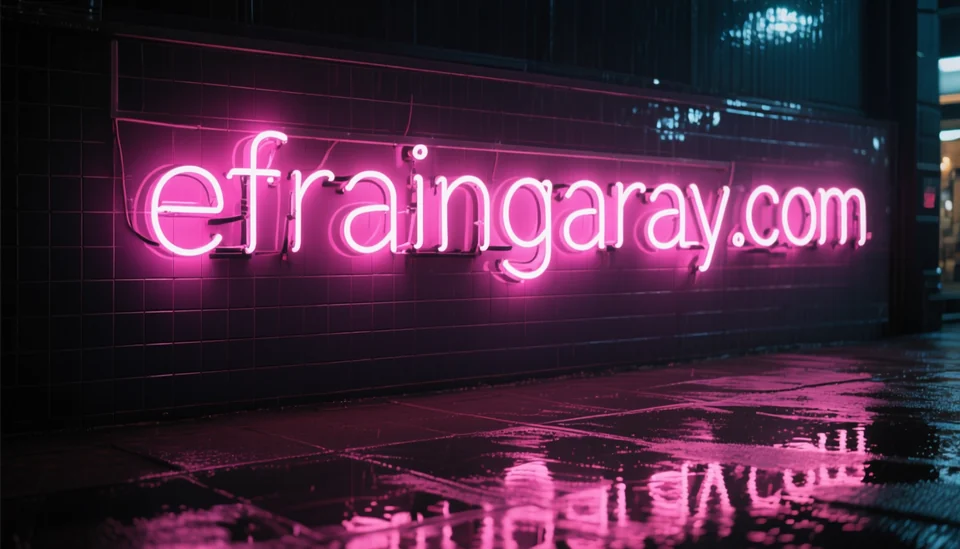
✓ como se pidió
✓ como se pidió
✓ como se pidió
Se pidió Ocho modelos de decisión
Prompt completo
A hardcover book lying on a wooden desk, the cover title printed in large serif letters reads "Ocho modelos de decisión", warm lamp light
✗ modeles deción
✗ modeles de decición
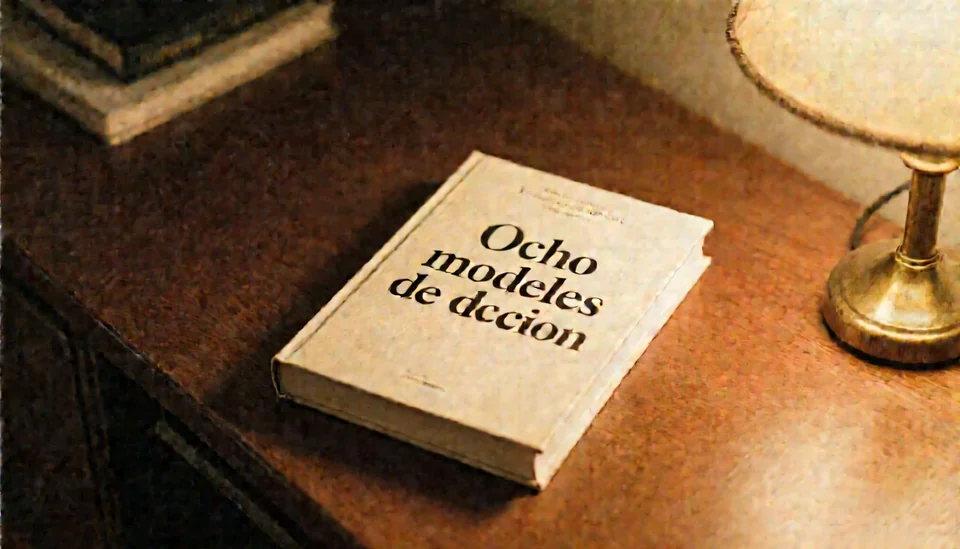
✗ modeles de dcion
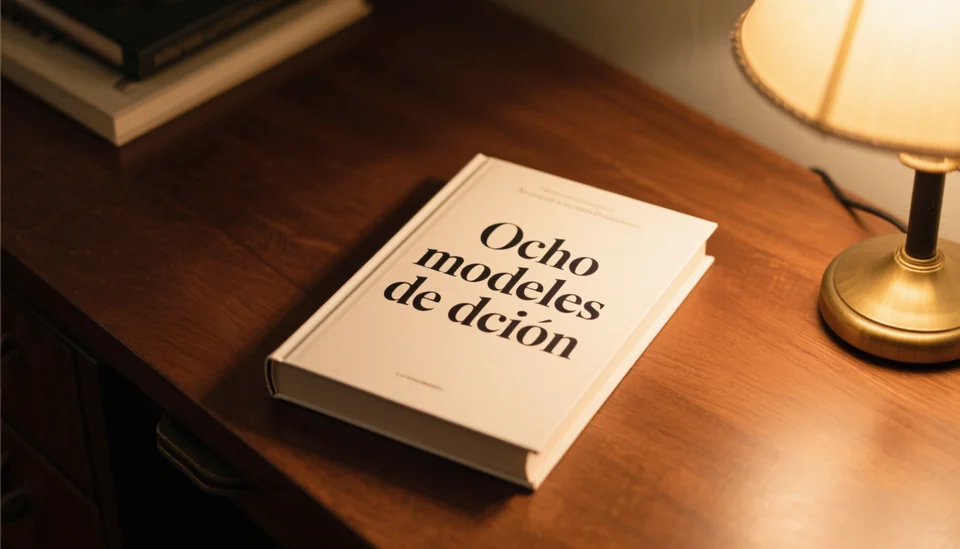
✗ modeles de dción
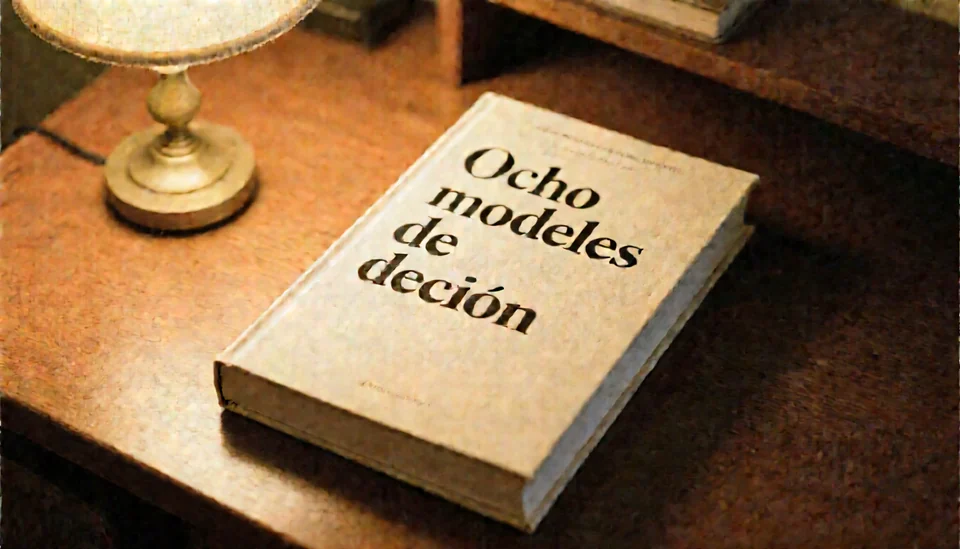
✗ modeles de deción
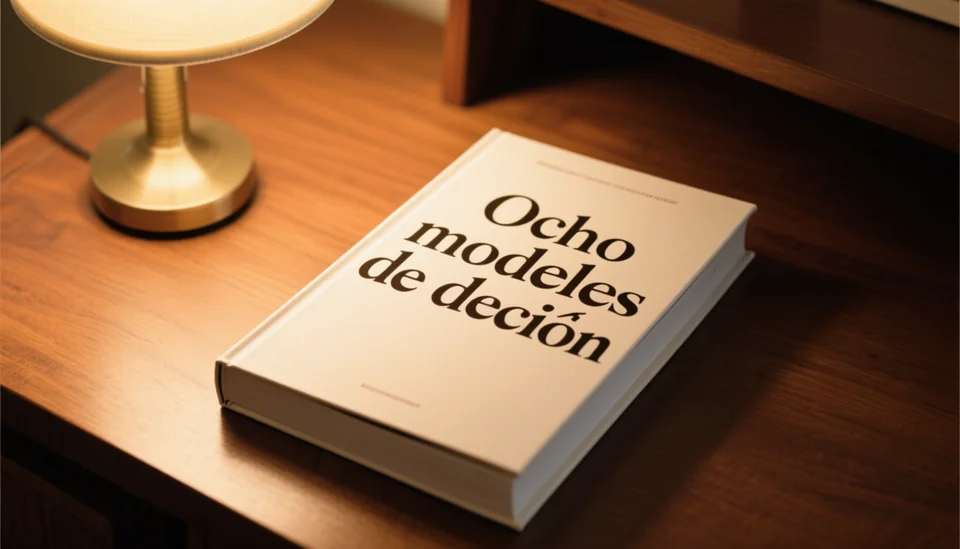
✗ modeles de deción
Se pidió AUC 0,966
Prompt completo
A glass jar on a kitchen shelf with a white paper label printed in black capitals "AUC 0,966", shallow depth of field
✓ como se pidió
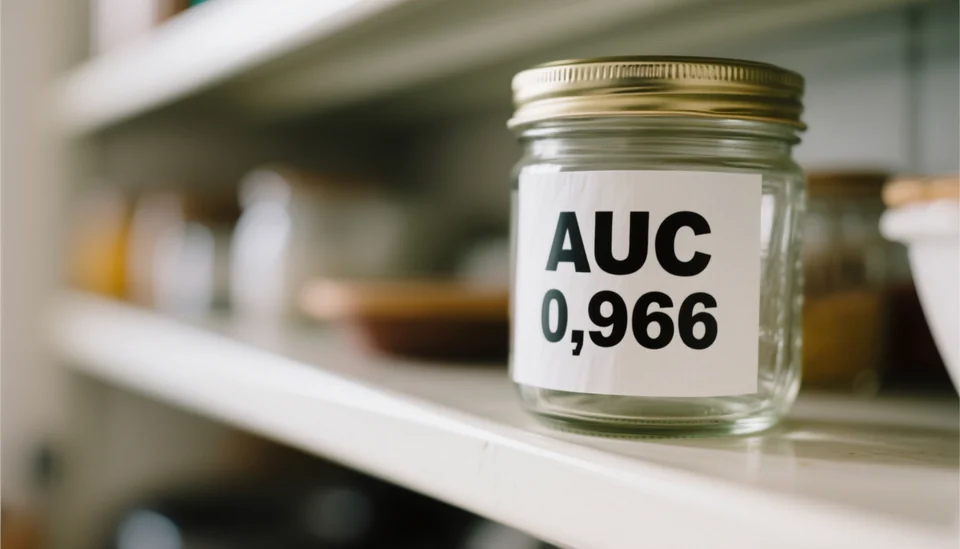
✓ como se pidió
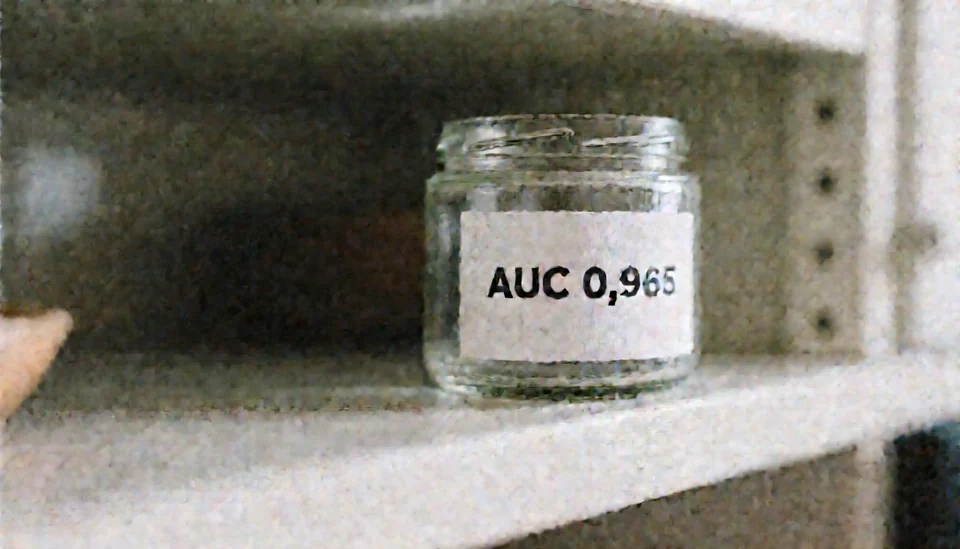
✗ AUC 0,965
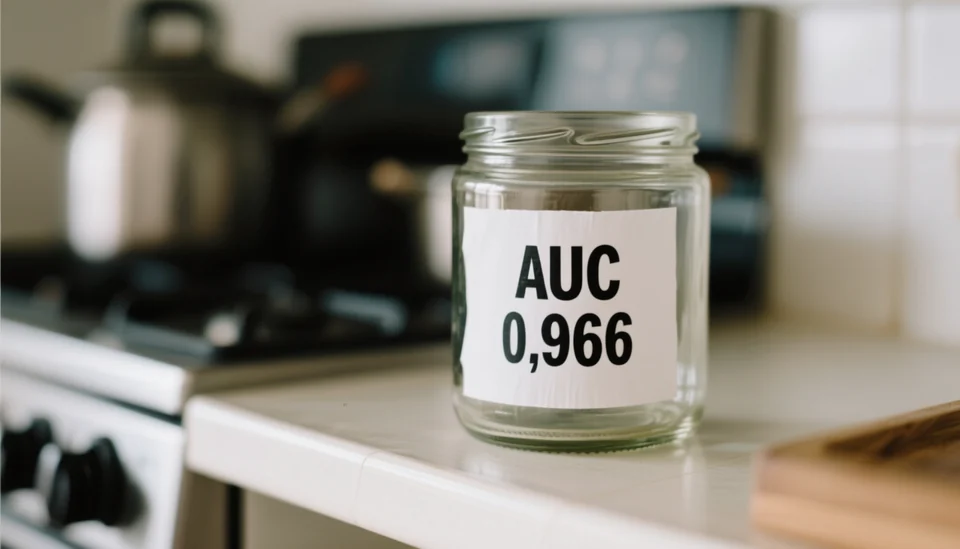
✓ como se pidió
✓ como se pidió
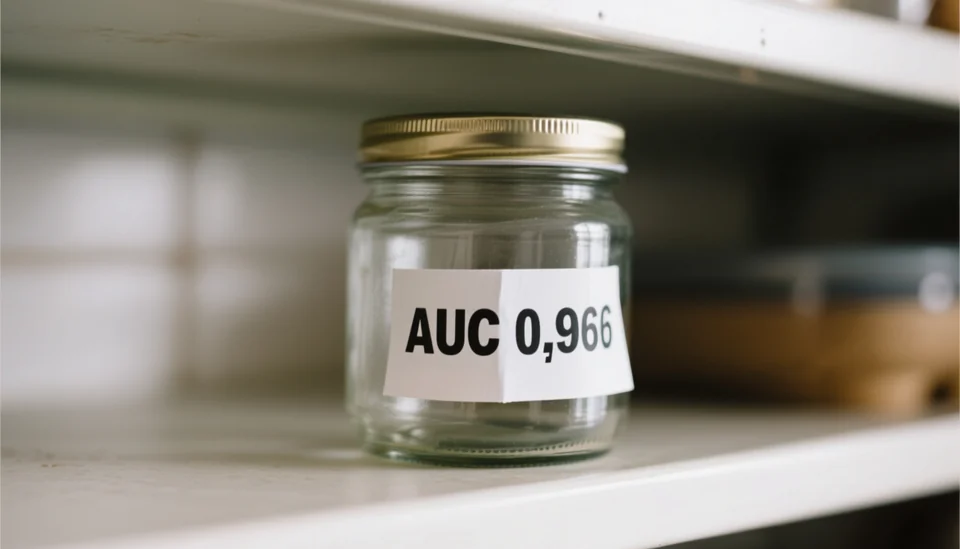
✓ como se pidió
Se pidió PostgreSQL 19
Prompt completo
A yellow road sign on a mountain road at dusk, black letters reading "PostgreSQL 19", pine trees behind
✗ Posteghol
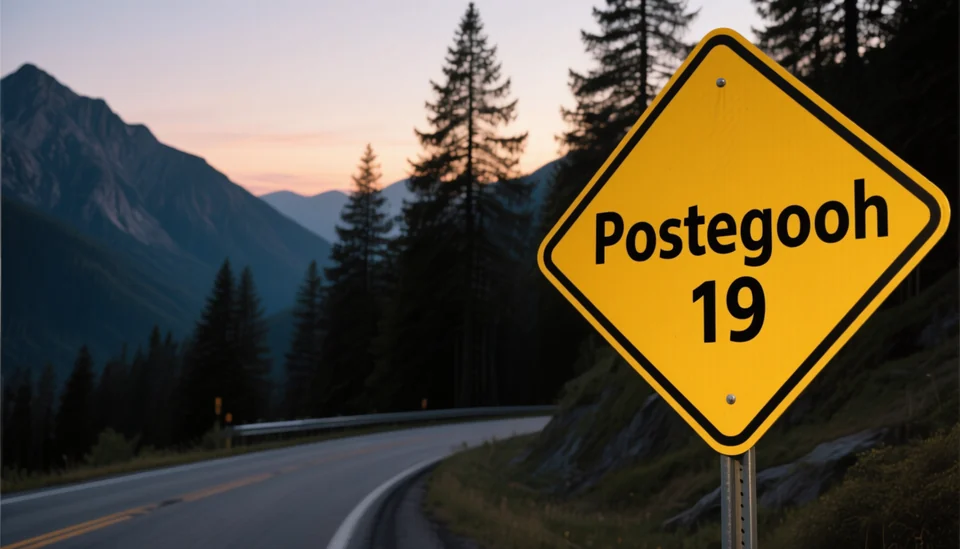
✗ Postegooh
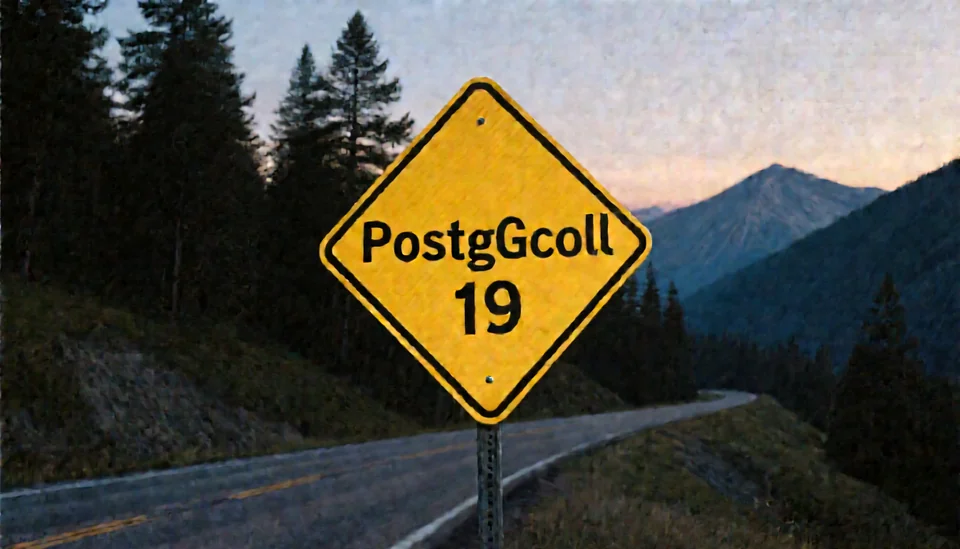
✗ PostgGcoll
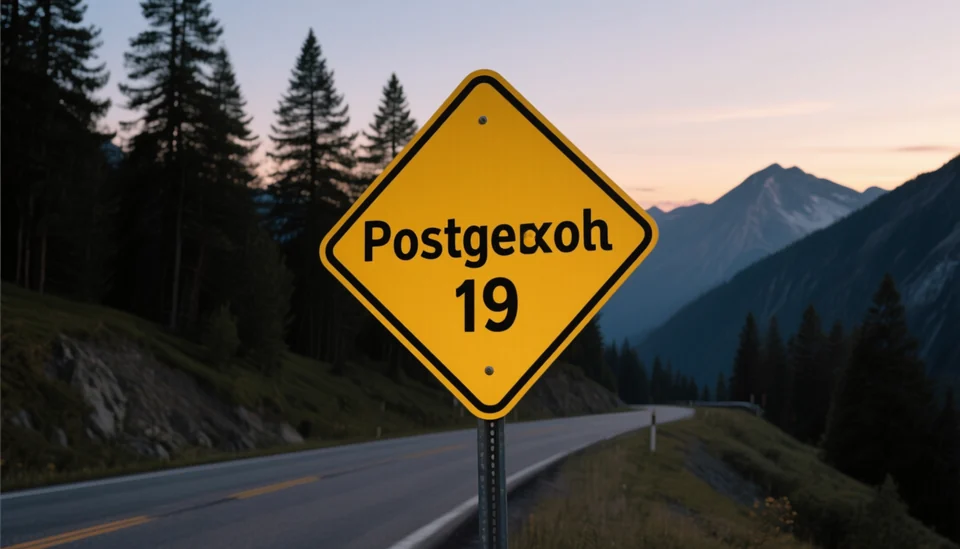
✗ Postgexoh
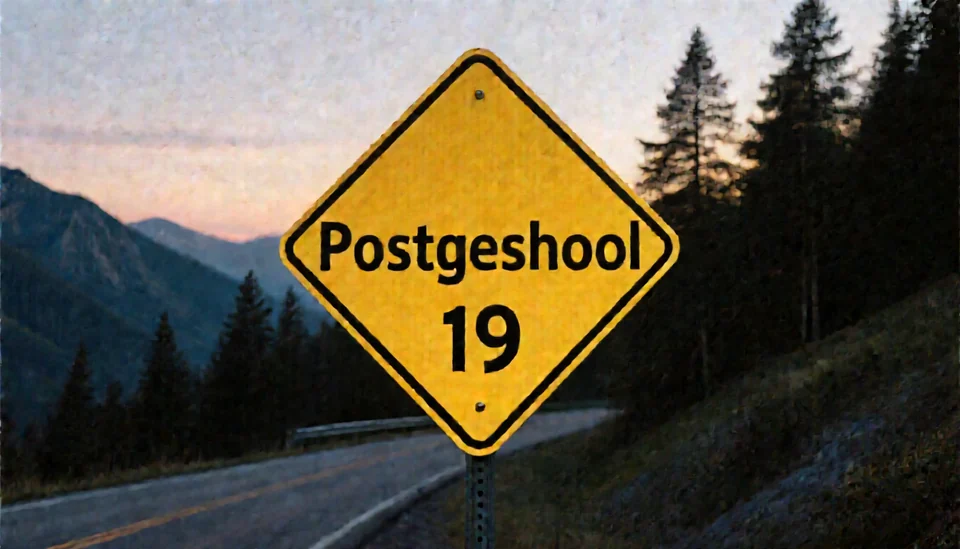
✗ Postgeshool
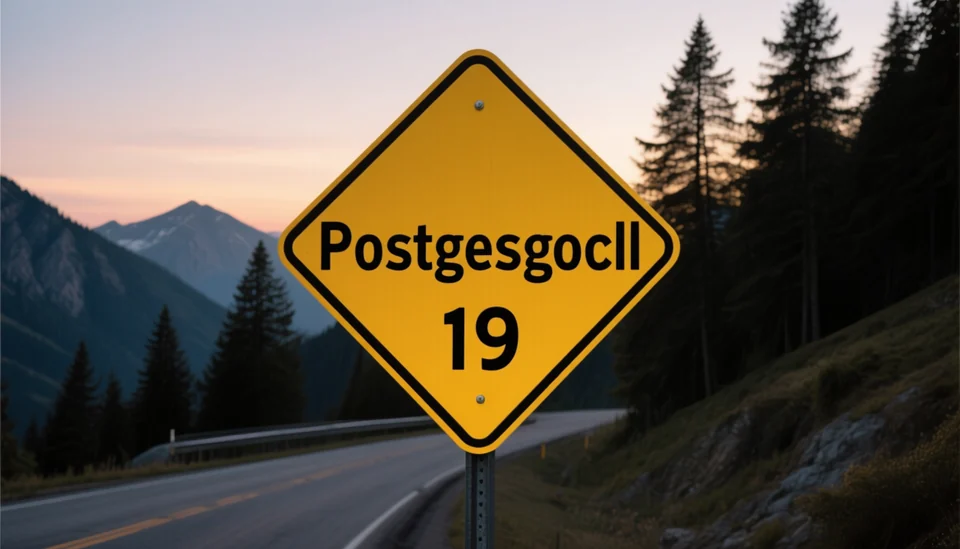
✗ Postgesgocll
NVFP4 escribió 6 de 18 y NF4 5. La regla que fijé en la ficha antes de medir decía que una diferencia de una imagen o menos es empate. Los dos fallan en las mismas palabras: «rapido» sin tilde, «modeles de decición», «PostgreSQL» deformado. Ojo: este es Qwen-Image base con 50 pasos, no el 2.1-Turbo de 8 pasos de mis portadas, que en el post anterior escribió 13 de 18.
Lo que la regla no medía: el grano
Revisando las imágenes a tamaño completo se nota algo que la regla no medía: las de NF4 tienen grano, como una foto con ISO alto, sobre todo en paredes, pizarras y fondos desenfocados. Para no quedarme en la impresión, medí el ruido de fondo de cada imagen: le resto a la luminancia su promedio de 3×3, calculo la desviación de ese residuo en parches de 16×16 y me quedo con el percentil 10, que corresponde a las zonas más planas. Comparo cada imagen con la de la misma semilla y prompt en la otra variante. A los 18 del banco sumé los 3 prompts de muestra de la ficha de NVIDIA, que van a 512×512 y 1024×1024. NF4 sale más ruidoso que NVFP4 en 19 de 21 pares, con una mediana de 0,557 contra 0,420.
La primera hipótesis, y por qué estaba mal planteada
El grano y el peor error de NF4 aparecían juntos, así que agregué una enmienda a la ficha antes de correr la prueba, pero después de haber visto las imágenes: es exploratoria. La hipótesis era que el grano venía de las capas de modulación en NF4. La prueba tomó las capas de modulación del archivo de NVIDIA y bajó el ruido en 19 de 21 pares, con una mediana de 0,408. Cumplía la regla.
La auditoría externa encontró que esa prueba cambiaba dos cosas a la vez. En los bloques 2 a 57, 112 matrices pasaban de NF4 a NVFP4. En los bloques 0, 1, 58 y 59, que NVIDIA dejó sin cuantizar, 8 matrices pasaban de NF4 a bf16. Cualquiera de los dos cambios podía explicar el resultado.
El control
Registré una segunda enmienda antes de correrla, con dos variantes y una regla para cada resultado posible: una con solo las 112 capas en NVFP4 y otra con solo las 8 en bf16. Mismos 21 trabajos, mismos embeddings.
bajo cada recorte: desviación del residuo en esta ventana
etiqueta · seed 7 · ventana x=0 y=288
libro · seed 21 · ventana x=128 y=224
pizarra · seed 7 · ventana x=0 y=352
● NF4 · mediana 0,557● NF4 + 112 capas NVFP4 · mediana 0,558● NF4 + bloques 58-59 en bf16 · mediana 0,548● NF4 + 8 capas del borde en bf16 · mediana 0,412● NVFP4 · mediana 0,420
- NF4 + 112 capas NVFP4: bajo NF4 en 7 de 21
- NF4 + bloques 58-59 en bf16: bajo NF4 en 16 de 21
- NF4 + 8 capas del borde en bf16: bajo NF4 en 19 de 21
Las 112 capas en NVFP4 no hacen nada: el ruido baja respecto de NF4 en 7 de 21 pares y la mediana queda en 0,558, igual que NF4. Las 8 matrices en bf16, en este banco, explican casi todo: baja en 19 de 21 y la mediana queda en 0,412, más cerca de NVFP4 que de NF4 en 20 de 21. Las dos imágenes donde no baja son las de la ficha de NVIDIA: la de texto chino, que es casi todo trazos y la métrica no distingue del grano, y la foto de la tetera, donde quedan prácticamente iguales (0,411 y 0,412).
Una tercera enmienda, también registrada antes de correrla, separó la salida de la entrada: solo las 4 matrices de los bloques 58 y 59 en bf16. Por la letra de su regla, el grano se atribuiría a los bloques finales, porque el ruido baja en 16 de 21 pares (el umbral era 15). Pero baja muy poco: la mediana queda en 0,548 contra 0,557 de NF4, y en ninguna imagen queda más cerca de NVFP4 que de NF4. La regla contaba la dirección y no el tamaño, y fue un error escribirla así. La mayor parte del efecto necesita los bloques 0 y 1, solos o junto con los finales; la variante con solo esos dos no la corrí.
Esas 8 matrices no tienen un error especialmente alto en NF4: entre 9,2 % y 11,4 %, menos que las del medio de la red, que llegan a 12,9 %. Su curtosis va de 0,5 a 6.935. Lo que las distingue es dónde están: en los primeros y los últimos bloques. El error de cada matriz por separado no predice el daño en la imagen, y la tabla del error de pesos, que parecía señalar el culpable, señalaba otra cosa. NVIDIA dejó esos cuatro bloques sin cuantizar en su archivo. La ficha no dice por qué, y con esta medición se entiende que tenía sentido.
Con esas 8 matrices en bf16, el resto en NF4 tarda 102,6 s por imagen (102,2 s NF4) y llega a 11,7 GiB de pico (11,1 GiB). Revisé el texto de sus 18 imágenes con el mismo criterio: 7 bien (en una, «PORTÁTIL» lleva al lado una marca ® diminuta y separada, que conté como bien; con la lectura estricta serían 6), contra 5 de NF4 y 6 de NVFP4. Esa diferencia no es preregistrada y con 18 imágenes no la doy por real.
Se pidió MEDIDO EN UN PORTÁTIL
Prompt completo
A minimalist concert poster on a brick wall, bold sans-serif headline reading "MEDIDO EN UN PORTÁTIL", flat colors, soft daylight
✗ PORTÁTILL
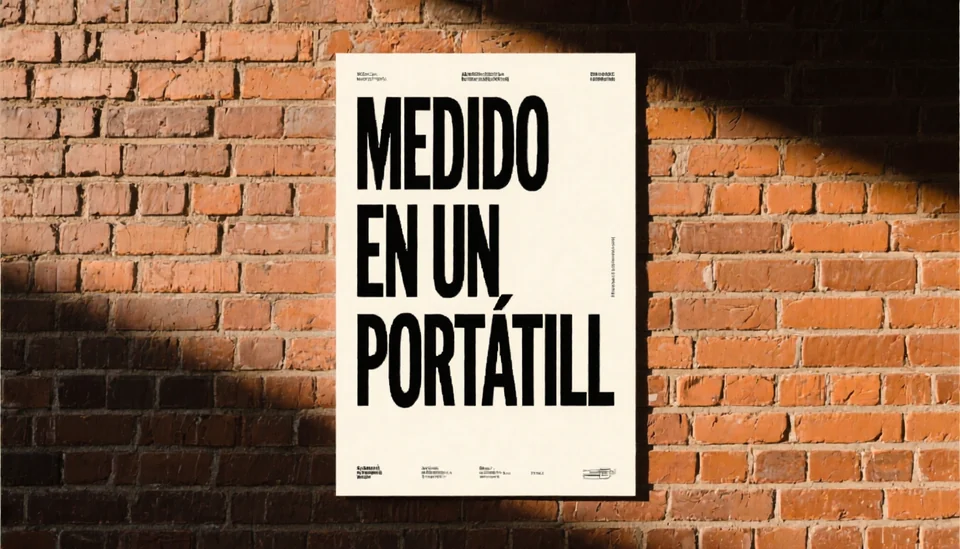
✗ PORTÁTILL
✗ PORTĀTILL
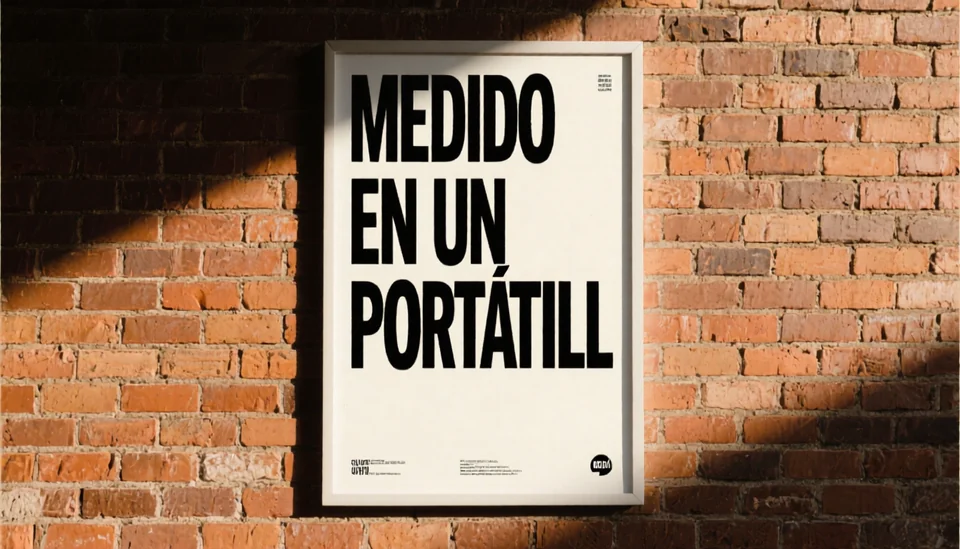
✗ PORTÁTILL
✗ PORTÁTIL.
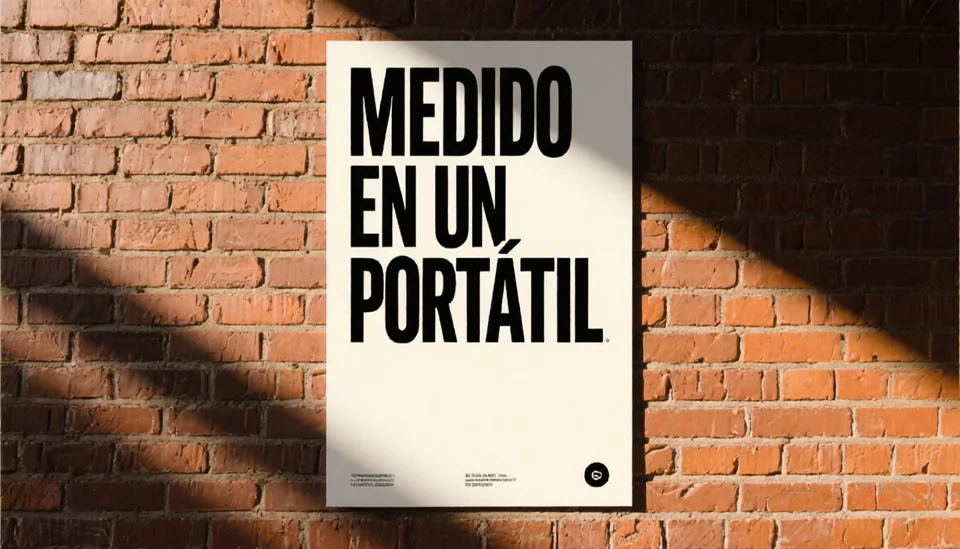
✓ PORTÁTIL; a tiny separate ® mark after it, not part of the word
Se pidió 18 a 21 % más rápido
Prompt completo
A green school chalkboard with neat white chalk handwriting that reads "18 a 21 % más rápido", a piece of chalk on the ledge, classroom light
✗ mas rapido.
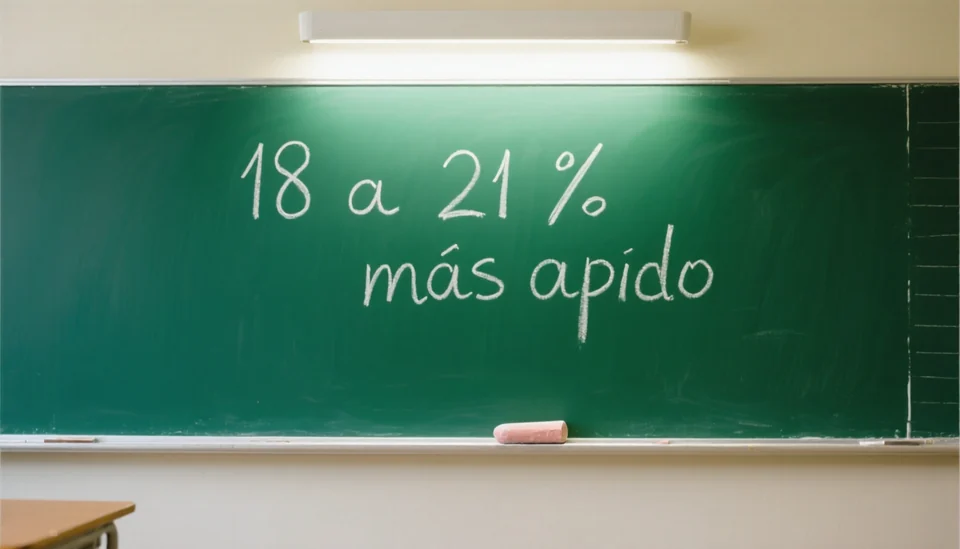
✗ más apido
✗ mas sapido
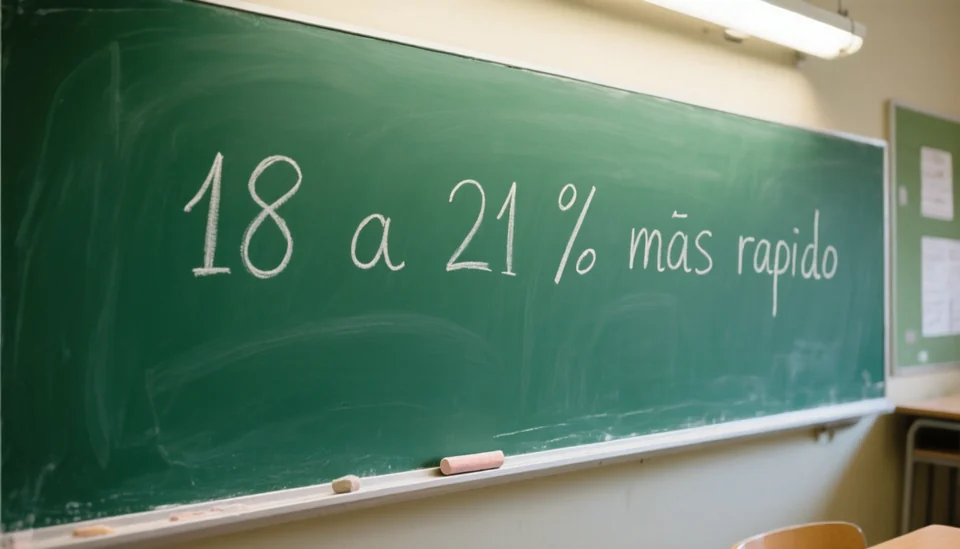
✗ mãs rapido
✗ mas papido
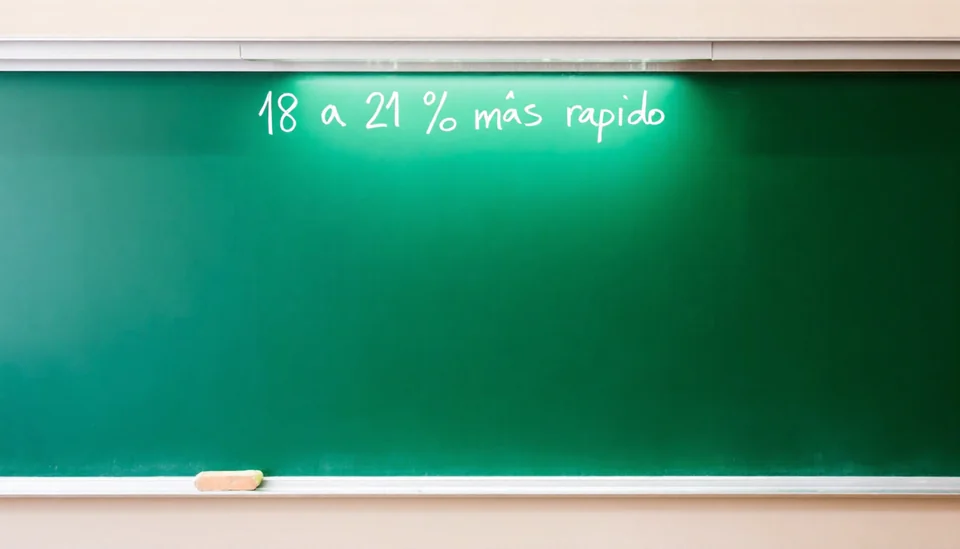
✗ mâs rapido
Se pidió efraingaray.com
Prompt completo
A pink neon sign glowing on a dark tiled wall at night, the sign spells "efraingaray.com", reflections on wet floor
✓ como se pidió
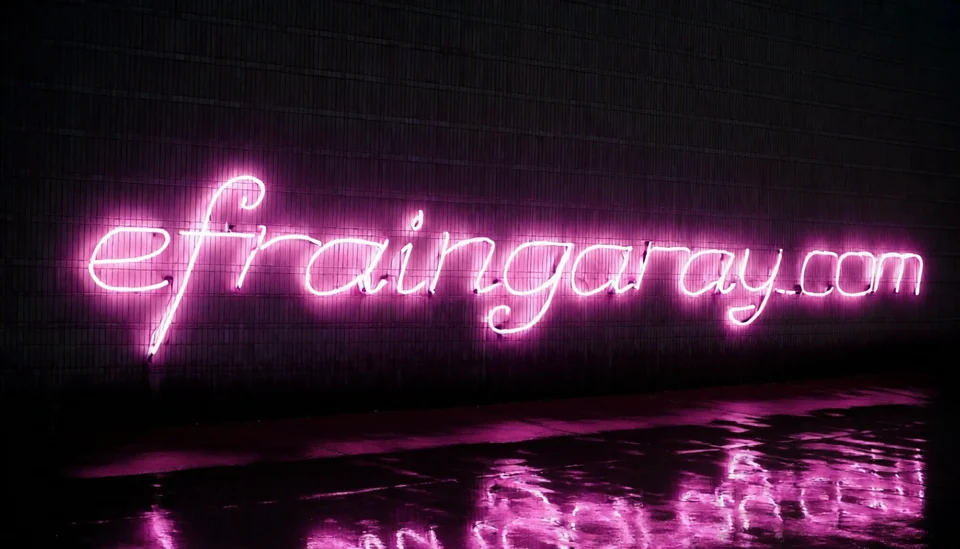
✓ como se pidió
✓ como se pidió
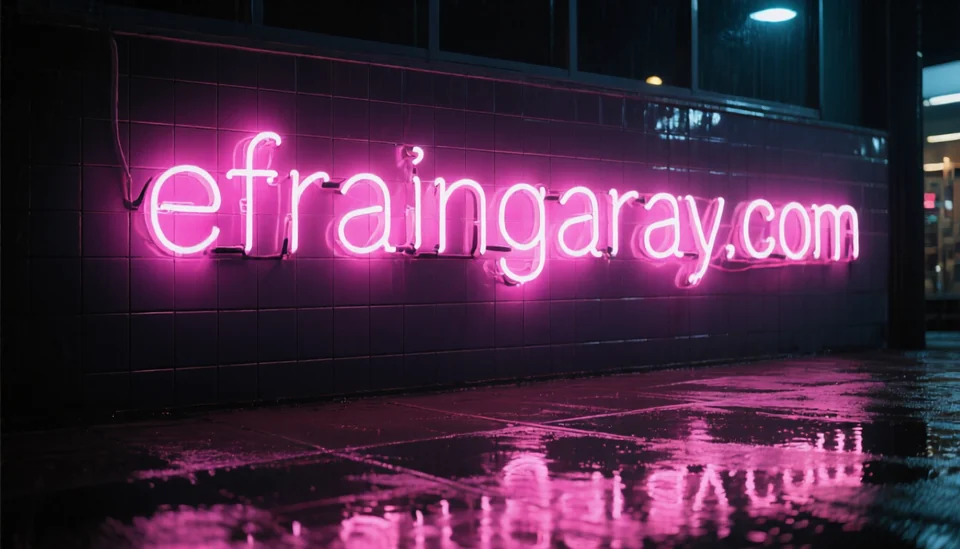
✓ como se pidió
✓ como se pidió
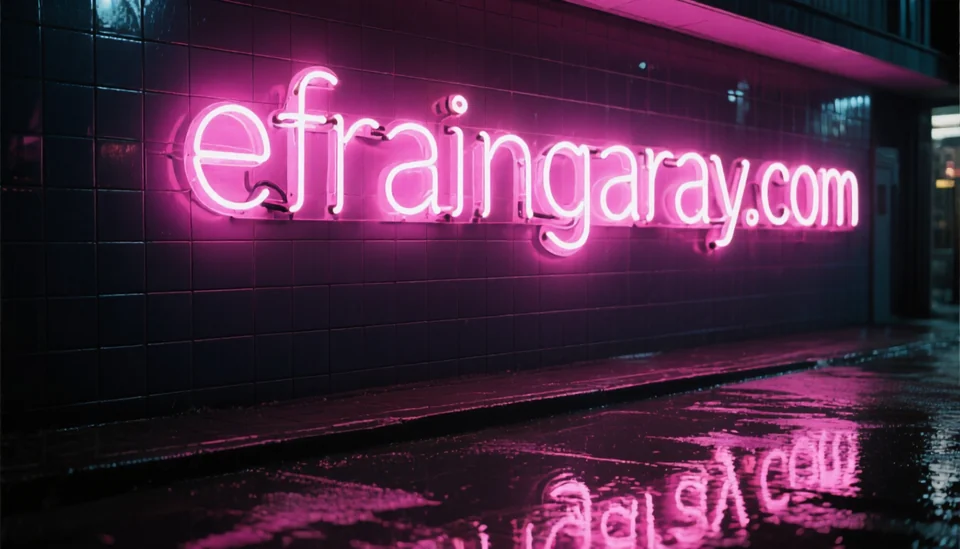
✓ como se pidió
Se pidió Ocho modelos de decisión
Prompt completo
A hardcover book lying on a wooden desk, the cover title printed in large serif letters reads "Ocho modelos de decisión", warm lamp light
✗ modeles deción
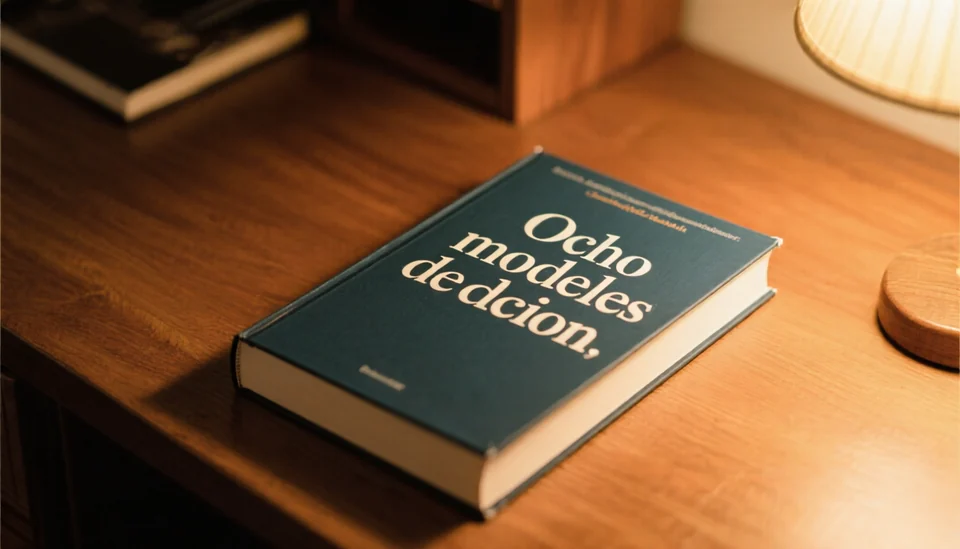
✗ modeles de dción,
✗ modeles de dcion
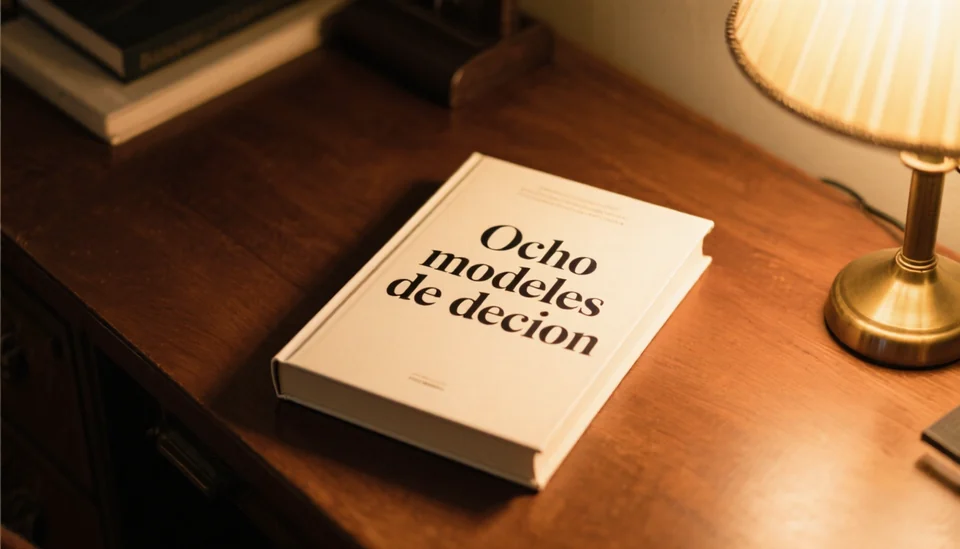
✗ modeles de decion
✗ modeles de deción
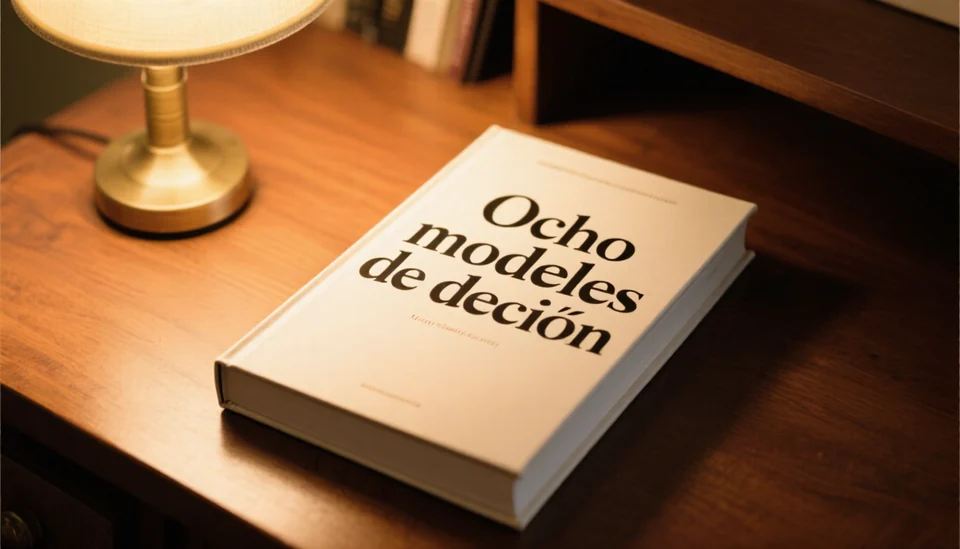
✗ modeles de deción
Se pidió AUC 0,966
Prompt completo
A glass jar on a kitchen shelf with a white paper label printed in black capitals "AUC 0,966", shallow depth of field
✓ como se pidió
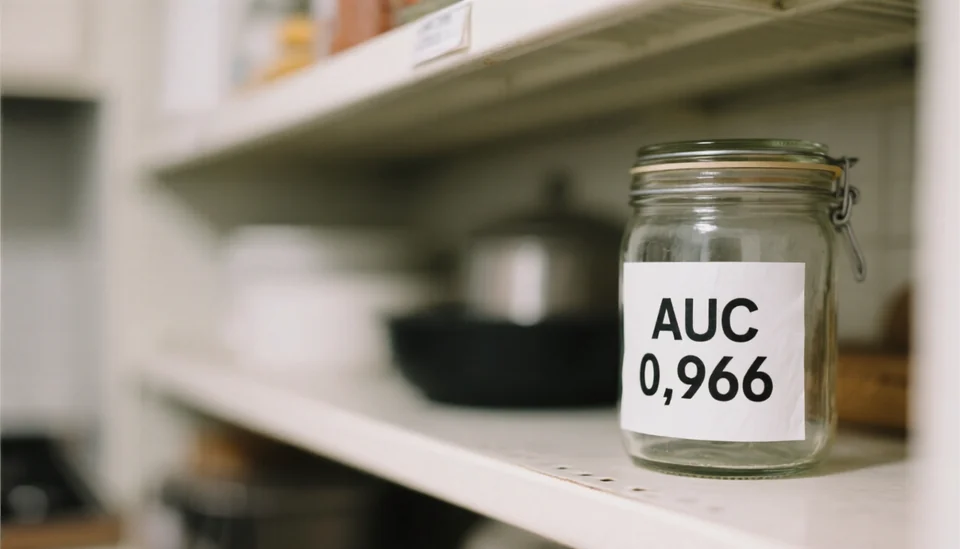
✓ como se pidió
✗ AUC 0,965
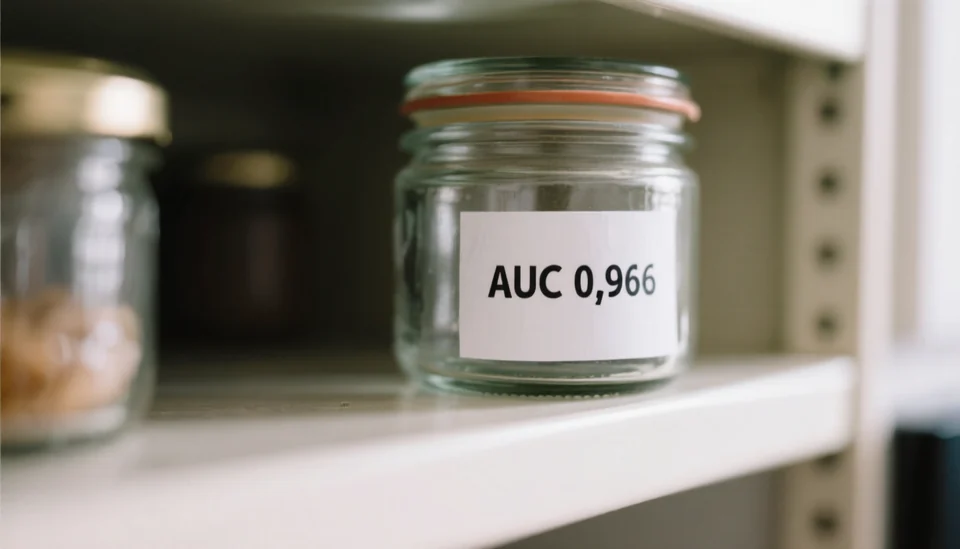
✓ como se pidió
✓ como se pidió
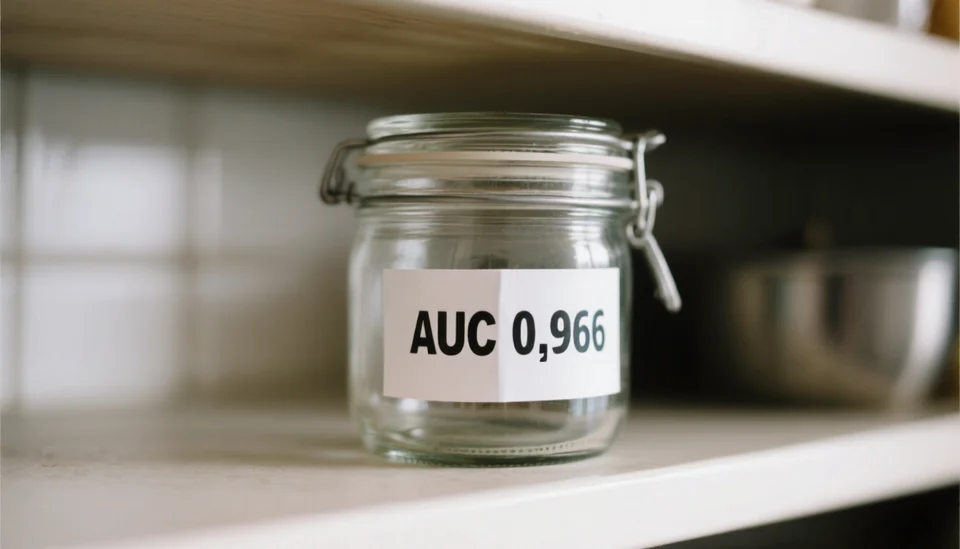
✓ como se pidió
Se pidió PostgreSQL 19
Prompt completo
A yellow road sign on a mountain road at dusk, black letters reading "PostgreSQL 19", pine trees behind
✗ Posteghol
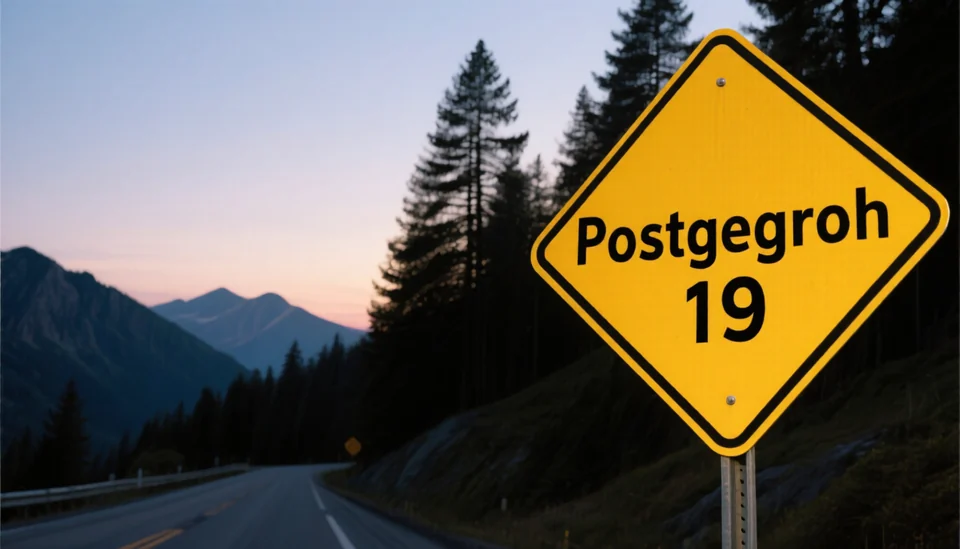
✗ Postgegroh
✗ PostgGcoll
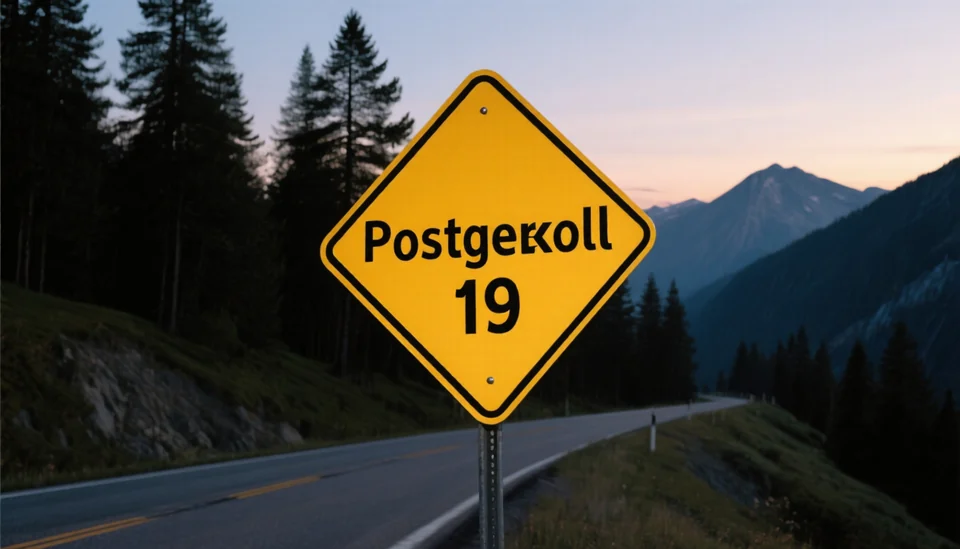
✗ Postgekoll
✗ Postgeshool
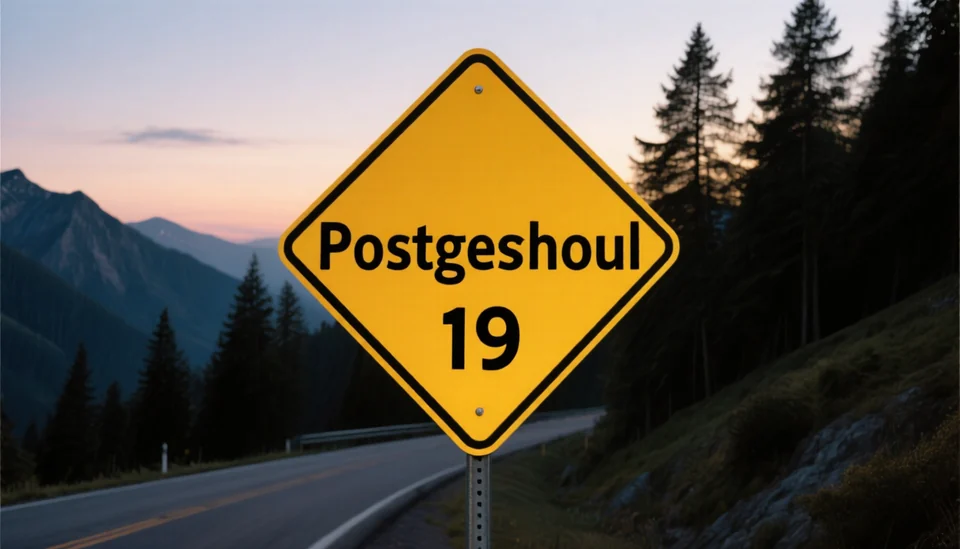
✗ Postgeshoul
Amenazas a la validez
- Las tres enmiendas son exploratorias: las decidí después de ver el grano. La segunda y la tercera se registraron antes de correrlas, con su regla escrita. Muestran qué cambio quita el grano en este banco, con un modelo, una métrica y 21 imágenes.
- La copia NF4 de bitsandbytes cuantiza 846 matrices y la de NVIDIA, 784. Seis de las que solo cuantiza NF4 quedan fuera de los bloques (entre ellas el embebido del paso de difusión, con curtosis 4.243), y siguen en NF4 en todas mis variantes: no son las que causan el grano, pero no medí si afectan otra cosa.
- La revisión del texto la hice yo solo, a ojo. Las 54 imágenes de la galería y la planilla de las 72 están publicadas.
- La métrica de ruido es mía. La valido contra lo que se ve en los recortes a 1:1, pero confunde texto denso con grano, como en la imagen china.
- Mis portadas usan Qwen-Image 2.1-Turbo con 8 pasos. No medí si su versión NF4 tiene el mismo grano.
- La velocidad de NVFP4 aquí no dice nada de Blackwell, que lo corre en FP4 nativo.
Veredicto
En una tarjeta Ada de 16 GB, el Qwen-Image NVFP4 de NVIDIA no conviene tal como viene: la ruta oficial no carga, y expandido corre más lento que NF4 sin escribir mejor. Lo útil de su archivo no son los 4 bits, sino una decisión de NVIDIA: qué dejar sin cuantizar. Si uso NF4 y dejo en bf16 las mismas 8 matrices que NVIDIA dejó afuera, la imagen queda tan limpia como NVFP4, a menos de medio segundo más por imagen y con 0,6 GiB más. Mi hipótesis inicial, la de las capas con peor error, estaba equivocada, y sin la auditoría la habría publicado. Lo próximo es medir si el 2.1-Turbo de mis portadas tiene el mismo grano y, si lo tiene, aplicar ahí la misma receta.
Preguntas frecuentes
¿Qwen-Image NVFP4 funciona en una GPU que no es Blackwell?
La ruta oficial no. La ficha de NVIDIA declara compatibilidad solo con Blackwell GB300 y TensorRT-LLM VisualGen 1.3.0rc28. En una RTX 4070 Ti SUPER (Ada, sm_89, 15,57 GiB) el servidor oficial se quedó sin memoria al cargar el pipeline dos veces, también con offload a CPU: el codificador de texto en bf16 pesa por sí solo 15,4 GiB. Los pesos sí se pueden usar: los expandí a bf16 en cada pasada dentro de diffusers y la imagen sale bien.
¿Qué tan rápido corre NVFP4 en una tarjeta sin tensor cores FP4?
Más lento que NF4. A 1344×768 con 50 pasos, NVFP4 expandido tardó 145,4 s por imagen y 13,1 GiB de pico; NF4 de bitsandbytes, 102,2 s y 11,1 GiB (mediana de 18 imágenes cada uno). Sin FP4 en el hardware, NVFP4 es solo un formato de almacenamiento y hay que pagar la expansión en cada pasada.
¿NVFP4 es más preciso que NF4?
En la mediana, no: sobre las 784 matrices que NVIDIA cuantizó, el error relativo mediano es 9,47 % en NVFP4 y 9,33 % en NF4, y NVFP4 queda más cerca del original solo en 254. La diferencia está en el peor caso: NVFP4 nunca pasa de 9,59 % y NF4 llega a 12,89 %, y esos peores casos son las capas de modulación.
¿De dónde sale el grano de las imágenes NF4?
De 8 matrices: las capas de modulación (img_mod.1 y txt_mod.1) de los bloques 0, 1, 58 y 59, que NVIDIA dejó sin cuantizar y bitsandbytes sí cuantiza. Con solo esas 8 en bf16, el ruido en zonas planas bajó respecto de NF4 en 19 de 21 imágenes. Con las otras 112 capas de modulación en NVFP4, donde NF4 tiene su peor error, bajó en 7. Son pruebas exploratorias, decididas después de ver el grano.
¿Cuál conviene usar en una tarjeta de 16 GB?
En mis pruebas, NF4 con esas 8 matrices en bf16: 102,6 s por imagen y 11,7 GiB de pico, contra 102,2 s y 11,1 GiB de NF4, y sin su grano. NVFP4 expandido no aporta nada en Ada frente a eso y es más lento. En texto, ninguna variante se separó de las otras: entre 5 y 7 de 18.
¿Puedo reproducirlo?
Sí. El expansor de NVFP4, el script de generación, el cálculo de errores, de colas y de ruido, la revisión imagen por imagen y los tiempos están en un gist enlazado en las fuentes.
Fuentes
- Qwen-Image-NVFP4, la ficha de NVIDIA, con el hardware soportado, las 784 matrices y la receta de TensorRT-LLM.
- Introducing NVFP4, el anuncio técnico de NVIDIA, y la especificación OCP Microscaling, que define E2M1.
- QLoRA, el paper que define NF4 para pesos con distribución normal.
- El informe técnico de Qwen-Image y DiT, de donde viene la modulación adaLN.
- TensorRT-LLM, el motor de la ruta oficial.
- El expansor, los scripts, la revisión imagen por imagen, los errores, las colas, el ruido, los tiempos y las versiones.
Medido el 15 de octubre de 2026 en una RTX 4070 Ti SUPER de 16 GB (driver 595.71.05). Qwen/Qwen-Image revisión 75e0b4be y nvidia/Qwen-Image-NVFP4 (ModelOpt 0.47.0); torch 2.14.1+cu130, diffusers 0.41.0.dev0, transformers 5.19.0, bitsandbytes 0.50.2; TensorRT-LLM 1.3.0rc28 para la ruta oficial. 1344×768, 50 pasos, CFG 4, semillas 7, 21 y 88.
BOLETÍN · MEDIDO
Una medición nueva, cuando la hay.
Cada post con sus números, sus fallos y los scripts para repetirlo. Entre uno y tres correos al mes. Te das de baja con un clic.
LO ÚLTIMO QUE LLEGÓ
- NVFP4 vs FP8 vs GGUF en 16 GB2,3× más rápido
- Qwen-Image NVFP4 en Ada19/21 con menos grano
- Kandinsky 6 en 16 GBWER 0,15 en español
Uso Listmonk en mi propio servidor; tu correo no sale de ahí. Confirmas por correo antes de recibir nada.
Comentarios
Todavía no hay comentarios. El primero es tuyo.