
Por qué migré todo mi laboratorio a NixOS: cuatro máquinas, un repositorio y lo que costó
Tenía cuatro máquinas con cuatro sistemas operativos distintos, servicios corriendo en tmux, contraseñas dentro de los units y varias sesiones de agentes tocando todo a la vez. En nueve días las pasé a NixOS con un solo flake. Medí lo que da: un despliegue tarda entre 11 y 17 segundos, el mismo commit produce el mismo hash de sistema en dos máquinas distintas y volver a la versión anterior toma 1,6 segundos. Y medí lo que costó: 35 de 111 commits son arreglos, se perdieron todos los entornos de Python y el DNS del router reapuntó 1.185 archivos solo.
Hasta el 6 de octubre tenía cuatro máquinas en la casa y cuatro sistemas operativos: un portátil con Windows 11, un servidor con Kali, una torre con Fedora 43 y otro portátil con Ubuntu. Cada una se había armado a mano, en momentos distintos. El stream corría en cuatro sesiones de tmux, una contraseña de base de datos vivía dentro de un archivo de servicio de systemd, ComfyUI usaba el python del sistema con paquetes instalados a mano, y para reiniciar el servidor había que estar frente al teclado para desbloquear el disco.
Eso se aguanta mientras una sola persona toca las máquinas. Dejó de aguantarse cuando empecé a trabajar con varias sesiones de agentes en paralelo: una armando reels, otra corriendo modelos, otra con los benchmarks del blog. Cada una instalaba lo que le hacía falta donde le hacía falta. Al tiempo, nadie, ni yo, sabía con certeza qué había en cada máquina ni por qué.
Así que entre el 6 y el 14 de octubre pasé todo a NixOS. Hoy las cuatro máquinas salen del mismo repositorio. Este post cuenta por qué, cómo, qué medí y lo que costó, que no fue poco.
■ declarado en el flake ·■ fuera de él ·■ caído · última línea de cada tarjeta: generación, closure del sistema, servicios corriendo
Qué cambia con NixOS
En una distribución normal, el sistema es el resultado de todo lo que se le hizo: cada apt install, cada archivo editado en /etc, cada servicio levantado a mano. Si quiero saber cómo está una máquina, tengo que mirarla.
En NixOS es al revés. El sistema completo se describe en archivos: qué paquetes hay, qué servicios corren y con qué opciones, qué usuarios existen, cómo se particiona el disco. nixos-rebuild switch construye ese sistema y lo activa. Si algo no está escrito, no existe, y lo que instalé a mano en el sistema desaparece en el próximo cambio.
Un flake es la forma de fijar todo eso en un repositorio: la versión exacta de los paquetes (en mi caso, un nixpkgs fijado a 26.05.11275), los módulos propios y la configuración de cada máquina. El mío se llama nix-zerg y tiene 2.447 líneas de Nix en 23 módulos.
Para el trabajo con agentes, esto cambia la regla del juego. Ninguna sesión instala nada a mano. Cuando una necesita algo en una máquina, lo agrega al flake, hace commit y despliega. Si se equivoca, el error queda en el historial de git, con su diff, y se puede revertir.
- Sistema operativo4 distintos: Windows 11, Kali, Fedora 43 y UbuntuNixOS 26.05 en los 4, el mismo nixpkgs fijado
- Serviciosel stream en 4 sesiones de tmux; una pre-copia murió cuando logind cerró la sesiónunidades de systemd declaradas, con reinicio automático
- Secretoscontraseñas dentro de los units y 10 secretos en texto plano en un disco10 secretos cifrados con agenix a la llave de cada máquina
- PythonComfyUI con el python del sistema y pip globalun entorno por aplicación con su lock exacto en el repo
- Reiniciarvworker pedía desbloquear el disco a mano en la consolaarranca solo; si algo falla, se elige la generación anterior
- Saber qué correinventarios a mano antes de tocar nadael commit desplegado está en cada máquina y el panel avisa si alguna difiere
Cómo fue la migración
■ feat 52■ fix 35■ docs 14■ refactor 5■ chore 4■ perf 1
El primero fue lenovo, el 6 de octubre: Windows fuera y NixOS instalado por canal, a la antigua. Al día siguiente lo importé al flake, y el sistema construido desde el repositorio salió idéntico al que ya estaba corriendo.
vworker, el servidor con Kali, fue distinto. En vez de un pendrive usé nixos-anywhere: arranca un instalador por kexec sobre el sistema en marcha, particiona el disco con disko e instala. Tomó 7 minutos, de las 20:44 a las 20:51 del 7 de octubre. Antes había copiado lo que importaba al lenovo, y la máquina volvió con la misma llave SSH y la misma dirección en la red interna, así que los secretos cifrados funcionaron al primer arranque.
fedora era la máquina con más cosas: la GPU principal, los modelos, un ambiente de pruebas de un cliente y 38 entornos de Python. La borré entera el 12 de octubre. Antes de tocar el disco verifiqué el respaldo contra el original: 1.407.986 archivos sin una diferencia. El núcleo estuvo abajo 5 horas y 50 minutos, dentro de lo que había estimado.
huawei, el último, entró el 14 de octubre con un instalador propio que se conecta por Wi-Fi. Las dos primeras veces se colgó y hubo que apagarlo y prenderlo a mano.
Desplegar es un commit
El despliegue lo hace un script corto, nz-deploy. Se niega a correr si hay cambios sin commit o si el commit no está en GitHub, así que todo lo que corre en una máquina existe en el repositorio. Después manda el código por ssh, anota qué commit es y corre nixos-rebuild switch.
- 1¿árbol limpio y con push?
- 2git archive HEAD
- 3ssh a la máquina
- 4escribe REVISION
- 5nixos-rebuild switch
- 6¿unidades caídas?
■ mediana · ● cada corrida · | solo abrir ssh
Con el commit ya desplegado, cada despliegue tomó entre 10,4 y 28,1 segundos. Las medianas de cinco corridas fueron 11,2 segundos en fedora, 14,2 en lenovo y 17,3 en vworker. La primera ronda fue la más lenta en las tres máquinas, y desde la tercera los tiempos quedaron parejos. Abrir la conexión ssh sola tiene una mediana por debajo de medio segundo; descontándola, las medianas quedan en 10,9, 13,8 y 17,0 segundos. No separé cuánto de eso es evaluar la configuración y cuánto es activar el sistema.
Una aclaración honesta: el flake declara deploy-rs, que tiene un rollback mágico: si después de un cambio la máquina deja de responder por SSH, vuelve sola a la versión anterior. Pero nz-deploy no lo usa: llama a nixos-rebuild switch directo. Hoy, si un cambio rompe la red de una máquina, la vuelta atrás es a mano.
El mismo commit, el mismo sistema
La promesa de NixOS es que la misma configuración produce el mismo sistema. Lo probé evaluando el mismo commit en dos máquinas distintas, vworker y fedora, y comparando el hash del sistema completo de cada uno de los cuatro hosts.
5z6dgqgzi96z…5z6dgqgzi96z…6kx7a4s4m852…6kx7a4s4m852…r225ybk6xsmd…r225ybk6xsmd…8mx43jjd6h8j…8mx43jjd6h8j…Los cuatro hashes salieron iguales en las dos máquinas, carácter por carácter. Es el hash del sistema evaluado, el que Nix va a construir; no reconstruí los sistemas para comparar los binarios bit a bit. Para saber que el hash de verdad depende de la configuración hice dos controles. Agregar un comentario a un módulo no cambió nada, porque los comentarios no forman parte de lo que se construye. Agregar una línea con efecto en el archivo de vworker cambió el hash de vworker y el de nadie más.
La prueba que más me importaba es la última fila: el hash de lo que está corriendo ahora en cada máquina es el mismo que sale de evaluar el commit desde git. En el primer intento no coincidió, y me asusté hasta entender por qué: el despliegue escribe el número de commit dentro del sistema, para que el panel pueda mostrarlo. Evaluando con ese mismo dato, los tres coinciden.
Volver atrás en 1,6 segundos
Cada nixos-rebuild switch deja una generación numerada, y las anteriores no se borran: siguen en el disco y en el menú de arranque. vworker va en la 31, y no se ha reiniciado ni una vez en los 7 días desde que lo instalé.
■ generación actual · ■ anteriores, aún arrancables · 3 de 3 idas y vueltas, 0 unidades caídas
Medí la vuelta atrás en lenovo, la máquina con menos en juego: pasar el sistema en marcha a la generación anterior y volver a la actual, tres veces. La ida tomó 1,59 segundos de mediana y la vuelta 1,60. En las tres, todo quedó como estaba y ninguna unidad terminó caída. Ese es el seguro que no tenía con Kali ni con Fedora: si un cambio sale mal, la versión anterior está a un comando.
↶ 1,59 s · ↷ 1,60 s · 3/3 vueltas, 0 unidades caídas
Lo que costó
Esta parte me importa más que las anteriores, porque la mayoría de los textos sobre NixOS la omiten.
de los commits son arreglos
- ●●● datos o resultados en riesgoEl DNS del router entrega respuestas malformadas: rclone vio el Drive vacío y 1.185 enlaces se reapuntaron solos
- ●●● datos o resultados en riesgoLos entornos de Python no viajan: 38 en fedora y unos 65 GB en vworker, a reconstruir
- ●●○ horas perdidasUnos 450 GB de modelos de GPU a volver a bajar en fedora
- ●●○ horas perdidas/mnt/ai-fast pasó a /data sin enlace de compatibilidad: unos 379 archivos con la ruta vieja solo en el Mac
- ●●○ horas perdidasEl pronóstico del sitio repitió el análisis del 12 en las corridas del 13 y del 14, sin un solo error
- ●●○ horas perdidaslenovo se cortó en seco 18 h 52 min, sin secuencia de apagado
- ●●○ horas perdidashuawei dejó de responder en un barrido de potencia y hay que revisarlo a mano
- ●○○ roceNo existe /bin/bash ni python en el PATH
35 de los 111 commits del flake son arreglos, y 12 de ellos son del primer día. Cada uno es algo que no funcionó como esperaba.
El peor incidente no fue de NixOS sino del router. Su DNS entrega respuestas malformadas, y el resolver de rclone las interpretó como un Drive vacío. Un proceso nocturno, que reapunta los archivos de la biblioteca cuando una copia desaparece, reapuntó 1.185 de golpe. Hubo que revertirlo y fijar un DNS público en todas las máquinas.
Lo que no estaba declarado se perdió, y eso es lo que más trabajo dio. Los entornos de Python no se copian: 38 en fedora y unos 65 GB en vworker hubo que reconstruirlos desde listas de paquetes. Unos 450 GB de modelos hubo que volver a bajar. La carpeta de datos de fedora cambió de ruta, de /mnt/ai-fast a /data, y solo en mi Mac quedaron unos 379 archivos apuntando a la ruta vieja.
Un caso lo descubrí mientras escribía este post. El pronóstico del clima que publica el sitio repitió el análisis del 12 de octubre en las corridas del 13 y del 14, sin un solo error. El entorno de Python del modelo no existía y el script fallaba. Pero el paso siguiente leía el último pronóstico que había en el disco, que era el viejo. Lo reconstruí, y ahora un fallo de ese paso es un error visible.
Y lo cotidiano: en NixOS no existe /bin/bash y python no está en el PATH si no se declara. Los scripts con #!/bin/bash dejaron de correr hasta cambiarlos a #!/usr/bin/env bash.
Hubo dos caídas cuya causa no confirmé. lenovo se cortó en seco el 13 de octubre a las 23:23 y no volvió hasta las 18:16 del día siguiente: 18 horas y 52 minutos sin un solo registro, y el último mensaje del sistema es un cierre de sesión normal, sin secuencia de apagado. Y huawei dejó de responder hoy durante una prueba de potencia, y hay que ir a revisarlo a mano.
La app que ve todo
Con cuatro máquinas declaradas faltaba poder ver qué está pasando sin entrar a cada una. Así que el flake tiene un módulo propio, zerg-status: un recolector en Python, sin dependencias, que corre en cada máquina y sirve un panel pensado para la tablet. Muestra carga, memoria, discos, GPU, qué proceso usa la GPU y de qué servicio es, los candados de GPU, cada servicio y cada contenedor, y qué commit está desplegado. Si una máquina corre otro commit, o cambió el kernel y necesita reiniciar, el panel lo marca.
Como el módulo está en el flake, agregar una máquina al panel es una línea. El VPS, que todavía no es NixOS, corre el mismo recolector a mano y escuchando solo en la red interna.
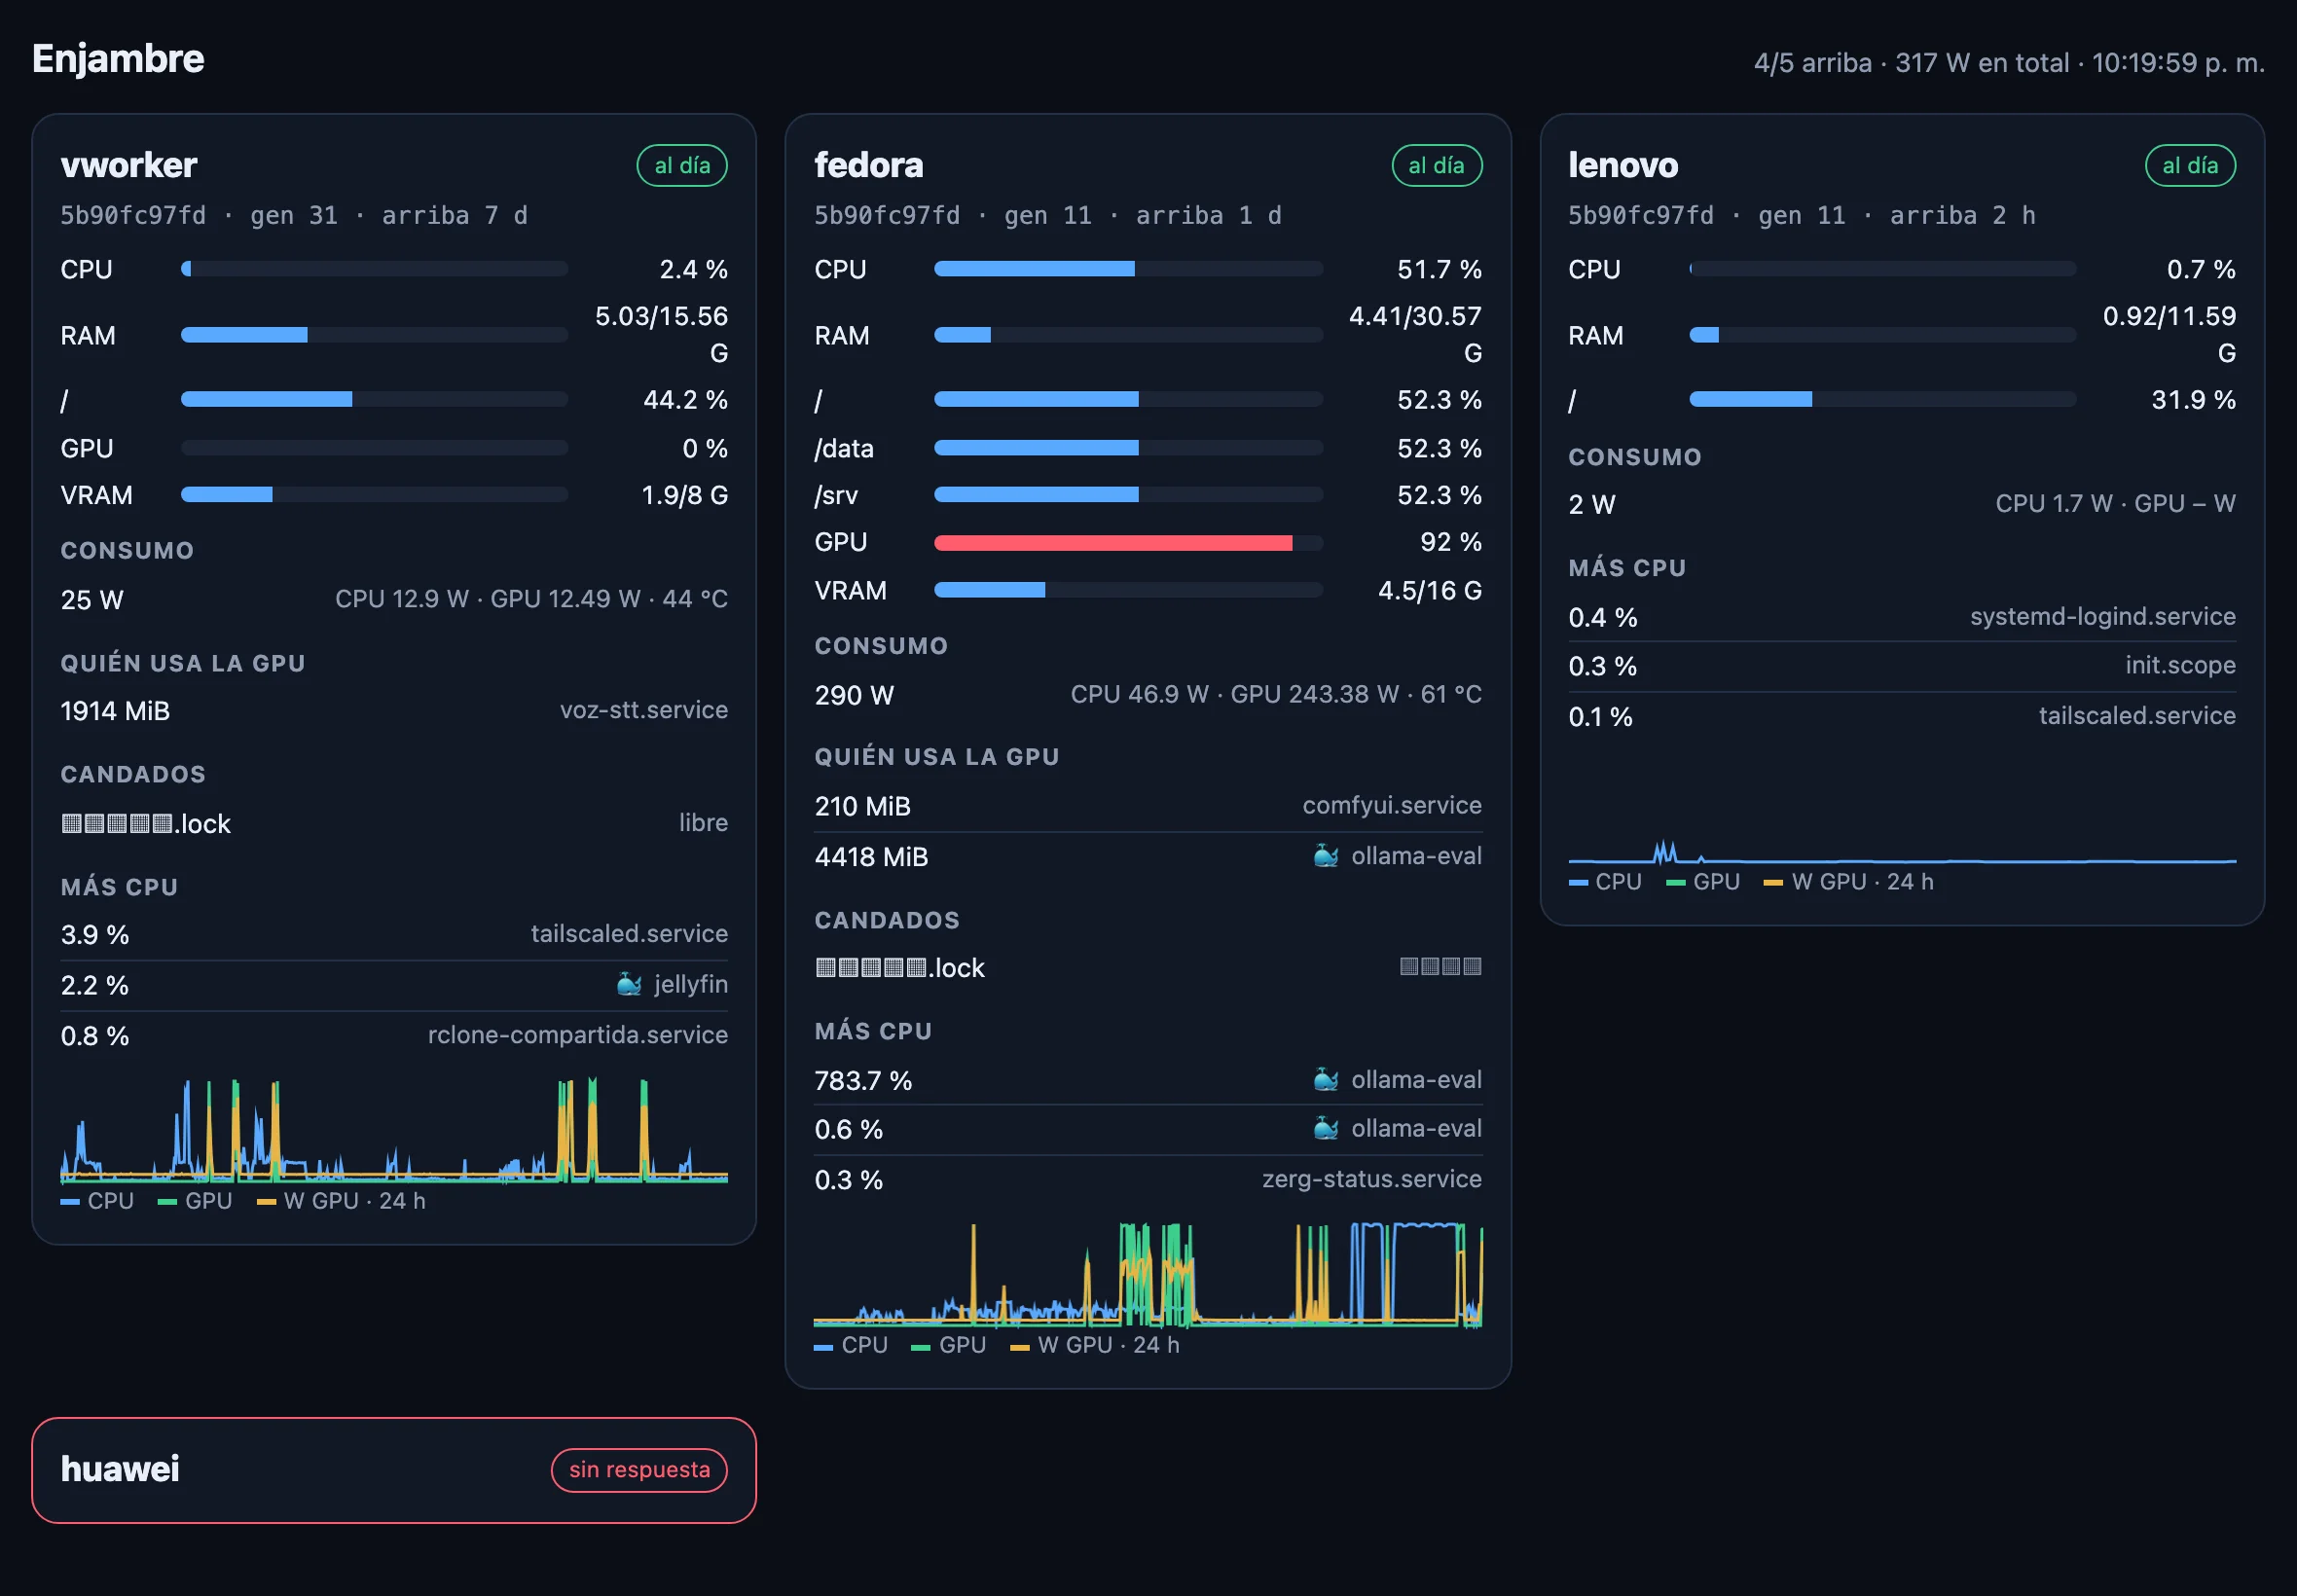
El panel real. Oculté las listas de servicios y contenedores, los nombres de los candados, las sesiones y la tarjeta del VPS, porque nombran proyectos de clientes y de terceros.
El panel también guarda el consumo de cada máquina, y de ahí sale este gráfico:
fedora, con la RTX 4070 Ti SUPER, tiene una mediana de 52,6 W y un percentil 95 de 219,4 W cuando la GPU trabaja; el máximo fue 321,6 W. vworker queda en 25,6 W y lenovo en 1,4 W. Son ventanas de pocas horas, las que el panel tenía guardadas al momento de la medición, no un día completo.
Cuándo lo recomendaría y cuándo no
Lo recomendaría si tienes más de una máquina, si varias personas o agentes tocan los mismos sistemas, o si ya te pasó no saber qué se instaló dónde. La combinación de saber qué commit corre en cada máquina, poder volver atrás en segundos y que todo cambio quede en git es lo que, en mi experiencia de esta semana, hizo el enjambre más fácil de mantener. No lo medí: es mi juicio, no un número.
No lo recomendaría si tienes una sola máquina que ya funciona y no piensas tocarla, o si dependes de software que necesita rutas fijas tipo /usr/lib y no tienes tiempo de pelear con eso. nix-ld resuelve buena parte, pero no todo. Tampoco esperes que la migración sea limpia: un tercio de mis commits fueron arreglos.
Lo que esta medición no cubre
- No hay un «antes» medido. Las máquinas viejas nunca tuvieron métricas, así que no puedo decir cuánto más rápido o más estable es esto; solo lo que mide hoy.
- Un solo enjambre, cuatro máquinas distintas entre sí. Nada de esto se generaliza a otras instalaciones.
- huawei estaba apagado durante las mediciones y no entra en los tiempos ni en el consumo.
- Los tiempos de despliegue dependen de la red y de la carga de cada máquina en ese momento.
- El consumo cubre unas pocas horas por máquina (menos de una en lenovo), no un día completo.
Medido el 14 de octubre de 2026 en cuatro máquinas con NixOS 26.05 (nixpkgs 26.05.11275), flake nix-zerg en el commit 5b90fc9: vworker (i5-9400F, RTX 2060 SUPER), fedora (Ryzen 7 7800X3D, RTX 4070 Ti SUPER), lenovo (i5-8250U) y huawei (Ryzen 5 3500U, apagado durante las mediciones).
Fuentes
- Manual de NixOS: volver atrás un cambio de configuración. Cómo funcionan las generaciones y el rollback.
- Manual de Nix: flakes. Qué es un flake y cómo fija sus entradas.
- nixos-anywhere. Instalar NixOS por SSH sobre una máquina con otro sistema.
- disko. Particionado declarativo.
- agenix. Secretos cifrados con la llave SSH de cada máquina.
- nix-ld. Correr binarios que esperan rutas de una distribución normal.
- deploy-rs. Despliegue con rollback automático (declarado en el flake, no usado por
nz-deploy). - Mis scripts, la ficha y los datos crudos. Las mediciones de despliegue, evaluación, rollback y consumo, con la ficha escrita antes de medir.
- NVIDIA Container Toolkit: CDI. Cómo se le pasa la GPU a Docker.
Preguntas frecuentes
¿Por qué NixOS y no Ansible o Docker sobre Ubuntu?
Porque en NixOS el sistema entero sale de la configuración: paquetes, servicios, usuarios, discos y secretos. Con Ansible sobre Ubuntu el estado real puede alejarse de lo escrito apenas alguien instala algo a mano, y Docker resuelve las aplicaciones pero no el sistema que las corre. En mi caso, con varias sesiones de agentes trabajando sobre las mismas máquinas, necesitaba que lo único válido fuera lo que está en el repositorio.
¿Cuánto tarda un despliegue?
Con el commit ya desplegado, la mediana de cinco corridas fue 11,2 segundos en fedora, 14,2 en lenovo y 17,3 en vworker, de punta a punta: revisar que el árbol esté limpio, mandar el código por ssh, nixos-rebuild switch y buscar unidades caídas. La primera ronda fue más lenta, entre 17,7 y 28,1 segundos.
¿Qué tan rápido se vuelve atrás si algo sale mal?
En lenovo, pasar el sistema en marcha a la generación anterior tomó 1,59 segundos de mediana, y volver a la actual otros 1,60, en tres idas y vueltas sin ninguna unidad caída. Si la máquina no arranca, el menú de arranque guarda hasta diez generaciones.
¿Qué se pierde al migrar?
Todo lo que no estaba declarado. En mi caso, los entornos de Python (38 en fedora y unos 65 GB en vworker), unos 450 GB de modelos que hubo que volver a bajar, rutas que cambiaron y servicios viejos que decidí no portar. Además, /bin/bash no existe y python no está en el PATH, así que hubo que corregir varios scripts.
¿Sirve para alguien con una sola máquina?
Sí, pero la ganancia es menor. Lo que más pesó en mi caso fue tener cuatro máquinas descritas en un solo lugar, saber qué commit corre en cada una y que una sesión de agente pueda integrar algo nuevo con un commit y un despliegue. Con una sola máquina queda el rollback y la configuración reproducible, que ya es bastante.
¿Cómo se monitorea todo?
Con un módulo propio del flake que corre en cada máquina y sirve un panel para la tablet: carga, memoria, GPU, quién usa la GPU, consumo en watts, servicios, contenedores y qué commit está desplegado. Si una máquina corre otro commit o necesita reiniciar, el panel lo marca.
BOLETÍN · MEDIDO
Una medición nueva, cuando la hay.
Cada post con sus números, sus fallos y los scripts para repetirlo. Entre uno y tres correos al mes. Te das de baja con un clic.
LO ÚLTIMO QUE LLEGÓ
- NVFP4 vs FP8 vs GGUF en 16 GB2,3× más rápido
- Qwen-Image NVFP4 en Ada19/21 con menos grano
- Kandinsky 6 en 16 GBWER 0,15 en español
Uso Listmonk en mi propio servidor; tu correo no sale de ahí. Confirmas por correo antes de recibir nada.
Comentarios
Todavía no hay comentarios. El primero es tuyo.